Ringkasan
Pengumpulan data AI adalah proses mengumpulkan dan mempersiapkan data untuk model machine learning.
Data berasal dari enam metode utama: web scraping, API, data pengguna first-party, sensor, dataset yang ada, dan data sintetis.
Data mentah tidak dapat digunakan sampai dibersihkan, dideduplikasi, dan sering kali diberi label.
Data publik biasanya boleh digunakan. Data pribadi dan data di balik login memiliki batasan hukum.
Jawaban Singkat: Pengumpulan data AI adalah proses mengumpulkan teks mentah, gambar, audio, video, atau rekaman dan mempersiapkannya untuk melatih, menguji, dan meningkatkan model machine learning. Tim mengumpulkannya melalui web scraping, API, interaksi pengguna, sensor, dataset publik, dan generasi sintetis, kemudian membersihkan dan memberi label sebelum pelatihan.
Apa itu pengumpulan data AI
Ini adalah langkah pertama dalam membangun model machine learning apa pun. Model hanya dapat mempelajari pola dalam contoh-contohnya, jadi data yang Anda kumpulkan menentukan apa yang dapat dilakukannya dan di mana ia gagal.
Yang membedakannya dari pengumpulan data biasa adalah tujuannya. Laporan penjualan membutuhkan catatan yang akurat. Model membutuhkan volume, variasi, dan keseimbangan: ribuan atau jutaan contoh yang mencakup situasi nyata yang akan dihadapinya, tanpa satu sumber menenggelamkan yang lain. Itulah mengapa pengumpulan data dalam machine learning biasanya merupakan proses berkelanjutan daripada ekspor sekali jalan.
Apakah ini sama dengan data pelatihan
Tidak persis. Data pelatihan adalah hasilnya: contoh yang telah dibersihkan dan diberi label yang dipelajari model. Pengumpulan adalah pekerjaan menemukan, mengumpulkan, dan mempersiapkan contoh-contoh tersebut. Sebagian besar tim juga menyimpan data validasi dan data uji terpisah untuk memeriksa model pada contoh yang belum pernah dilihatnya.
Bagaimana AI mengumpulkan data
AI tidak mengumpulkan data sendiri. Orang dan pipeline yang mengumpulkannya, menggunakan enam metode utama.
Metode | Apa yang dikumpulkan | Contoh tipikal |
Web scraping dan crawling | Halaman publik, daftar, ulasan, artikel | Data harga untuk model forecasting |
API | Data terstruktur yang dipilih platform untuk dibagikan | Postingan atau data produk dari API resmi |
Data first-party | Klik, pencarian, pembelian, chat dukungan | Mesin rekomendasi toko sendiri |
Sensor dan perangkat | Frame kamera, GPS, pembacaan wearable dan mesin | Model self-driving dan inspeksi pabrik |
Dataset yang ada | Koleksi terbuka atau berlisensi | Melatih model gambar pada set gambar publik |
Data sintetis | Contoh yang dihasilkan oleh software atau model lain | Kasus fraud langka yang tidak dimiliki data nyata |
Sebagian besar model produksi menggabungkan beberapa metode. Chatbot dukungan pelanggan mungkin mencampur log chat perusahaan sendiri, artikel bantuan publik, dan percakapan sintetis yang mencakup pertanyaan langka.
Dari Mana AI Mendapatkan Datanya
Sumber tunggal terbesar adalah web publik. Common Crawl, sebuah organisasi nirlaba, telah memelihara arsip terbuka dan gratis dari data crawl web sejak 2007, dan para peneliti secara luas menggunakannya dalam riset language model. Selain itu, tim AI juga mengandalkan:
Konten berlisensi: arsip berita, buku, gambar stok, dan kode, yang digunakan berdasarkan perjanjian berbayar
Dataset terbuka: koleksi riset yang dirilis untuk penggunaan publik
Interaksi pengguna: feedback, rating, dan percakapan, di mana ketentuan privasi produk mengizinkannya
Data buatan manusia: para ahli dan anotator yang menulis, memberi peringkat, atau melabeli contoh
Training data untuk generative AI sangat bergantung pada teks, kode, dan gambar dari dua sumber pertama. Model task-specific yang lebih kecil lebih banyak mengandalkan first-party data perusahaan itu sendiri.
Expert Insight: Sebagian besar proyek data tidak terhenti pada kode scraping. Mereka terhenti pada permintaan yang diblokir dan cakupan yang tidak merata. Jika crawler Anda mencapai 70% halaman situs dan diam-diam gagal pada sisanya, model akan mempelajari gambaran yang miring tanpa ada yang menyadarinya.
Jenis Data Apa yang Dikumpulkan AI
Jenis data | Contoh | Apa yang didukungnya |
Terstruktur | Harga, tanggal, transaksi, pembacaan sensor | Model forecasting, pricing, dan fraud |
Tidak terstruktur | Teks bebas, gambar, audio, video | Language model, computer vision, speech recognition |
Semi-terstruktur | JSON, XML, chat log, halaman web | Chatbot, search ranking, recommendation system |
Seperti Apa Pipeline Pengumpulan Data AI
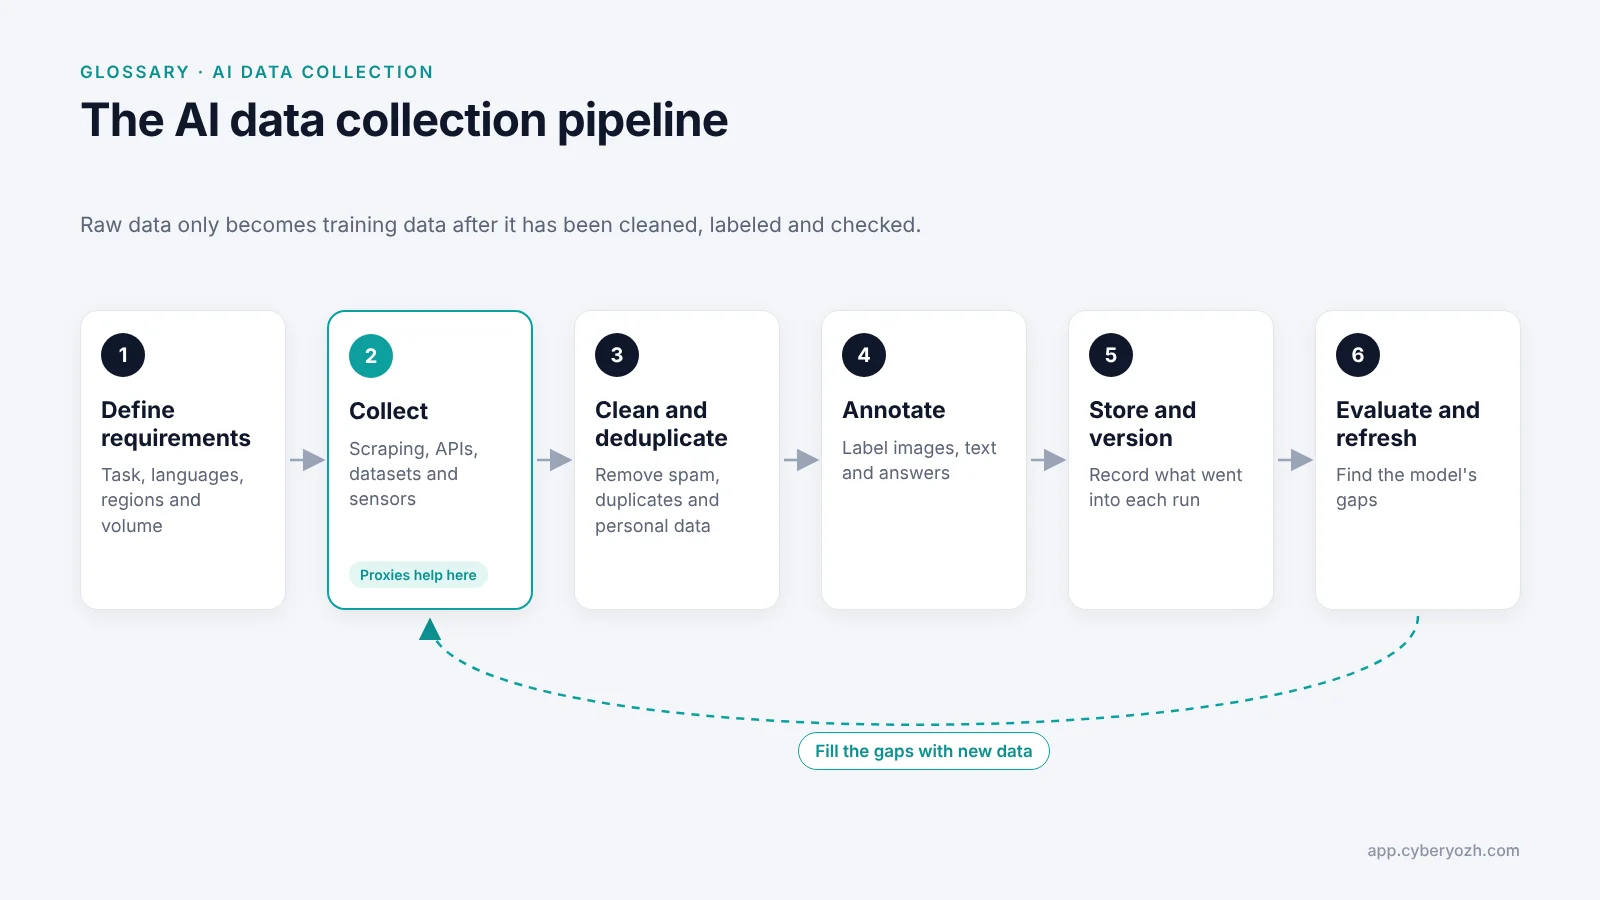
Tentukan persyaratan: apa yang harus dilakukan model, bahasa atau wilayah mana yang dicakupnya, dan berapa banyak data yang dibutuhkan
Kumpulkan: jalankan scraper, API pull, dan unduhan dataset
Bersihkan dan deduplikasi: hapus halaman yang rusak, spam, near-duplicate, dan data pribadi yang tidak boleh disimpan
Anotasi: labeli contoh jika diperlukan, seperti memberi tag pada gambar atau memberi rating pada jawaban
Simpan dan beri versi: simpan catatan tentang apa yang masuk ke setiap training run
Evaluasi dan refresh: periksa model, temukan celahnya, dan kumpulkan data baru untuk mengisinya
Pengumpulan data dan anotasi sering dikacaukan. Pengumpulan mengumpulkan bahan mentah. Anotasi menambahkan label yang memberi tahu model apa arti setiap contoh.
Kesalahan Umum: Mengumpulkan data hanya dari satu lokasi. Harga, hasil pencarian, dan bahkan teks halaman berubah menurut negara. Dataset yang di-scrape sepenuhnya dari alamat IP AS mengajarkan model versi web AS dan menyebutnya sebagai seluruh web.
Apakah pengumpulan data AI legal
Biasanya, ketika tetap pada data publik dan menghormati hukum privasi. Tiga batasan yang paling penting:
Publik vs. privat. Dalam kasus hiQ v. LinkedIn yang berlangsung lama, pengadilan banding AS menemukan bahwa scraping halaman yang dapat diakses publik kemungkinan tidak melanggar Computer Fraud and Abuse Act (ringkasan kasus EFF). Terms of service masih dapat membuat klaim kontrak, yang merupakan bagaimana sengketa tersebut akhirnya berbalik melawan hiQ.
Data pribadi. Nama, foto, dan detail kontak termasuk dalam hukum privasi seperti GDPR di Eropa dan CCPA di California, bahkan ketika mereka terlihat secara publik.
Hak cipta. Beberapa gugatan hukum atas pelatihan model pada karya berhak cipta masih terbuka, jadi sumber berlisensi atau berlisensi terbuka membawa risiko lebih rendah.
Peringatan: Jangan mengumpulkan data dari balik login atau melewati kontrol akses situs. Di situlah sebagian besar risiko hukum berada. Halaman ini adalah informasi umum, bukan nasihat hukum, jadi konsultasikan dengan pengacara sebelum mengumpulkan data pribadi dalam skala besar.
Untuk checklist praktis, lihat panduan kami tentang web scraping etis.
Mengapa pengumpulan data web memerlukan proxy
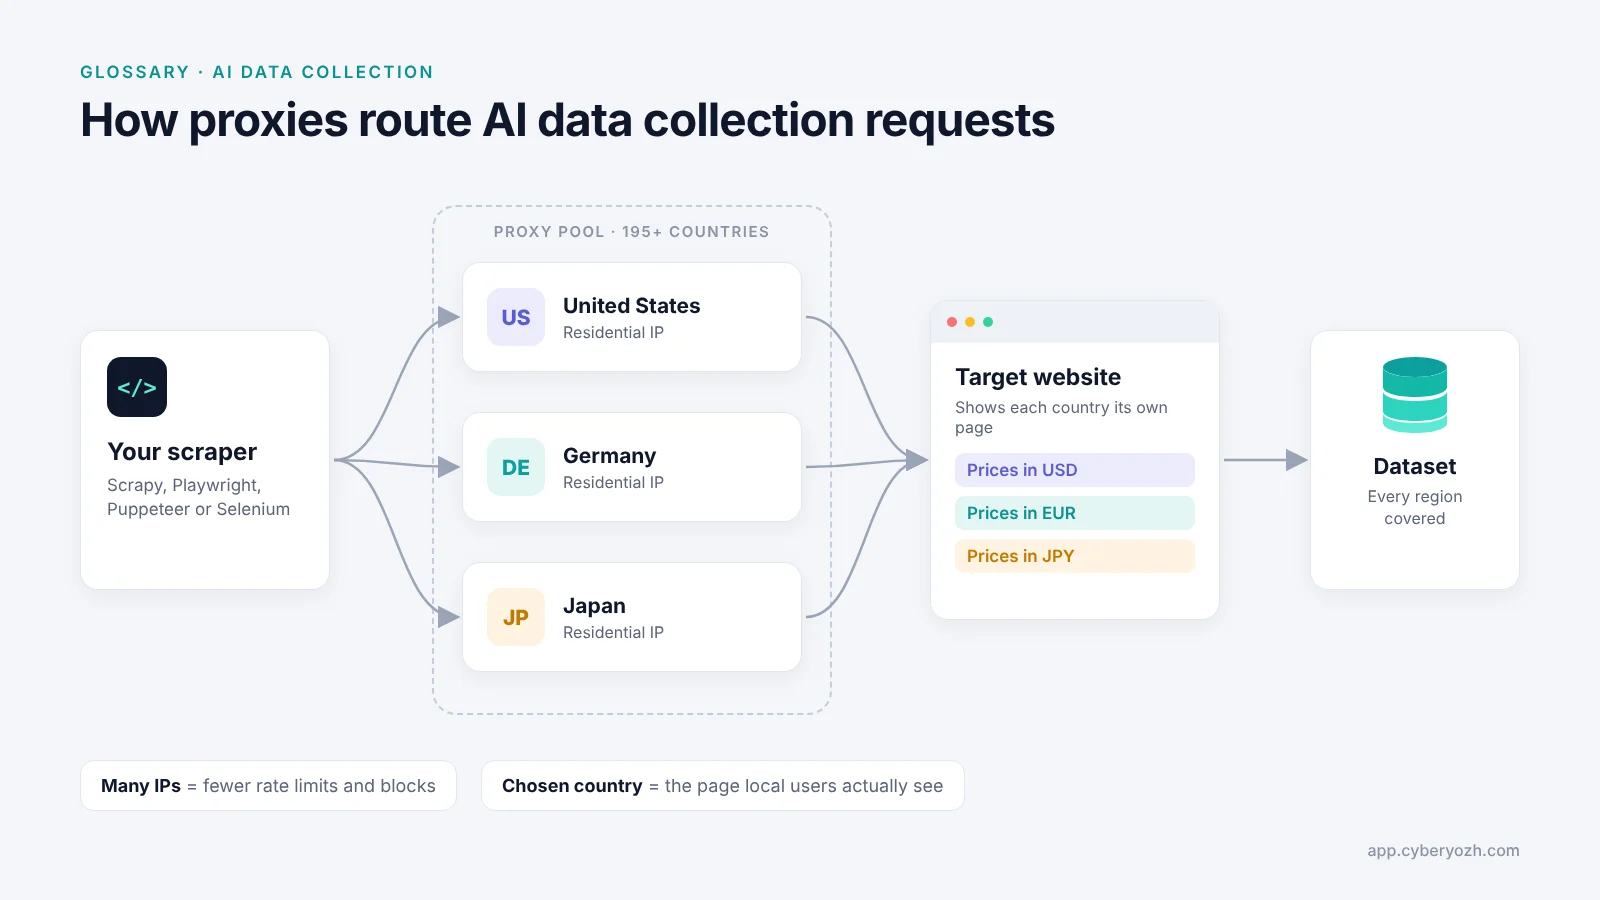
Hanya satu dari enam metode yang memerlukannya: mengumpulkan data web publik dalam skala besar. Jika Anda mengirim ribuan permintaan dari satu alamat IP, situs akan membatasi laju atau memblokir Anda dalam hitungan menit. Anda juga hanya melihat versi setiap halaman yang ditampilkan ke negara Anda sendiri.
Proxy menyebarkan permintaan ke banyak alamat IP dan memungkinkan Anda memilih negara asal setiap permintaan. Berikut cara tipe proxy CyberYozh sesuai dengan pekerjaan pengumpulan data AI yang umum:
Pekerjaan pengumpulan | Tipe proxy terbaik | Harga mulai dari |
Crawling skala besar halaman publik | $2/GB | |
Pengumpulan volume tinggi dari situs yang dilindungi ringan | Datacenter, traffic unlimited | $1,77/bulan (shared) |
Sesi yang harus mempertahankan satu IP, seperti hasil berpaginasi | $5,29/bulan | |
Konten khusus mobile dan situs paling ketat | Lihat katalog |
100M+ IP residential di 195+ negara untuk dataset yang seimbang dan spesifik lokasi
Akses API penuh dengan dukungan untuk Selenium, Playwright, Puppeteer dan Scrapy
HTTP(S) dan SOCKS5 di setiap tipe proxy
Rating 4,7+ Excellent di Trustpilot
Tips Pro: Jalankan sampel IP Anda melalui IP Fraud Score checker gratis CyberYozh sebelum crawl besar. Mengganti alamat yang ditandai terlebih dahulu hanya memakan waktu menit. Men-debug crawl yang setengah terblokir setelahnya memakan waktu berhari-hari.
Membangun pipeline? Lihat proxy untuk pengumpulan data AIkami, atau bandingkan penyedia dalam rangkuman layanan pengumpulan datakami.
Kumpulkan data yang lebih bersih dan seimbang lokasinya. Jelajahi katalog proxy CyberYozh →