真实的移动LTE / 5G网络
通过真实运营商网络运行AI代理,享受无限移动流量和专用通道。
- 真实的LTE / 5G运营商网络
- 手动和API IP轮换
- 高信任环境
- 稳定的AI会话

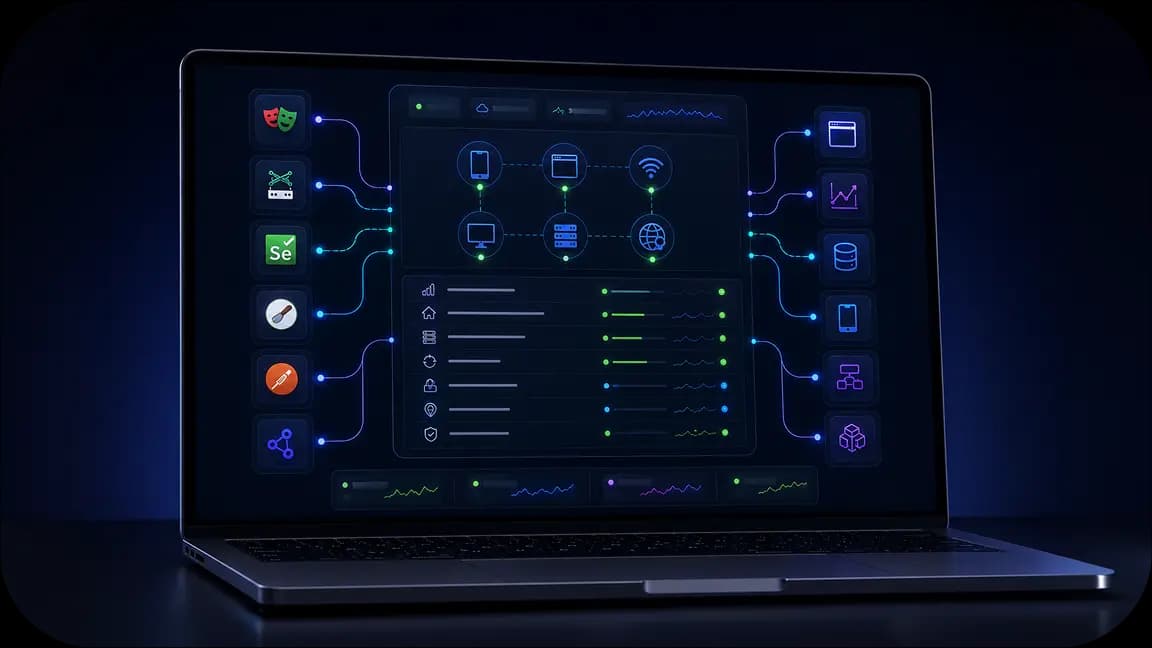
将代理直接连接到您的数据采集堆栈,用于大规模构建训练语料库。API集成支持Playwright、Puppeteer、Selenium、Scrapy和自定义抓取脚本。
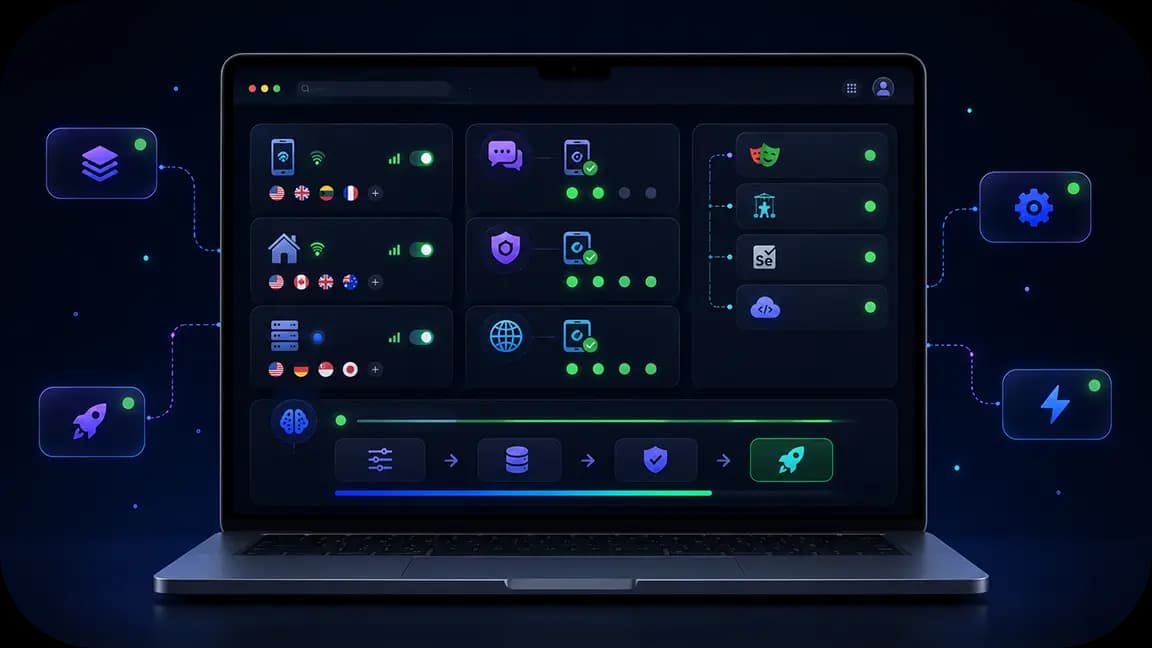
只需几步,即可为 RAG 网页抓取或 AI 数据集采集配置代理。在一个对新手友好的控制面板中管理 IP 轮换和 sticky 会话,并批量生成认证凭据,以适应数据集规模和来源多样性的增长。
使用支持城市级和邮编级精准定位的住宅代理,开展面向 LLM 训练的网页抓取,采集覆盖 195+ 个国家和地区的多语言数据。构建真实反映全球多样性的高质量训练集。
CyberYozh 代理包含操作系统指纹切换选项,可使您的设备配置文件与每个 IP 保持一致。在运行工作流之前检查您的 IP 欺诈评分,以减少验证码和被阻止的请求。
通过真实运营商网络运行AI代理,享受无限移动流量和专用通道。

通过为自动化构建的 CAPTCHA 解决支持和验证工具,减少工作流程中断。

在一个环境中管理代理、短信激活、指纹识别、防欺诈检查和集成。
CyberYozh App 为大规模 AI 训练数据采集提供稳定可靠的代理基础设施。平台整合了 100M+ 住宅 IP、真实的移动 LTE/5G 以及数据中心代理,并提供精细化定位、sticky 会话、操作系统指纹切换、IP 欺诈检测和虚拟号码。无论是收集预训练语料、构建特定领域的微调数据集,还是跨地区采集数据,都能减少验证码和流程中断的情况。
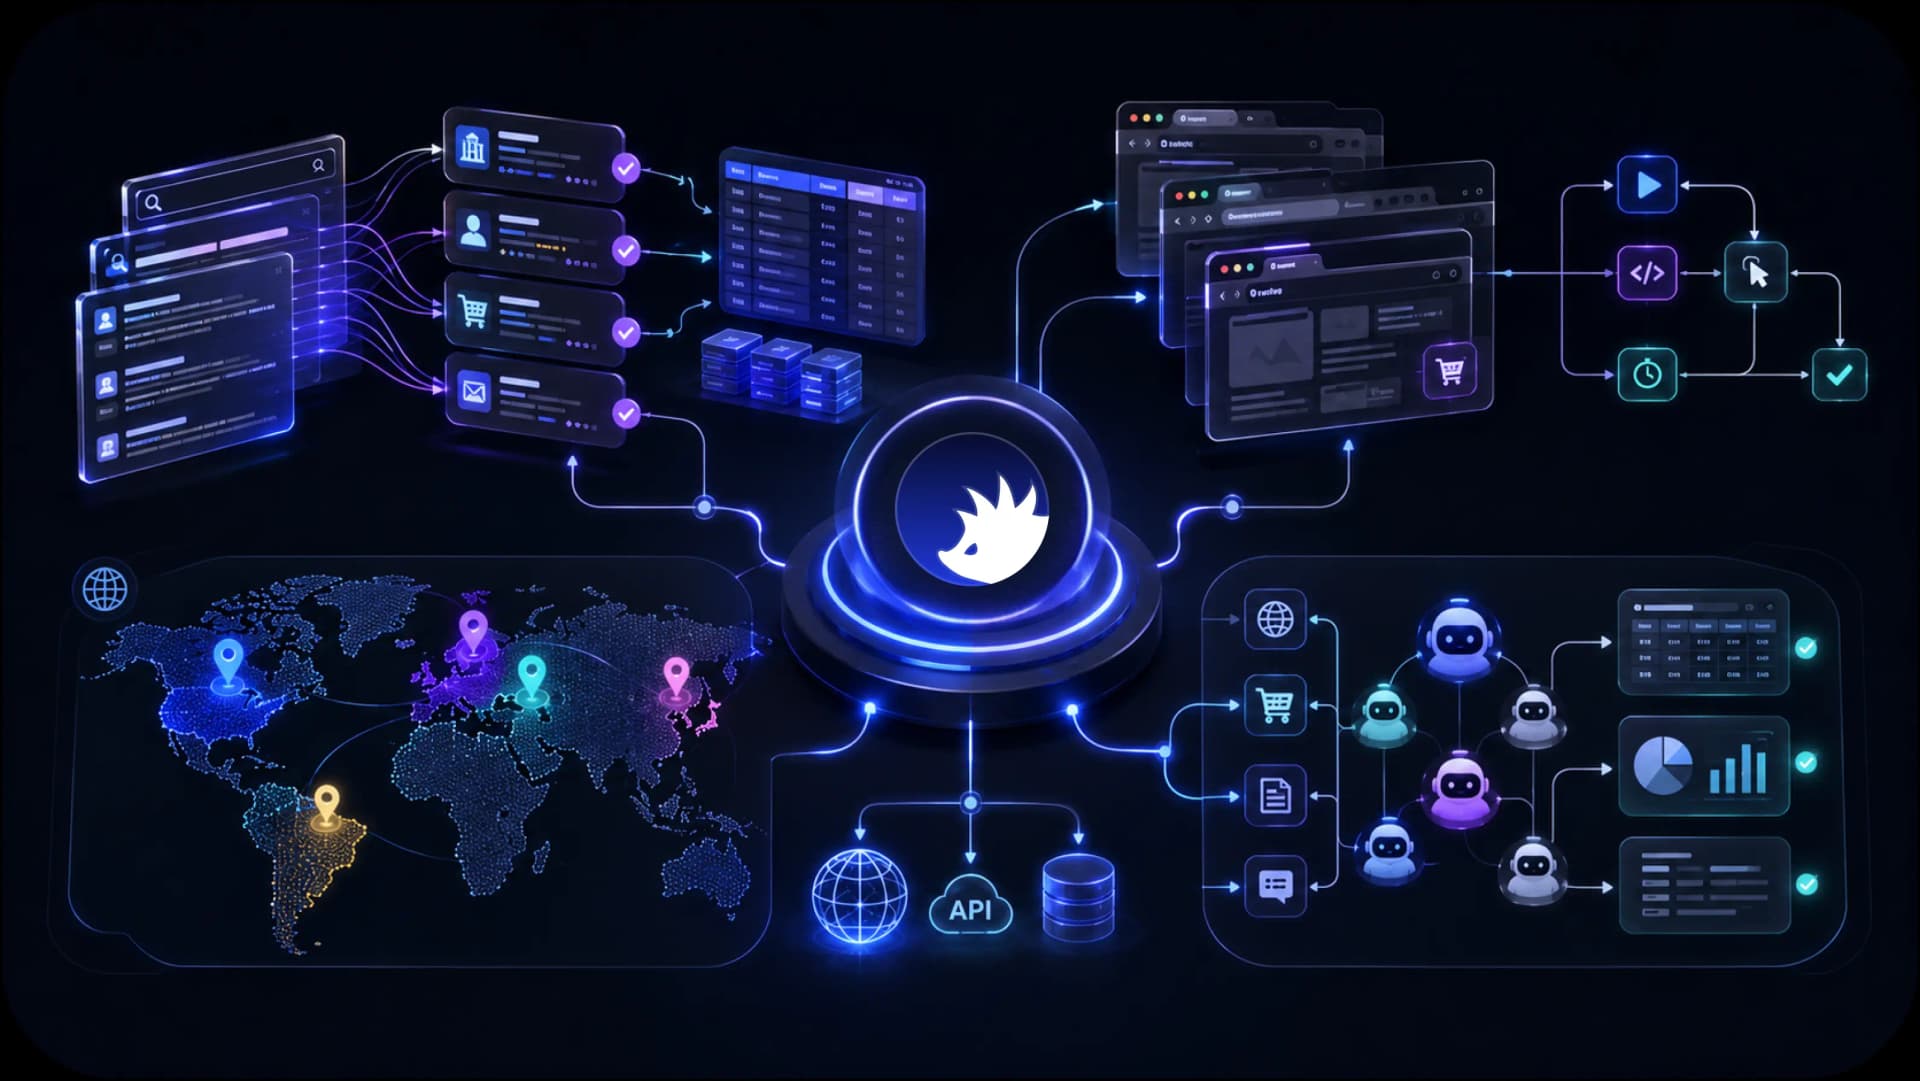
CyberYozh 集成了 AI 团队所需的基础设施,用于收集数据、自动化工作流程、访问区域内容以及扩展执行环境。从移动 LTE / 5G 和住宅代理,到浏览器自动化支持、指纹识别、防欺诈检测和安卓云手机,一切都旨在通过单一平台支持 AI 工作流。
AI网页爬取
AI浏览器自动化
人工智能数据收集
AI代理执行
移动AI工作流程
区域性人工智能访问
通过实际工作流程、平台功能和基础设施示例,了解 CyberYozh 的实际运作方式。探索仪表盘、集成、执行环境以及为 AI 团队和自动化项目提供的各种工具。
大规模构建训练语料库时,几乎每次都会撞上同一堵墙:数据源不希望被人从同一个地址、以这样的强度和速度抓取。
网站会限流或封禁 IP,只要发送大量请求就会被盯上——数据收集远未达到目标规模就会中断,工程师还得花时间去解封。
Cloudflare 和 DataDome 会标记非人类的请求模式和设备指纹,让你遇到验证码拦截。
只能从单一地区收集数据 – 没有本地 IP,就无法稳定获取其他市场特有的来源、语言和观点
Reddit、小众论坛以及其他高价值的训练数据来源,需要注册并通过手机验证才能查看完整内容,这在 IP 封锁之外又增加了一道门槛。
CyberYozh App 代理可以同时解决这四个问题:它把请求分散到看起来像真实用户的 IP 上,覆盖所需的地区,并满足训练语料库所需的请求量。
Reddit、Hacker News、Stack Exchange 和各类小众社区,是对话类和垂直领域训练数据最丰富的来源之一,但它们对频率限制也最严格。这里最适合使用面向 AI 数据集的移动代理,因为来自 Vodafone 或 T-Mobile 等移动运营商的真实 IP,可以通过那些一眼就能识别数据中心流量的检测。
提示: 遇到登录墙和懒加载的帖子时,通常需要用 Playwright 或 Puppeteer 渲染并翻页,才能抓取到内容。
GitHub、GitLab 和包注册中心大多是开放的,对 API 也很友好,因此数据中心代理在这里表现很好:速度快、成本低,对大批量拉取而言信任度也足够。
出版物、期刊和授权档案库需要更克制的访问方式。这类来源在 AI 训练数据收集中面临的法律审查最多,因此适合使用住宅代理或移动代理,并配合记录访问了什么、如何访问的。
电商商品列表和评论更新频繁,抓取行为也受到严密监控。轮换住宅代理可以保持高请求量,同时避免触发价格失真或封禁这类针对自动化流量的标记。
要构建能够跨语言、跨地区泛化的语料库,就得直接从本地来源收集,而不是只采集服务器恰好看到的那个版本。覆盖 195 多个国家的地理定位住宅代理可以抓取真实的本地内容,避免数据偏向爬虫所在的地区。
无需为每种来源类型单独搭建一套抓取层,Yozh Scraper 开箱即可通过移动、住宅或数据中心代理运行基于 Playwright 的任务。一个工具就能完成社交平台、电商网站和新闻来源的 AI 数据收集。
💡 运营要点:大多数训练语料库会混合其中的多个类别。按来源混用不同代理类型,而不是所有场景都默认用同一种,可以让简单目标的成本更低,困难目标的成功率更高。
根据数据源的防御强度来选择代理。
移动运营商 IP 的信任度高于住宅 IP。如果要从移动优先的平台收集 AI 训练数据,它们是最佳选择,例如 Instagram、TikTok、Reddit,或需要先通过短信验证才能获得完整访问权限的 Facebook 账号。
提示:使用覆盖 195 多个国家的 CyberYozh App 短信验证虚拟号码,可以顺利完成账号注册。
住宅 IP 与真实的 ISP 绑定,在平台看来就是真实用户。对于社交媒体平台、论坛、电商和新闻网站,包括 Reddit 帖子和商品评论,它们更加可靠。
在不需要住宅身份的大批量拉取场景中,数据中心 IP 完全够用。它们最适合代码仓库、政府数据集和公共档案,例如 GitHub、包注册中心和开放数据门户。
对于大规模 AI 数据收集,随着抓取量增长,代理成本会迅速上升。住宅代理按消耗的流量计费,而 CyberYozh App 的独享移动代理则以固定的日价提供无限流量。下面对比不同收集规模下的成本。
每日流量 | 住宅代理(每 GB $2.5,100 GB 起) | 独享移动代理(每天 $3.5) |
|---|---|---|
3 GB | $7.5 | $3.50 |
10 GB | $25 | $3.50 |
25 GB | $62.50 | $3.50 |
50 GB | $125 | $3.50 |
100 GB | $250 | $3.50 |
独享移动代理:每月 $105,与流量大小无关,但须遵守套餐的无限流量使用条款。
住宅代理:25 GB 每月 $62.5,100 GB 为 $250。
每月 500 GB 时:住宅代理每月 $1,100(商业套餐),而独享移动代理为 $105。
AI 训练数据的收集正面临越来越严格的法律审查,责任也越来越多地沿整个流程向上追溯,而不仅仅是训练模型的公司。来源清晰、有据可查,决定了数据收集流程是经得起检验,还是一被质疑就站不住脚。
以下几项做法可以降低这类风险,让你的数据来源在被质疑时有据可依:
遵守 robots.txt 和公开的频率限制,而不是绕开它们。
保留抓取日志 – 包括时间戳、来源 URL 和访问方式,以便证明收集了什么、如何收集的。
端到端追踪 IP 和数据来源,而不是仅凭中间方的说法来确认数据是如何获得的。
将AI 数据收集与再分发分开,并在共享训练数据集之前,记录下游用途、授权限制或第三方数据权利。
CyberYozh App 在一个平台上集齐了 AI 训练数据收集所需的各个环节 – 代理、验证和欺诈防护。这样,团队无需为流程的每个环节分别拼凑不同的供应商。
1 亿以上住宅代理,支持轮换和最长 24 小时的 sticky 会话、IP 过滤、免费地理定位以及 API 控制的轮换
真实的 5G/LTE 移动代理,不限带宽,适合大批量收集,不会因流量上限拖慢语料库构建
覆盖 195 多个国家的城市级和邮编级地理定位,获取真实的地区性和多语言数据
IP 欺诈评分检测,预先筛选出口 IP,保持数据来源干净
操作系统指纹切换,减少验证码和请求被拦截的情况
虚拟短信号码和支付卡,无需暴露个人账号即可完成注册和验证门槛
与 Playwright、Puppeteer、Selenium、Postman、Scrapy 及自定义工具兼容的 API。
选择代理类型。开放仓库和批量 API 拉取用数据中心代理,有频率限制或地域限制的来源用住宅代理,论坛、社交平台和注册墙用移动 LTE/5G 代理。
配置位置。选择国家、城市或邮编级定位,让每个数据源都从对应地区获取——否则语料库会继承地域偏差。
获取凭据。从控制面板复制端点、用户名和密码,或生成 API 密钥,用于程序化的流程调用。
连接。将凭据添加到 Playwright、Puppeteer、Selenium、Scrapy 或自定义脚本中——或者直接运行 Yozh Scraper,省去接线步骤。在同一份配置中,可以按请求或按会话设置轮换或 sticky 模式。
测试连接。检查出口 IP 和 IP 欺诈评分,然后发送测试请求,确认轮换、sticky 时长和地理定位均符合预期,再扩大语料库的构建规模。
了解适用于类似任务的代理: AI 搜索代理的代理、ChatGPT 代理基础设施以及SERP 数据收集代理。