Resumen
La recopilación de datos para IA es el proceso de recopilar y preparar datos para modelos de aprendizaje automático.
Los datos provienen de seis métodos principales: web scraping, APIs, datos de usuario de primera parte, sensores, conjuntos de datos existentes y datos sintéticos.
Los datos sin procesar no son utilizables hasta que se limpian, deduplicados y, a menudo, etiquetados.
Los datos públicos suelen ser terreno libre. Los datos personales y los datos detrás de inicios de sesión tienen límites legales.
Respuesta rápida: La recopilación de datos para IA es el proceso de recopilar texto sin procesar, imágenes, audio, video o registros y prepararlos para entrenar, probar y mejorar modelos de aprendizaje automático. Los equipos los recopilan mediante web scraping, APIs, interacciones de usuario, sensores, conjuntos de datos públicos y generación sintética, luego los limpian y etiquetan antes del entrenamiento.
Qué es la recopilación de datos para IA
Es el primer paso para construir cualquier modelo de aprendizaje automático. Un modelo solo puede aprender patrones de sus ejemplos, por lo que los datos que recopilas determinan qué puede hacer y dónde falla.
Lo que la diferencia de la recopilación ordinaria de datos es el objetivo. Un informe de ventas necesita registros precisos. Un modelo necesita volumen, variedad y equilibrio: miles o millones de ejemplos que cubran las situaciones reales que enfrentará, sin que una fuente ahogue al resto. Por eso la recopilación de datos en aprendizaje automático suele ser un proceso continuo en lugar de una exportación única.
¿Es lo mismo que los datos de entrenamiento?
No exactamente. Los datos de entrenamiento son el resultado: los ejemplos limpios y etiquetados de los que aprende un modelo. La recopilación es el trabajo de encontrar, reunir y preparar esos ejemplos. La mayoría de los equipos también reservan datos de validación y prueba separados para verificar el modelo con ejemplos que no ha visto.
Cómo recopila datos la IA
La IA no recopila datos por sí sola. Las personas y los pipelines los recopilan, utilizando seis métodos principales.
Método | Qué recopila | Ejemplo típico |
Web scraping y crawling | Páginas públicas, listados, reseñas, artículos | Datos de precios para un modelo de pronóstico |
APIs | Datos estructurados que una plataforma elige compartir | Publicaciones o datos de productos de una API oficial |
Datos de primera parte | Clics, búsquedas, compras, chats de soporte | Motor de recomendación propio de una tienda |
Sensores y dispositivos | Fotogramas de cámara, GPS, lecturas de wearables y máquinas | Modelos de conducción autónoma e inspección de fábrica |
Conjuntos de datos existentes | Colecciones abiertas o con licencia | Entrenar un modelo de imagen con un conjunto de imágenes público |
Datos sintéticos | Ejemplos generados por software u otros modelos | Casos raros de fraude que los datos reales no tienen |
La mayoría de los modelos de producción combinan varios métodos. Un chatbot de atención al cliente podría mezclar los registros de chat propios de la empresa, artículos de ayuda públicos y conversaciones sintéticas que cubran preguntas poco frecuentes.
¿De dónde obtiene la IA sus datos?
La mayor fuente individual es la web pública. Common Crawl, una organización sin fines de lucro, ha mantenido un archivo abierto y gratuito de datos de rastreo web desde 2007, y los investigadores lo utilizan ampliamente en la investigación de modelos de lenguaje. Además de eso, los equipos de IA recurren a:
Contenido licenciado: archivos de noticias, libros, imágenes de stock y código, utilizados bajo acuerdos de pago
Datasets abiertos: colecciones de investigación publicadas para uso público
Interacciones de usuarios: comentarios, calificaciones y conversaciones, donde los términos de privacidad del producto lo permiten
Datos creados por humanos: expertos y anotadores que escriben, clasifican o etiquetan ejemplos
Los datos de entrenamiento para IA generativa se basan en gran medida en texto, código e imágenes de las dos primeras fuentes. Los modelos más pequeños específicos de tareas se basan más en los datos propios de primera mano de una empresa.
Perspectiva de experto: La mayoría de los proyectos de datos no se estancan en el código de scraping. Se estancan en solicitudes bloqueadas y cobertura irregular. Si tu crawler alcanza el 70% de las páginas de un sitio y falla silenciosamente en el resto, el modelo aprende una imagen sesgada sin que nadie lo note.
¿Qué tipos de datos recopila la IA?
Tipo de dato | Ejemplos | Qué impulsa |
Estructurados | Precios, fechas, transacciones, lecturas de sensores | Modelos de pronóstico, precios y fraude |
No estructurados | Texto libre, imágenes, audio, video | Modelos de lenguaje, visión por computadora, reconocimiento de voz |
Semiestructurados | JSON, XML, registros de chat, páginas web | Chatbots, ranking de búsqueda, sistemas de recomendación |
¿Cómo es el pipeline de recopilación de datos de IA?
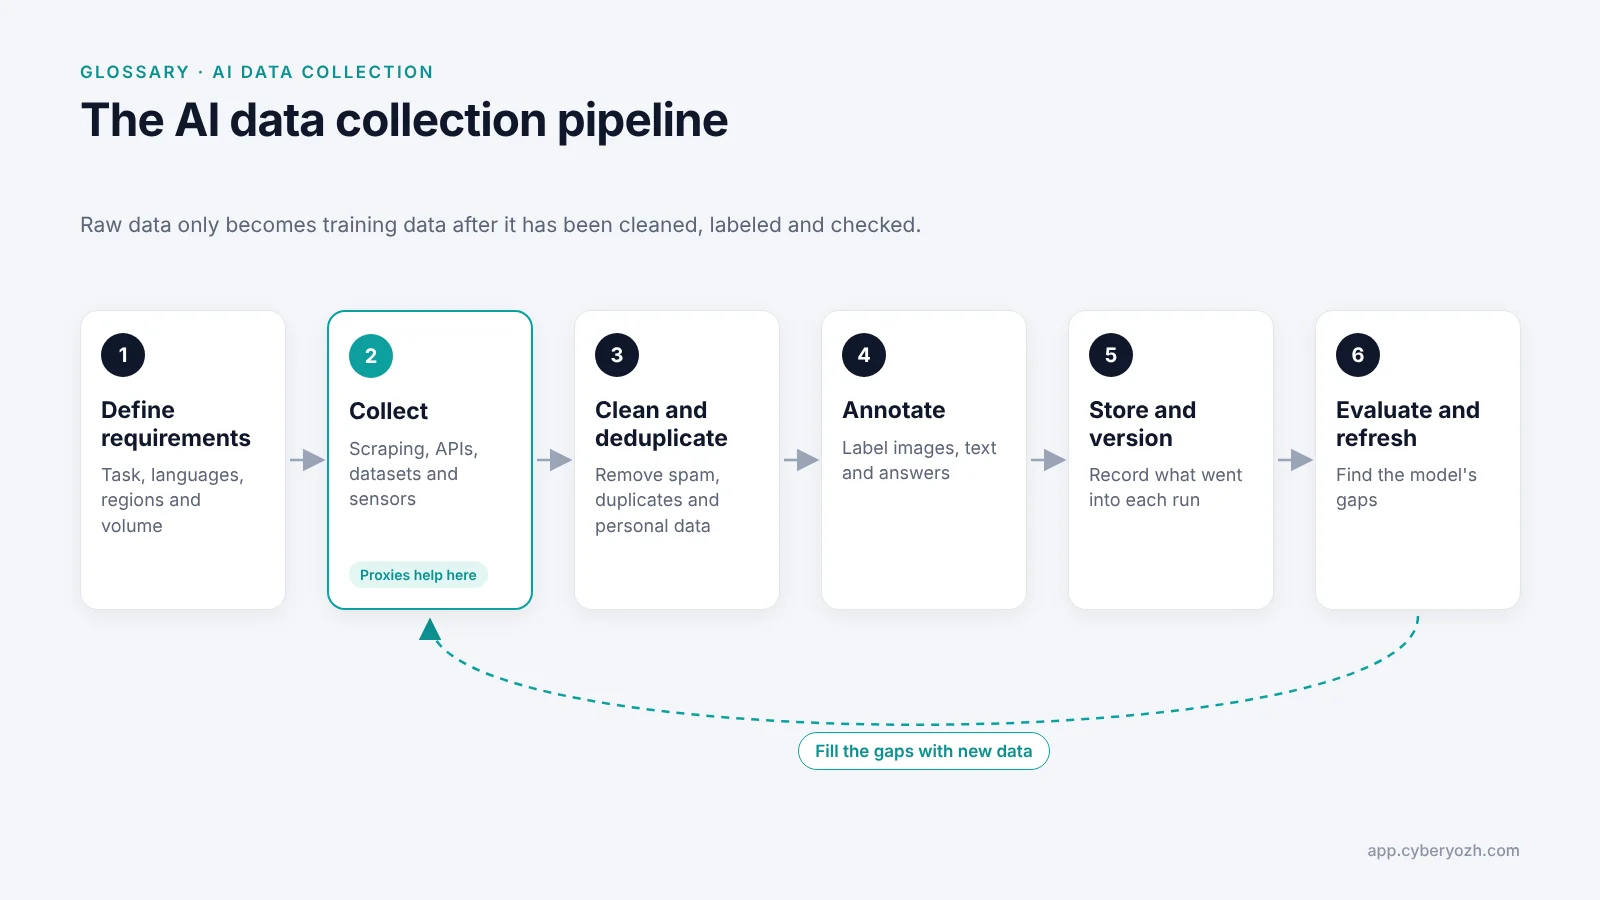
Definir requisitos: qué debe hacer el modelo, qué idiomas o regiones cubre y cuántos datos necesita
Recopilar: ejecutar scrapers, extracciones de API y descargas de datasets
Limpiar y deduplicar: eliminar páginas rotas, spam, casi duplicados y datos personales que no deberías conservar
Anotar: etiquetar ejemplos donde sea necesario, como etiquetar imágenes o calificar respuestas
Almacenar y versionar: mantener un registro de lo que se incluyó en cada ejecución de entrenamiento
Evaluar y actualizar: verificar el modelo, identificar sus deficiencias y recopilar nuevos datos para subsanarlas
La recopilación y la anotación de datos suelen confundirse. La recopilación obtiene la materia prima. La anotación añade las etiquetas que indican a un modelo qué significa cada ejemplo.
Error común: Recopilar datos desde una sola ubicación. Los precios, los resultados de búsqueda e incluso el texto de las páginas cambian según el país. Un dataset extraído completamente desde direcciones IP de EE. UU. enseña al modelo la versión estadounidense de la web y la presenta como si fuera toda la web.
¿Es legal la recopilación de datos para IA?
Generalmente sí, cuando se limita a datos públicos y respeta la legislación de privacidad. Tres líneas son las más importantes:
Público vs. privado. En el prolongado caso hiQ v. LinkedIn, un tribunal de apelaciones de EE. UU. determinó que el scraping de páginas de acceso público probablemente no infringe la Computer Fraud and Abuse Act (resumen del caso de la EFF). Los términos de servicio aún pueden generar reclamaciones contractuales, que es como esa disputa finalmente se resolvió en contra de hiQ.
Datos personales. Los nombres, fotografías y datos de contacto están sujetos a leyes de privacidad como el RGPD en Europa y la CCPA en California, incluso cuando son públicamente visibles.
Derechos de autor. Varias demandas sobre el entrenamiento de modelos con obras protegidas por derechos de autor siguen abiertas, por lo que las fuentes con licencia o de licencia abierta conllevan menos riesgo.
Advertencia: No recopile datos desde detrás de un inicio de sesión ni eluda los controles de acceso de un sitio. Ahí es donde reside la mayor parte del riesgo legal. Esta página es información general, no asesoramiento legal, así que consulte con un abogado antes de recopilar datos personales a gran escala.
Para una lista de verificación práctica, consulte nuestra guía sobre web scraping ético.
¿Por qué la recopilación de datos web necesita proxies?
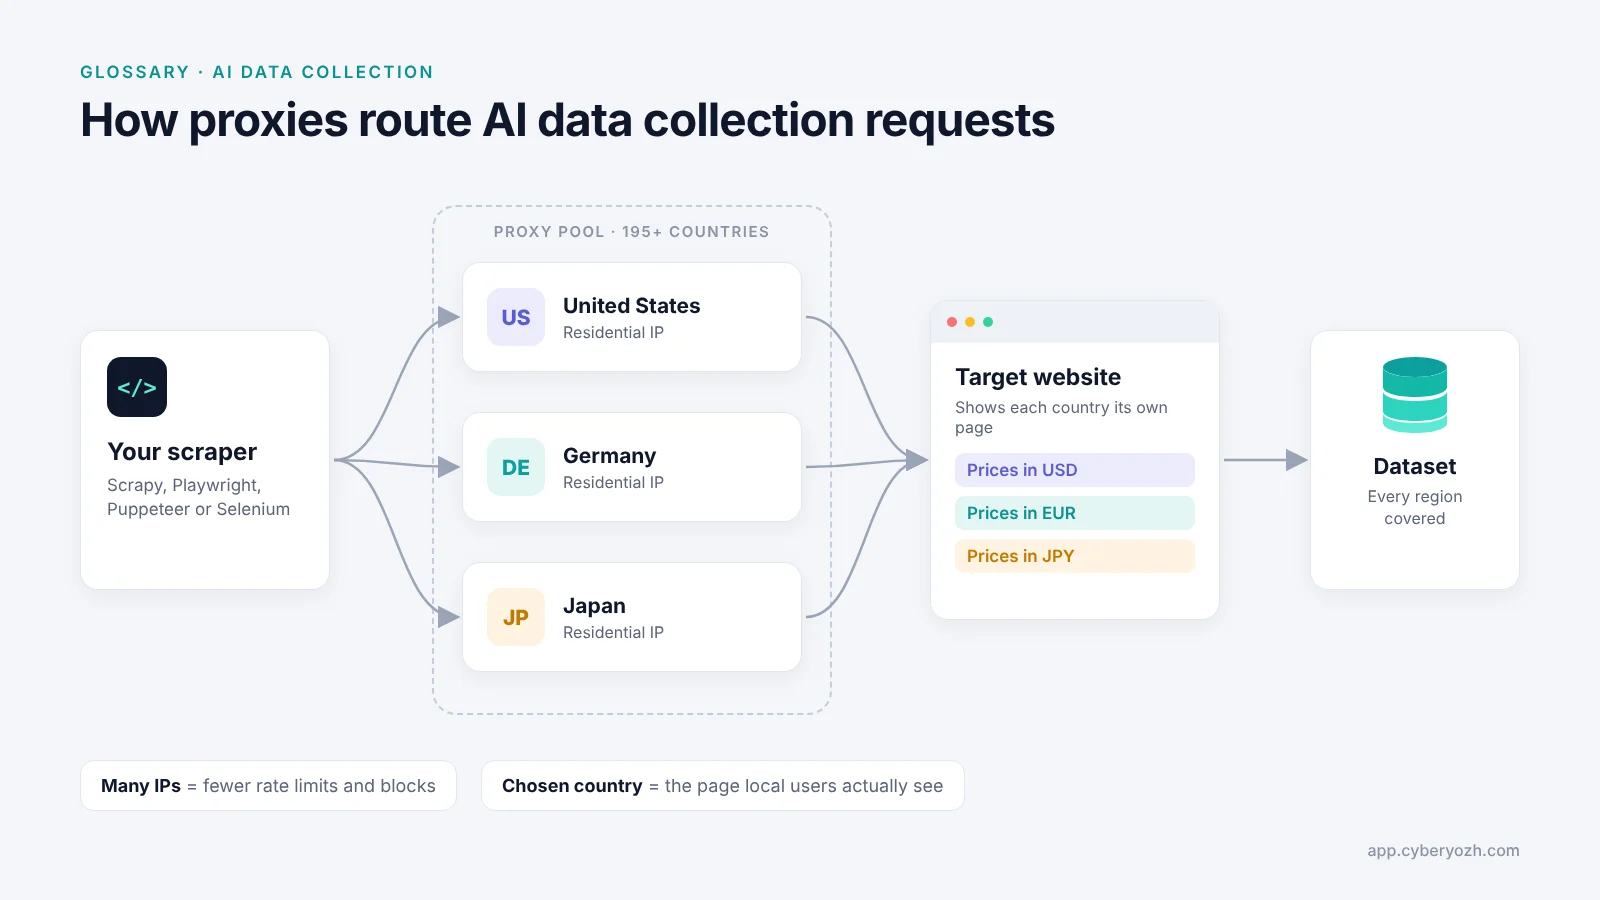
Solo uno de los seis métodos los necesita: recopilar datos web públicos a gran escala. Si envía miles de solicitudes desde una sola dirección IP, los sitios le limitarán la velocidad o le bloquearán en cuestión de minutos. Además, solo verá la versión de cada página que se muestra en su propio país.
Los proxies distribuyen las solicitudes entre múltiples direcciones IP y te permiten elegir el país de origen de cada solicitud. Así es como los tipos de proxy de CyberYozh se ajustan a trabajos comunes de recopilación de datos de IA:
Trabajo de recopilación | Mejor tipo de proxy | Precio desde |
Rastreo a gran escala de páginas públicas | $2/GB | |
Recopilación de alto volumen de sitios ligeramente protegidos | Datacenter, tráfico ilimitado | $1.77/mes (compartido) |
Sesiones que deben mantener una IP, como resultados paginados | $5.29/mes | |
Contenido exclusivo móvil y los sitios más estrictos | Ver el catálogo |
Más de 100M de IPs residenciales en más de 195 países para conjuntos de datos equilibrados y específicos por ubicación
Acceso completo a API con soporte para Selenium, Playwright, Puppeteer y Scrapy
HTTP(S) y SOCKS5 en cada tipo de proxy
Calificado 4.7+ Excelente en Trustpilot
Consejo profesional: Ejecuta una muestra de tus IPs a través del verificador de IP Fraud Score gratuito de CyberYozh antes de un rastreo grande. Cambiar las direcciones marcadas primero cuesta minutos. Depurar un rastreo medio bloqueado después cuesta días.
¿Construyendo un pipeline? Consulta nuestros proxies para recopilación de datos de IA, o compara proveedores en nuestro resumen de servicios de recopilación de datos.
Recopila datos más limpios y equilibrados por ubicación. Explora el catálogo de proxies de CyberYozh →