Resumo
A coleta de dados de IA é o processo de reunir e preparar dados para modelos de machine learning.
Os dados vêm de seis métodos principais: web scraping, APIs, dados de usuários primários, sensores, conjuntos de dados existentes e dados sintéticos.
Os dados brutos não são utilizáveis até serem limpos, desduplicados e frequentemente rotulados.
Dados públicos geralmente são permitidos. Dados pessoais e dados protegidos por login têm limites legais.
Resposta Rápida: A coleta de dados de IA é o processo de reunir texto bruto, imagens, áudio, vídeo ou registros e prepará-los para treinar, testar e melhorar modelos de machine learning. As equipes coletam através de web scraping, APIs, interações de usuários, sensores, conjuntos de dados públicos e geração sintética, depois limpam e rotulam antes do treinamento.
O que é coleta de dados de IA
É o primeiro passo na construção de qualquer modelo de machine learning. Um modelo só pode aprender padrões em seus exemplos, então os dados que você coleta determinam o que ele pode fazer e onde falha.
O que a diferencia da coleta de dados comum é o objetivo. Um relatório de vendas precisa de registros precisos. Um modelo precisa de volume, variedade e equilíbrio: milhares ou milhões de exemplos que cubram as situações reais que enfrentará, sem que uma fonte domine as demais. É por isso que a coleta de dados em machine learning geralmente é um processo contínuo, e não uma exportação única.
É o mesmo que dados de treinamento
Não exatamente. Dados de treinamento são o resultado: os exemplos limpos e rotulados dos quais um modelo aprende. Coleta é o trabalho de encontrar, reunir e preparar esses exemplos. A maioria das equipes também reserva dados separados de validação e teste para verificar o modelo em exemplos que ele não viu.
Como a IA coleta dados
A IA não coleta dados por conta própria. Pessoas e pipelines coletam, usando seis métodos principais.
Método | O que coleta | Exemplo típico |
Web scraping e crawling | Páginas públicas, listagens, avaliações, artigos | Dados de preços para um modelo de previsão |
APIs | Dados estruturados que uma plataforma escolhe compartilhar | Posts ou dados de produtos de uma API oficial |
Dados primários | Cliques, buscas, compras, chats de suporte | Motor de recomendação próprio de uma loja |
Sensores e dispositivos | Frames de câmera, GPS, leituras de wearables e máquinas | Modelos de condução autônoma e inspeção de fábrica |
Conjuntos de dados existentes | Coleções abertas ou licenciadas | Treinar um modelo de imagem em um conjunto de imagens público |
Dados sintéticos | Exemplos gerados por software ou outros modelos | Casos raros de fraude que os dados reais não possuem |
A maioria dos modelos de produção combina vários métodos. Um chatbot de suporte ao cliente pode misturar os próprios logs de chat da empresa, artigos de ajuda públicos e conversas sintéticas cobrindo perguntas raras.
De onde a IA obtém seus dados
A maior fonte individual é a web pública. Common Crawl, uma organização sem fins lucrativos, mantém um arquivo aberto e gratuito de dados de rastreamento web desde 2007, e pesquisadores o utilizam amplamente em pesquisas de modelos de linguagem. Além disso, equipes de IA recorrem a:
Conteúdo licenciado: arquivos de notícias, livros, imagens de banco e código, usados sob acordos pagos
Datasets abertos: coleções de pesquisa liberadas para uso público
Interações de usuários: feedback, avaliações e conversas, quando os termos de privacidade do produto permitem
Dados criados por humanos: especialistas e anotadores que escrevem, classificam ou rotulam exemplos
Dados de treinamento para IA generativa dependem fortemente de texto, código e imagens das duas primeiras fontes. Modelos menores específicos de tarefas dependem mais dos dados próprios de primeira parte de uma empresa.
Insight de Especialista: A maioria dos projetos de dados não trava no código de scraping. Eles travam em requisições bloqueadas e cobertura irregular. Se seu crawler alcança 70% das páginas de um site e falha silenciosamente no restante, o modelo aprende uma imagem distorcida sem que ninguém perceba.
Que tipos de dados a IA coleta
Tipo de dado | Exemplos | O que alimenta |
Estruturados | Preços, datas, transações, leituras de sensores | Modelos de previsão, precificação e fraude |
Não estruturados | Texto livre, imagens, áudio, vídeo | Modelos de linguagem, visão computacional, reconhecimento de fala |
Semiestruturados | JSON, XML, logs de chat, páginas web | Chatbots, ranqueamento de busca, sistemas de recomendação |
Como é o pipeline de coleta de dados de IA
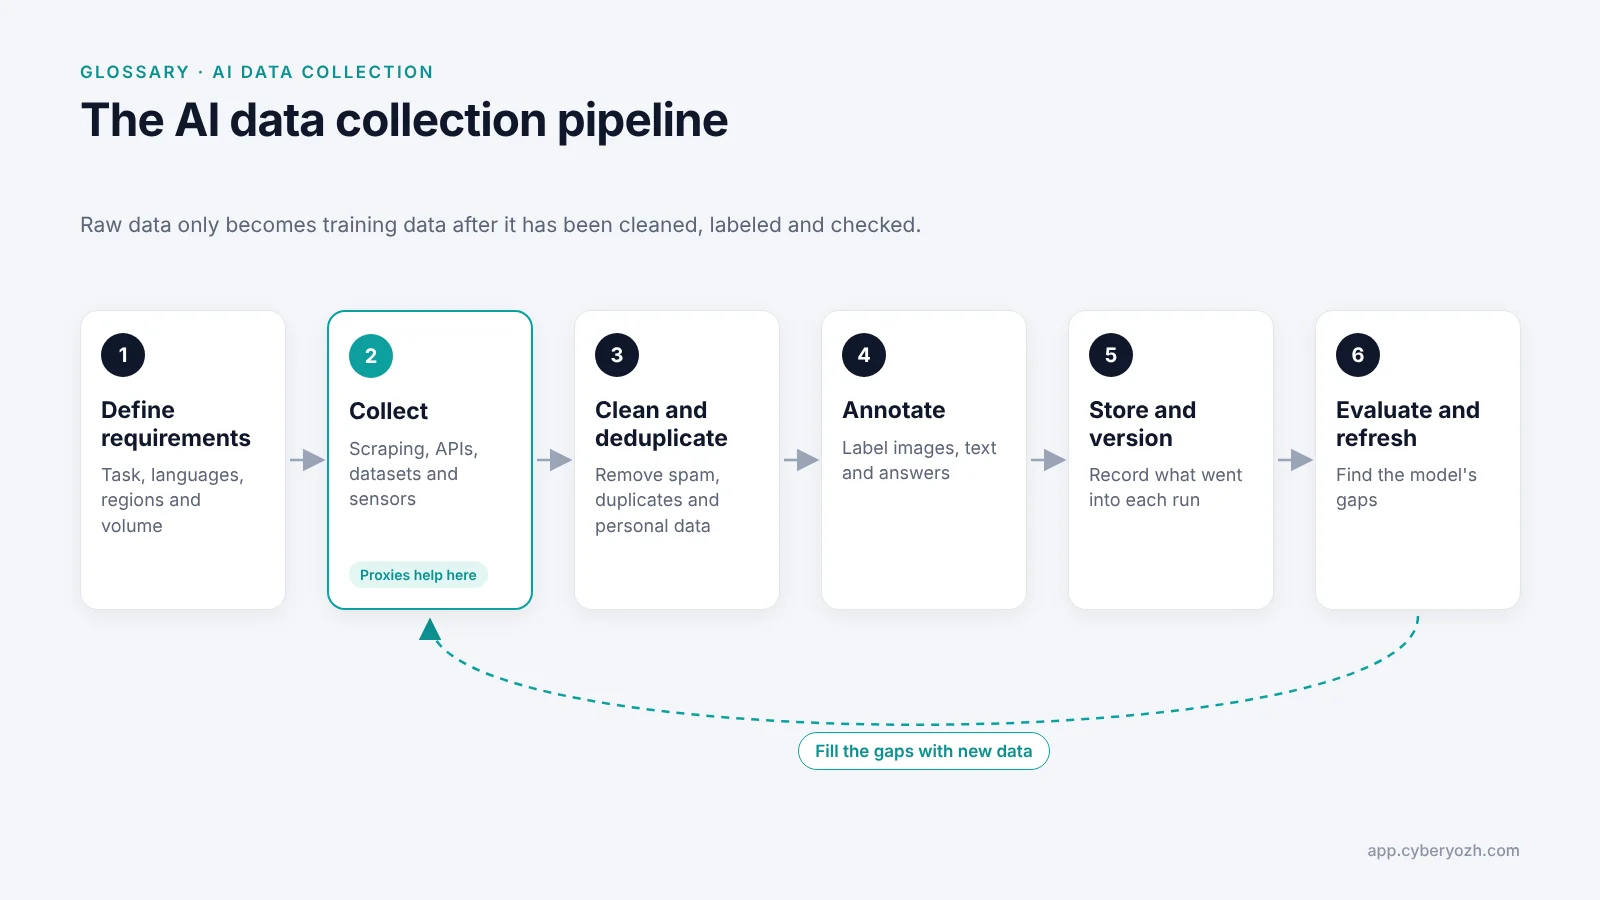
Definir requisitos: o que o modelo deve fazer, quais idiomas ou regiões ele cobre e quanto dado ele precisa
Coletar: executar scrapers, pulls de API e downloads de datasets
Limpar e deduplicar: remover páginas quebradas, spam, quase-duplicatas e dados pessoais que você não deve manter
Anotar: rotular exemplos quando necessário, como marcar imagens ou avaliar respostas
Armazenar e versionar: manter um registro do que entrou em cada execução de treinamento
Avaliar e atualizar: verificar o modelo, encontrar suas lacunas e coletar novos dados para preenchê-las
Coleta de dados e anotação são frequentemente confundidas. A coleta reúne a matéria-prima. A anotação adiciona os rótulos que dizem a um modelo o que cada exemplo significa.
Erro Comum: Coletar dados de apenas uma localização. Preços, resultados de pesquisa e até mesmo o texto da página mudam por país. Um dataset coletado inteiramente de endereços IP dos EUA ensina ao modelo a versão americana da web e a chama de web inteira.
A coleta de dados de IA é legal
Geralmente, quando se limita a dados públicos e respeita a lei de privacidade. Três linhas são as mais importantes:
Público vs. privado. No caso hiQ v. LinkedIn, que se estendeu por muito tempo, um tribunal de apelações dos EUA concluiu que fazer scraping de páginas publicamente acessíveis provavelmente não viola a Lei de Fraude e Abuso de Computadores (resumo do caso da EFF). Os termos de serviço ainda podem criar reivindicações contratuais, e foi assim que a disputa acabou sendo desfavorável à hiQ.
Dados pessoais. Nomes, fotos e detalhes de contato se enquadram em leis de privacidade como o GDPR na Europa e o CCPA na Califórnia, mesmo quando estão publicamente visíveis.
Direitos autorais. Vários processos judiciais sobre o treinamento de modelos com trabalhos protegidos por direitos autorais ainda estão em aberto, portanto, fontes licenciadas ou de licença aberta apresentam menos risco.
Aviso: Não colete dados de trás de um login ou contorne os controles de acesso de um site. É aí que está a maior parte do risco legal. Esta página é informação geral, não aconselhamento jurídico, portanto, consulte um advogado antes de coletar dados pessoais em escala.
Para uma lista de verificação prática, consulte nosso guia sobre web scraping ético.
Por que a coleta de dados web precisa de proxies
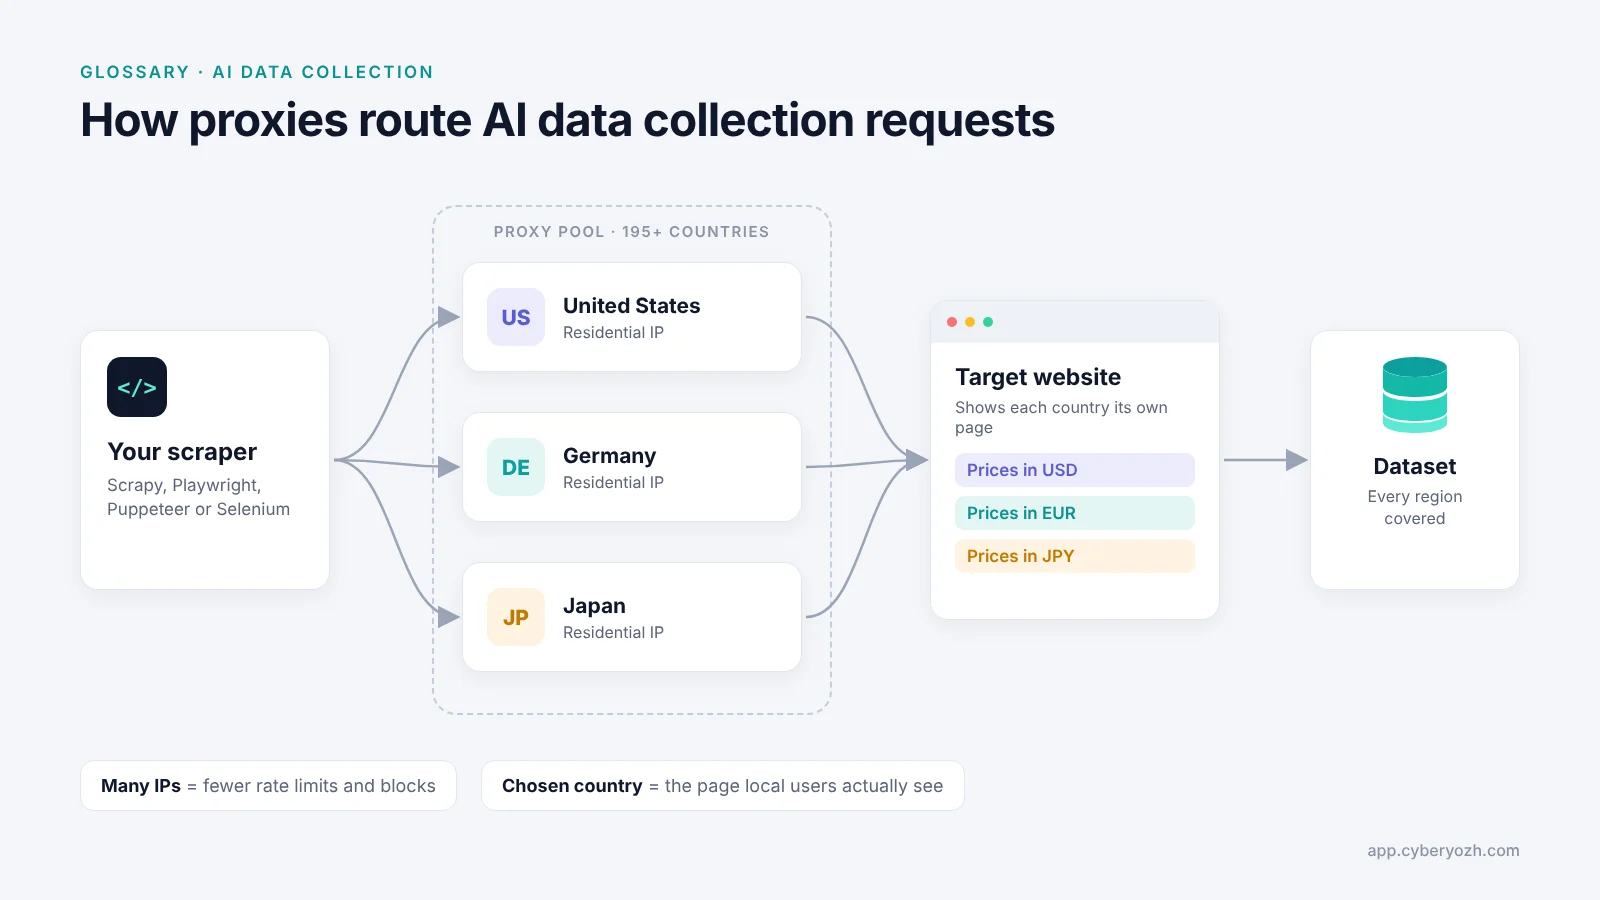
Apenas um dos seis métodos precisa deles: coletar dados web públicos em escala. Se você enviar milhares de solicitações de um único endereço IP, os sites vão limitar a taxa ou bloqueá-lo em questão de minutos. Você também só vê a versão de cada página mostrada ao seu próprio país.
Os proxies distribuem as requisições por vários endereços IP e permitem escolher o país de origem de cada requisição. Veja como os tipos de proxy do CyberYozh se adequam a tarefas comuns de coleta de dados para IA:
Tarefa de coleta | Melhor tipo de proxy | Preço a partir de |
Crawling em larga escala de páginas públicas | $2/GB | |
Coleta de alto volume de sites levemente protegidos | Datacenter, tráfego ilimitado | $1,77/mês (compartilhado) |
Sessões que precisam manter um IP, como resultados paginados | $5,29/mês | |
Conteúdo exclusivo para mobile e sites mais rigorosos | Ver o catálogo |
Mais de 100M de IPs residenciais em mais de 195 países para datasets balanceados e específicos por localização
Acesso completo à API com suporte para Selenium, Playwright, Puppeteer e Scrapy
HTTP(S) e SOCKS5 em todos os tipos de proxy
Avaliado com 4,7+ Excelente no Trustpilot
Dica profissional: Execute uma amostra dos seus IPs no verificador de IP Fraud Score gratuito do CyberYozh antes de um grande crawl. Trocar endereços sinalizados primeiro custa minutos. Depurar um crawl meio bloqueado depois custa dias.
Construindo um pipeline? Veja nossos proxies para coleta de dados de IA, ou compare provedores em nossa seleção de serviços de coleta de dados.
Colete dados mais limpos e balanceados por localização. Navegue pelo catálogo de proxies do CyberYozh →