Коротко
Збір даних для ШІ — це процес отримання та підготовки даних для навчання моделей машинного навчання.
Дані збирають шістьма основними способами: скрейпинг вебсайтів, API, власні користувацькі дані, датчики, наявні датасети та синтетичні дані.
Сирі дані не можна використовувати, доки їх не очистять, не видалять дублікати та часто не розмітять.
Публічні дані зазвичай можна використовувати вільно. Персональні дані та дані за авторизацією мають юридичні обмеження.
Коротка відповідь: Збір даних для ШІ — це процес отримання сирого тексту, зображень, аудіо, відео або записів і їх підготовки для навчання, тестування та вдосконалення моделей машинного навчання. Команди збирають дані через скрейпинг вебсайтів, API, взаємодії з користувачами, датчики, публічні датасети та синтетичну генерацію, потім очищають і розмічають їх перед навчанням.
Що таке збір даних для ШІ
Це перший крок у створенні будь-якої моделі машинного навчання. Модель може навчатися лише на закономірностях у своїх прикладах, тому дані, які ви збираєте, визначають, що вона зможе робити і де помилятиметься.
Відмінність від звичайного збору даних полягає в меті. Для звіту про продажі потрібні точні записи. Моделі потрібні обсяг, різноманітність і баланс: тисячі або мільйони прикладів, які охоплюють реальні ситуації, з якими вона зіткнеться, і при цьому одне джерело не заглушує решту. Тому збір даних у машинному навчанні зазвичай є безперервним процесом, а не одноразовим вивантаженням.
Це те саме, що навчальні дані
Не зовсім. Навчальні дані — це результат: очищені, розмічені приклади, на яких вчиться модель. Збір — це робота з пошуку, отримання та підготовки цих прикладів. Більшість команд також відкладають окремі валідаційні та тестові дані, щоб перевірити модель на прикладах, які вона не бачила.
Як ШІ збирає дані
ШІ не збирає дані самостійно. Їх збирають люди та автоматизовані процеси, використовуючи шість основних методів.
Метод | Що збирає | Типовий приклад |
Скрейпинг і краулінг вебсайтів | Публічні сторінки, списки, відгуки, статті | Дані про ціни для моделі прогнозування |
API | Структуровані дані, якими платформа вирішує поділитися | Пости або дані про товари з офіційного API |
Власні дані | Кліки, пошукові запити, покупки, чати підтримки | Власна рекомендаційна система магазину |
Датчики та пристрої | Кадри з камер, GPS, дані з носимих пристроїв і машин | Моделі для безпілотних автомобілів і заводського контролю |
Наявні датасети | Відкриті або ліцензійні колекції | Навчання моделі зображень на публічному наборі зображень |
Синтетичні дані | Приклади, згенеровані програмним забезпеченням або іншими моделями | Рідкісні випадки шахрайства, яких немає в реальних даних |
Більшість промислових моделей поєднують кілька методів. Чат-бот служби підтримки може використовувати власні логи чатів компанії, публічні довідкові статті та синтетичні діалоги, що охоплюють рідкісні питання.
Звідки ШІ бере дані
Основне джерело — це публічний веб. Common Crawl— некомерційна організація, яка з 2007 року веде безкоштовний відкритий архів даних веб-краулінгу, широко використовуваний дослідниками мовних моделей. Окрім цього, команди ШІ використовують:
Ліцензійний контент: архіви новин, книги, стокові зображення та код, що використовуються за платними угодами
Відкриті датасети: дослідницькі колекції, опубліковані для загального доступу
Користувацькі взаємодії: відгуки, оцінки та листування — там, де це дозволено політикою конфіденційності продукту
Дані, створені людьми: експерти та розмічувачі, які пишуть, ранжують або розмічають приклади
Навчальні дані для генеративного ШІ здебільшого спираються на текст, код та зображення з перших двох джерел. Невеликі спеціалізовані моделі більше покладаються на власні дані компанії.
Експертна думка: Більшість проєктів зі збору даних зупиняються не через код скрейпера. Вони буксують через заблоковані запити та неповне охоплення. Якщо ваш краулер добирається до 70% сторінок сайту, а на решті мовчки падає, модель вчиться на спотвореній картині, і ніхто цього не помічає.
Які типи даних збирає ШІ
Тип даних | Приклади | Що це забезпечує |
Структуровані | Ціни, дати, транзакції, покази датчиків | Моделі прогнозування, ціноутворення та виявлення шахрайства |
Неструктуровані | Вільний текст, зображення, аудіо, відео | Мовні моделі, комп'ютерний зір, розпізнавання мовлення |
Напівструктуровані | JSON, XML, логи чатів, веб-сторінки | Чат-боти, ранжування в пошуку, рекомендаційні системи |
Як виглядає процес збору даних для ШІ
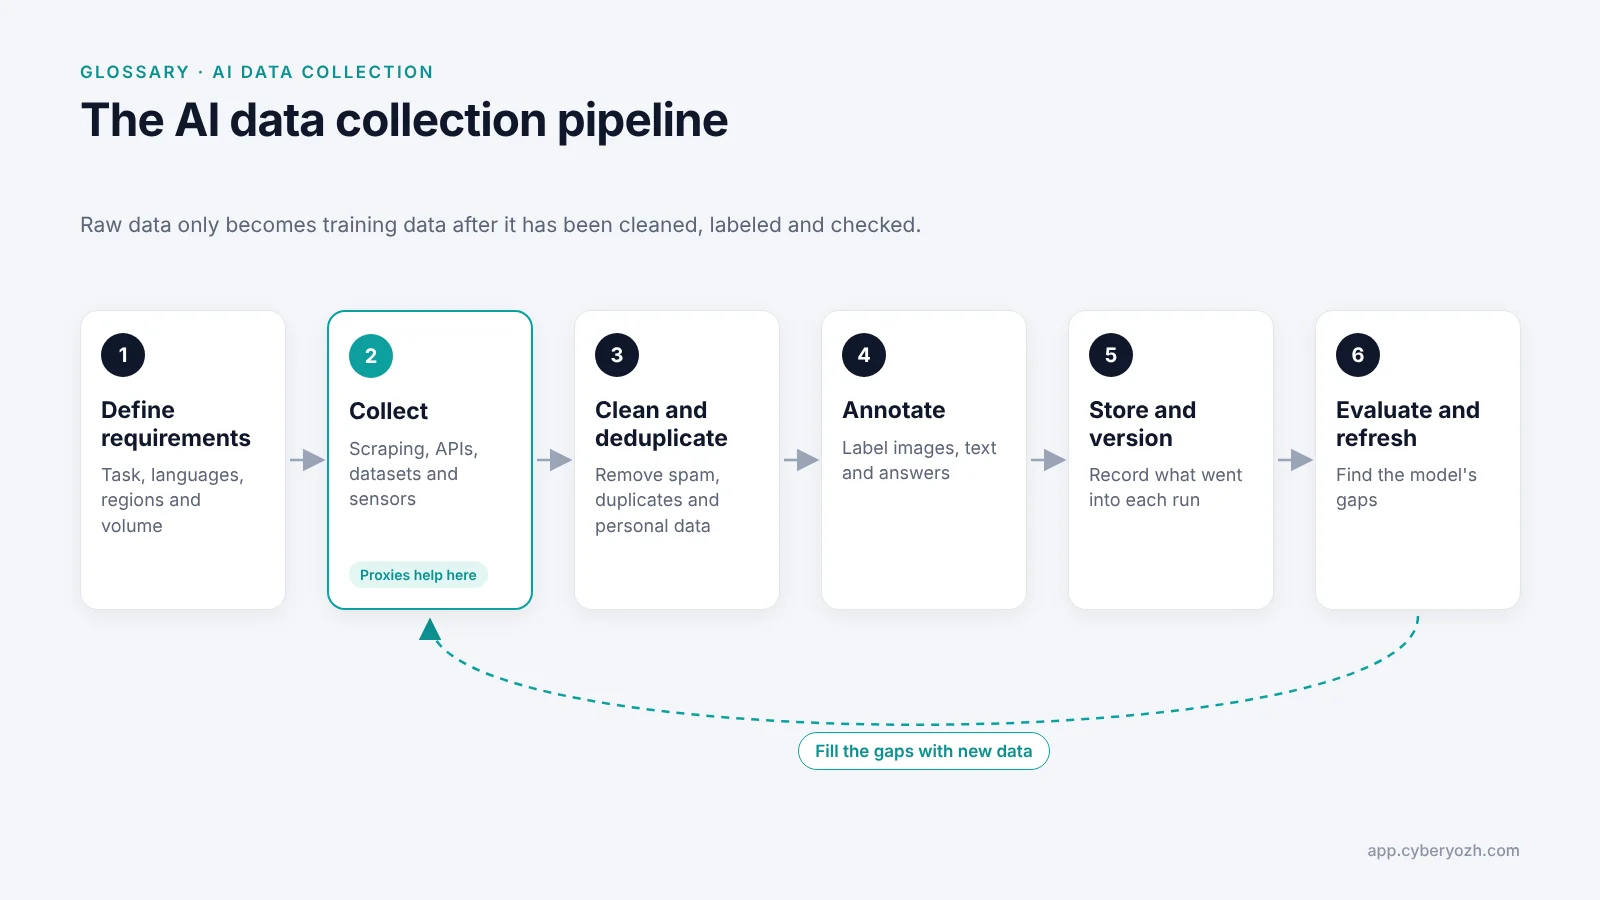
Визначення вимог: що має робити модель, які мови чи регіони вона охоплює і скільки даних їй потрібно
Збір: запуск скрейперів, вивантаження даних через API та завантаження датасетів
Очищення та дедуплікація: видалення битих сторінок, спаму, майже дублікатів і персональних даних, які не слід зберігати
Розмітка: розмітка прикладів там, де це необхідно, наприклад, тегування зображень або оцінка відповідей
Зберігання та версіонування: ведення запису про те, що увійшло в кожен запуск навчання
Оцінка та оновлення: перевіряйте модель, знаходьте її прогалини та збирайте нові дані, щоб їх заповнити
Збір даних та анотування часто плутають. Збір — це отримання вихідного матеріалу. Анотування додає мітки, які пояснюють моделі, що означає кожен приклад.
Поширена помилка: Збір даних лише з однієї локації. Ціни, результати пошуку і навіть текст сторінок змінюються залежно від країни. Датасет, повністю зібраний з американських IP-адрес, навчає модель американській версії інтернету і видає її за весь інтернет.
Чи легальний збір даних для ШІ
Зазвичай так, якщо йдеться про публічні дані і дотримуються закони про конфіденційність. Три моменти мають найбільше значення:
Публічне і приватне. У справі hiQ проти LinkedIn, яка тривала кілька років, апеляційний суд США постановив, що скрейпинг загальнодоступних сторінок, швидше за все, не порушує Закон про комп'ютерне шахрайство і зловживання (резюме справи від EFF). Умови використання все ще можуть стати підставою для договірних претензій — саме так цю суперечку зрештою було вирішено не на користь hiQ.
Персональні дані. Імена, фотографії та контактні дані підпадають під дію законів про конфіденційність, таких як GDPR у Європі та CCPA в Каліфорнії, навіть якщо вони знаходяться у публічному доступі.
Авторські права. Кілька судових позовів щодо навчання моделей на матеріалах, захищених авторським правом, все ще перебувають на розгляді, тому ліцензовані або відкрито ліцензовані джерела несуть менший ризик.
Увага: Не збирайте дані за формою входу і не обходьте засоби контролю доступу сайту. Саме там зосереджений основний юридичний ризик. Ця сторінка містить загальну інформацію, а не юридичну консультацію, тому проконсультуйтеся з юристом, перш ніж збирати персональні дані у великих обсягах.
Практичний чек-лист дивіться в нашому гайді з етичного веб-скрейпингу.
Навіщо для збору веб-даних потрібні проксі
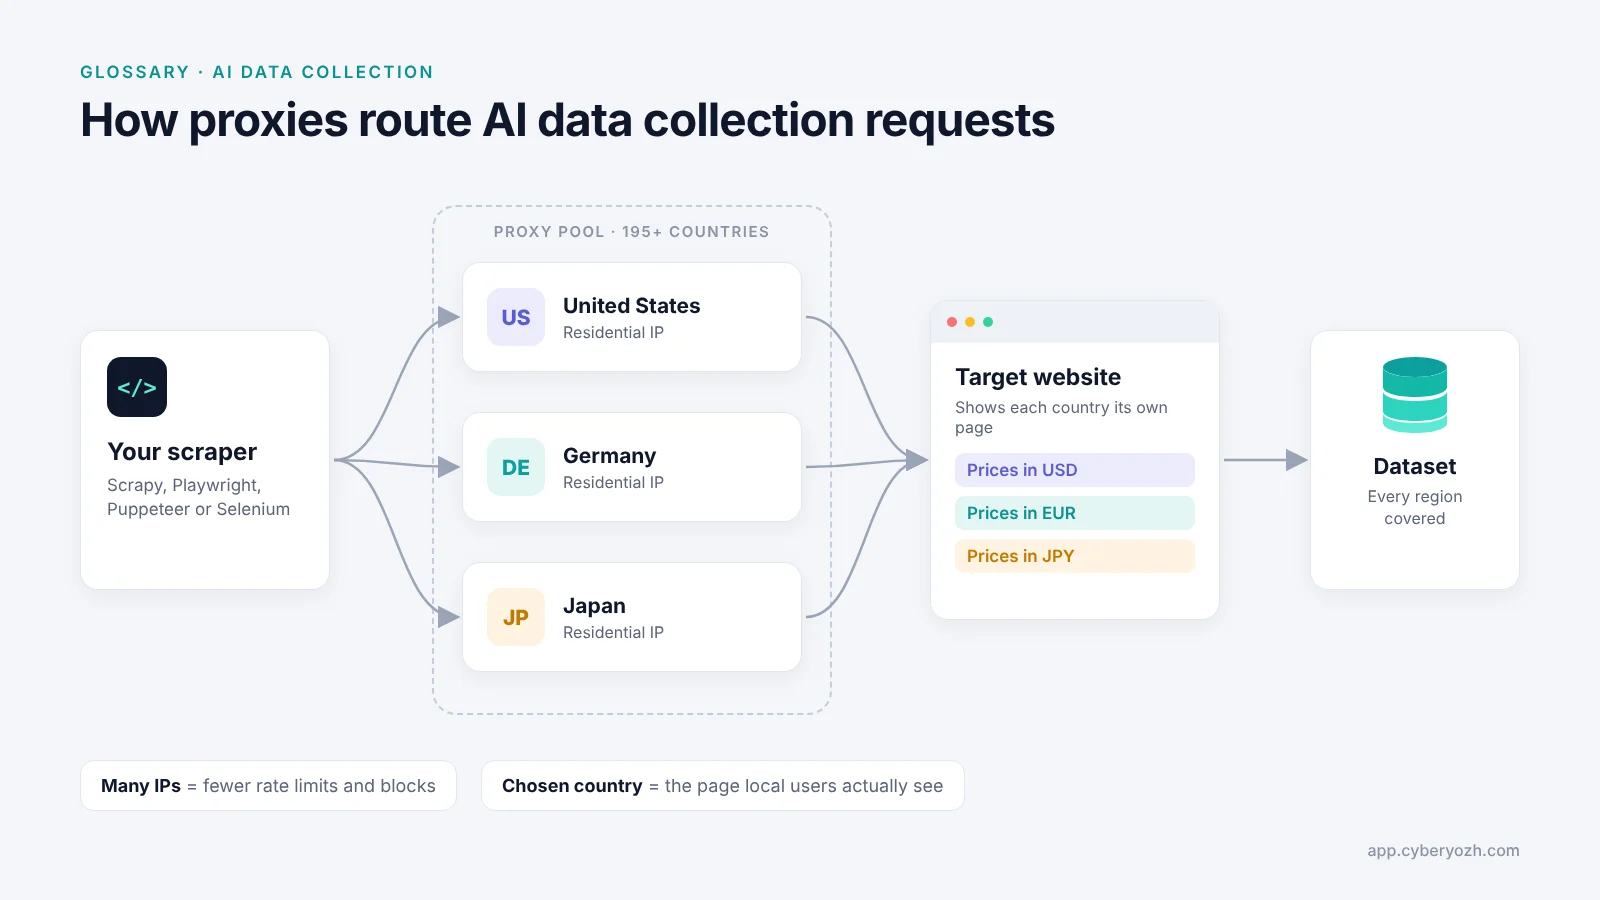
Вони потрібні лише для одного з шести методів: збору публічних веб-даних у великих обсягах. Якщо ви надішлете тисячі запитів з одної IP-адреси, сайти обмежать швидкість або заблокують вас протягом кількох хвилин. Крім того, ви побачите лише ту версію кожної сторінки, яка показується у вашій країні.
Проксі розподіляють запити між численними IP-адресами та дають змогу вибрати країну, з якої надсилається кожен запит. Ось як типи проксі CyberYozh підходять для типових завдань збору даних для ШІ:
Завдання збору даних | Оптимальний тип проксі | Ціна від |
Масштабний краулінг публічних сторінок | $2/ГБ | |
Високообсяговий збір даних із сайтів зі слабким захистом | Проксі датацентру, безлімітний трафік | $1.77/місяць (спільні) |
Сесії, що потребують збереження одного IP, наприклад, для посторінкових результатів | $5.29/місяць | |
Контент, доступний лише з мобільних пристроїв, і сайти з найсуворішим захистом | Переглянути каталог |
Понад 100 млн резидентських IP у 195+ країнах для збалансованих датасетів із точною геолокацією
Повний доступ до API з підтримкою Selenium, Playwright, Puppeteer та Scrapy
HTTP(S) і SOCKS5 для всіх типів проксі
Рейтинг 4.7+ «Відмінно» на Trustpilot
Порада профі: Прогоніть вибірку ваших IP через безкоштовний чекер IP Fraud Score від CyberYozh перед масштабним краулінгом. Заміна позначених адрес заздалегідь займе хвилини. Налагодження напівзаблокованого краулінга потім займе дні.
Налаштовуєте процес збору даних? Перегляньте наші проксі для збору даних для ШІабо порівняйте провайдерів у нашому огляді сервісів збору даних.
Збирайте чистіші та збалансовані за геолокацією дані. Перейти до каталогу проксі CyberYozh →