简要总结
AI 数据采集是为机器学习模型收集和准备数据的过程。
数据来自六种主要方法:网页抓取、API、第一方用户数据、传感器、现有数据集和合成数据。
原始数据在经过清理、去重和标注之前无法使用。
公开数据通常可以自由使用。个人数据和登录后的数据受法律限制。
快速解答: AI 数据采集是收集原始文本、图像、音频、视频或记录,并准备用于训练、测试和改进机器学习模型的过程。团队通过网页抓取、API、用户交互、传感器、公开数据集和合成生成来收集数据,然后在训练前进行清理和标注。
什么是 AI 数据采集
这是构建任何机器学习模型的第一步。模型只能从其样本中学习模式,因此您收集的数据决定了它能做什么以及在哪里失败。
它与普通数据收集的区别在于目标。销售报告需要准确的记录。模型需要 数量、多样性和平衡性:数千或数百万个涵盖其将面临的真实情况的样本,且不会让某一来源淹没其他来源。这就是为什么机器学习中的数据采集通常是一个持续的过程,而不是一次性导出。
它与训练数据相同吗
并不完全相同。训练数据是结果:模型学习的经过清理和标注的样本。采集是查找、收集和准备这些样本的工作。大多数团队还会保留单独的验证数据和测试数据,以便在模型未见过的样本上进行检查。
AI 如何收集数据
AI 不会自行收集数据。人员和流程使用六种主要方法来收集数据。
方法 | 收集内容 | 典型示例 |
网页抓取 和爬取 | 公开页面、列表、评论、文章 | 用于预测模型的价格数据 |
API | 平台选择共享的结构化数据 | 来自官方 API 的帖子或产品数据 |
第一方数据 | 点击、搜索、购买、客服聊天 | 商店自己的推荐引擎 |
传感器和设备 | 摄像头帧、GPS、可穿戴设备和机器读数 | 自动驾驶和工厂检测模型 |
现有数据集 | 开放或授权的集合 | 在公开图像集上训练图像模型 |
合成数据 | 由软件或其他模型生成的样本 | 真实数据缺乏的罕见欺诈案例 |
大多数生产模型结合了多种方法。客户支持聊天机器人可能会混合公司自己的聊天记录、公开帮助文章和涵盖罕见问题的合成对话。
AI 从哪里获取数据
最大的单一来源是公开网络。 Common Crawl是一个非营利组织,自 2007 年以来一直维护着免费、开放的网络爬取数据存档,研究人员在语言模型研究中广泛使用它。除此之外,AI 团队还利用:
授权内容: 新闻档案、书籍、库存图片和代码,通过付费协议使用
开放数据集: 发布供公众使用的研究集合
用户交互: 反馈、评分和对话,前提是产品的隐私条款允许
人工制作的数据: 编写、排序或标注示例的专家和标注员
生成式 AI 的训练数据主要依赖前两个来源的文本、代码和图像。较小的任务特定模型更多依赖公司自己的第一方数据。
专家见解: 大多数数据项目不会卡在爬取代码上。它们卡在被阻止的请求和不完整的覆盖率上。如果你的爬虫只能访问网站 70% 的页面,而在其余页面上静默失败,模型就会在无人察觉的情况下学习到有偏差的画面。
AI 收集哪些类型的数据
数据类型 | 示例 | 应用场景 |
结构化 | 价格、日期、交易、传感器读数 | 预测、定价和欺诈模型 |
非结构化 | 自由文本、图像、音频、视频 | 语言模型、计算机视觉、语音识别 |
半结构化 | JSON、XML、聊天记录、网页 | 聊天机器人、搜索排名、推荐系统 |
AI 数据收集流程是什么样的
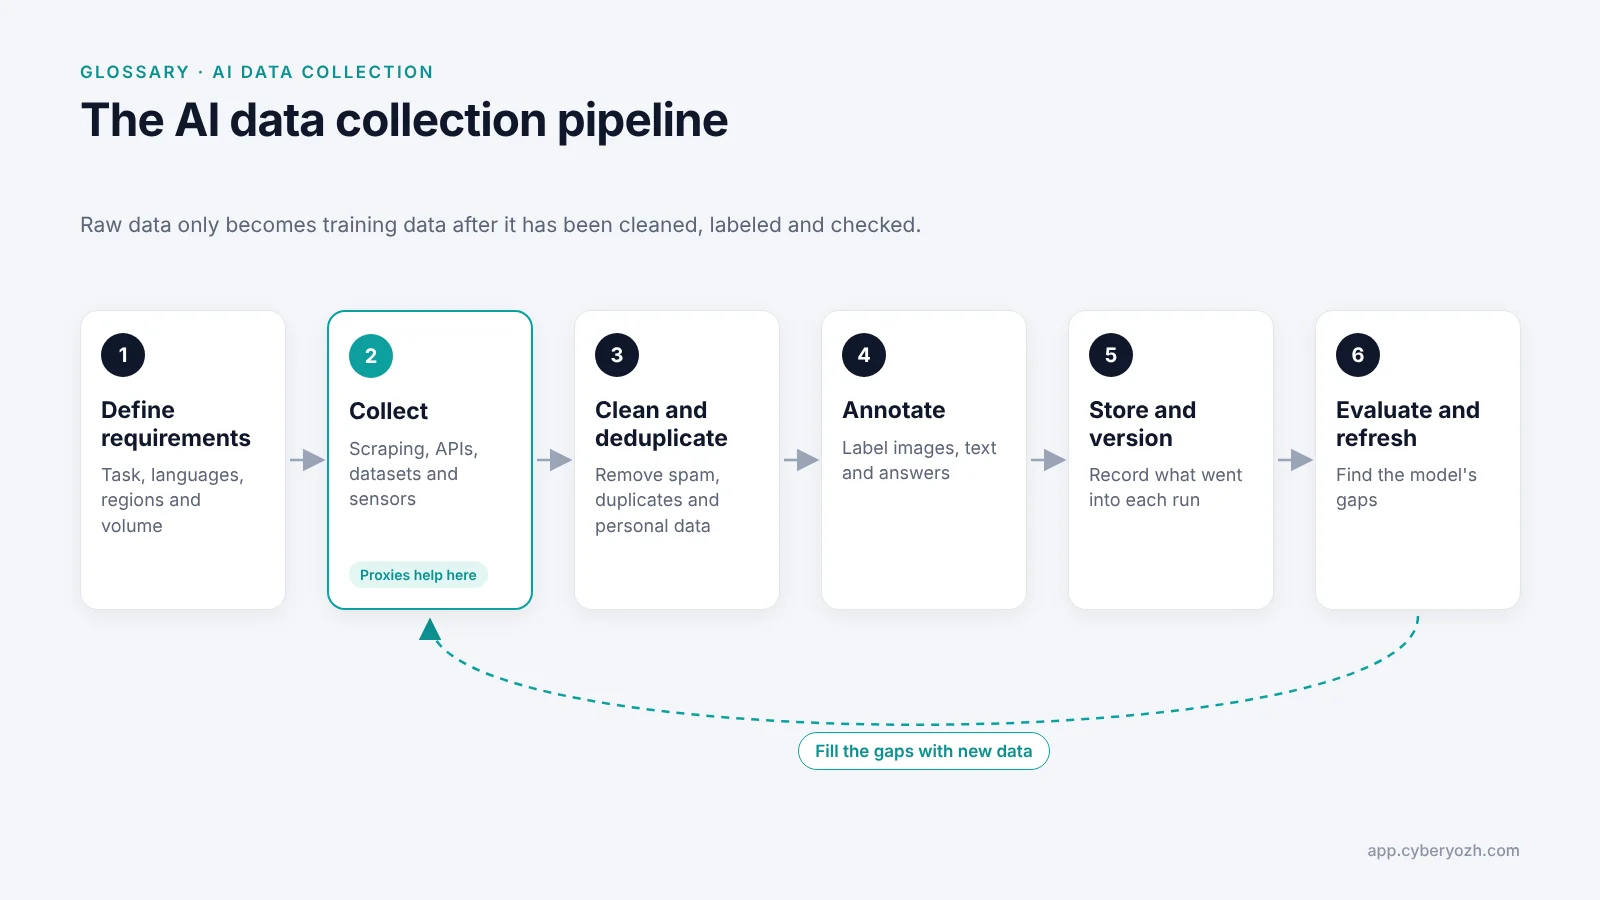
定义需求: 模型必须做什么、覆盖哪些语言或地区以及需要多少数据
收集: 运行爬虫、API 拉取和数据集下载
清理和去重: 删除损坏的页面、垃圾信息、近似重复内容以及不应保留的个人数据
标注: 在需要的地方标注示例,例如标记图像或评分答案
存储和版本管理: 记录每次训练运行中使用的内容
评估和更新: 检查模型,找出其不足并收集新数据来填补
数据收集和数据标注经常被混淆。收集是获取原始材料。标注是添加标签,告诉模型每个示例的含义。
常见错误: 仅从单一地点收集数据。价格、搜索结果甚至页面文本都会因国家而异。完全从美国IP地址抓取的数据集会让模型学习美国版本的网络,并将其当作整个网络。
AI数据收集是否合法
通常情况下,只要坚持使用公开数据并遵守隐私法就是合法的。最重要的三条界限:
公开与私密。 在长期进行的hiQ诉LinkedIn案中,美国上诉法院认为抓取公开可访问的页面可能不违反《计算机欺诈和滥用法》(EFF的案例摘要)。服务条款仍然可能产生合同索赔,这也是该争议最终对hiQ不利的原因。
个人数据。 姓名、照片和联系方式受隐私法保护,例如欧洲的GDPR和加州的CCPA,即使它们是公开可见的。
版权。 关于使用受版权保护作品训练模型的几起诉讼仍在进行中,因此使用已授权或开放许可的来源风险较小。
警告: 不要从登录后的页面收集数据或绕过网站的访问控制。这是法律风险最大的地方。本页面仅为一般信息,不构成法律建议,因此在大规模收集个人数据之前请咨询律师。
如需实用检查清单,请参阅我们的 道德网络抓取指南。
为什么网络数据收集需要代理
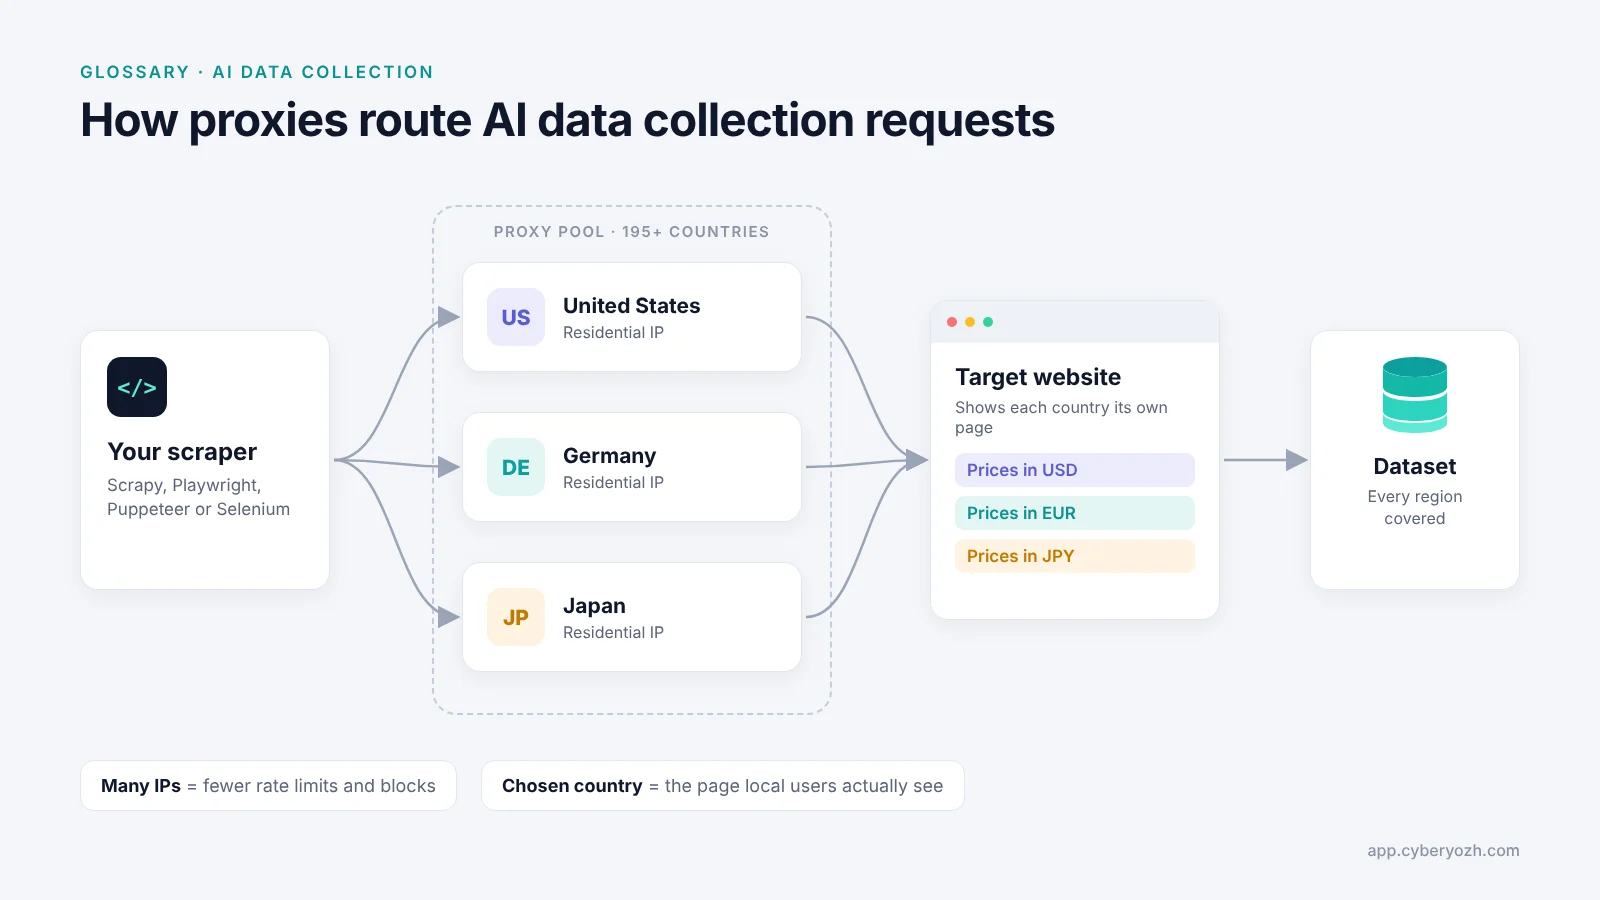
六种方法中只有一种需要代理: 大规模收集公开网络数据。如果从一个IP地址发送数千个请求,网站会在几分钟内对您进行速率限制或封禁。而且您只能看到针对您所在国家显示的页面版本。
代理将请求分散到多个 IP 地址,并让您选择每个请求的来源国家。以下是 CyberYozh 代理类型如何适配常见的 AI 数据采集任务:
采集任务 | 最佳代理类型 | 起始价格 |
大规模爬取公开页面 | $2/GB | |
从轻度保护站点进行大量采集 | 数据中心代理,无限流量 | $1.77/月(共享) |
必须保持单一 IP 的会话,例如分页结果 | $5.29/月 | |
仅限移动端内容和最严格的站点 | 查看目录 |
195+ 个国家的 1 亿+ 住宅 IP,用于均衡的、特定位置的数据集
完整 API 访问,支持 Selenium、Playwright、Puppeteer 和 Scrapy
HTTP(S) 和 SOCKS5,适用于所有代理类型
在 Trustpilot 上评分 4.7+ 优秀
专业提示: 在大规模爬取之前,通过 CyberYozh 的免费 IP 欺诈分数检查器 运行您的 IP 样本。提前更换被标记的地址只需几分钟。而在事后调试半阻塞的爬取则需要数天时间。
正在构建数据管道?查看我们的 AI 数据采集代理,或在我们的 数据采集服务综述中比较供应商。
采集更清洁、位置均衡的数据。 浏览 CyberYozh 代理目录 →