Un proxy para web scraping es un servidor que se sitúa entre tu scraper y los sitios web que visita, enviando solicitudes a través de otras direcciones IP. El sitio ve la IP del proxy en lugar de la tuya, por lo que puedes recopilar datos públicos a escala sin ser limitado por tasa o bloqueado.
Puntos clave
Un proxy para web scraping oculta tu IP real y distribuye las solicitudes a través de muchas direcciones
Los proxies residenciales, móviles, de datacenter e ISP se adaptan a diferentes objetivos
Un proxy mejora el anonimato del web scraping, pero no oculta tu huella digital del navegador por sí solo
¿Nuevo en el tema? Lee qué es el web scraping primero.
Cómo funciona un proxy para web scraping
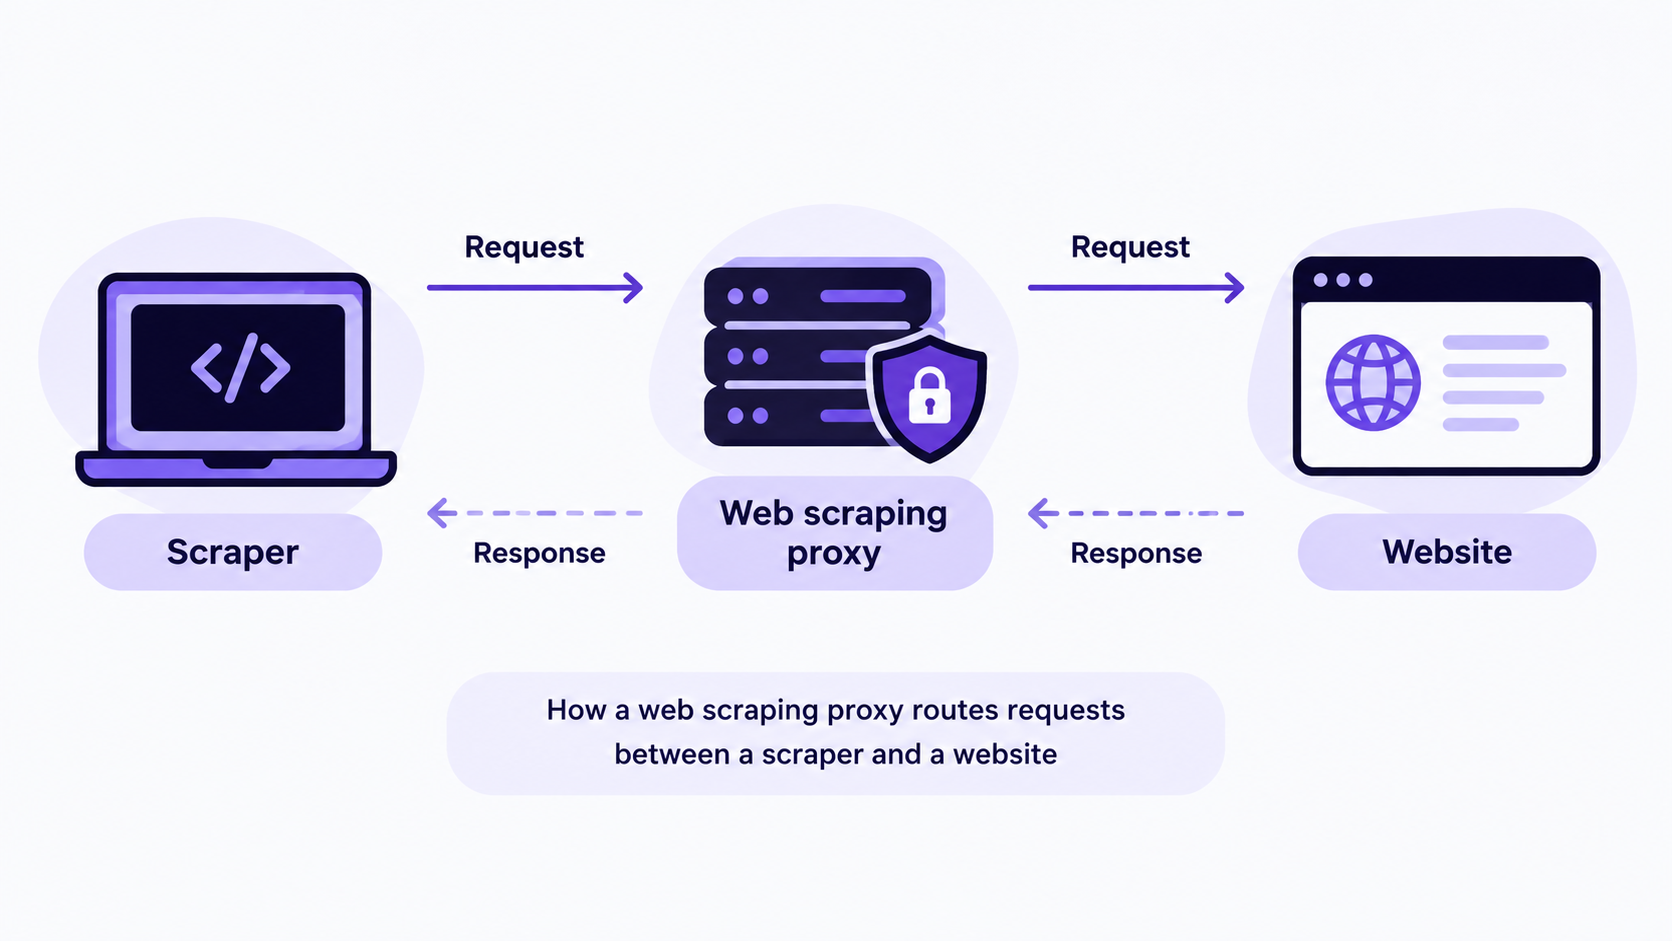
Tu scraper envía una solicitud al proxy, no al sitio web.
El proxy la reenvía desde una de sus propias direcciones IP, a menudo en el país o ciudad que elijas.
El sitio web responde al proxy, que devuelve los datos a tu scraper.
En código, suele ser una configuración adicional. Así es como se ve en Python:
import requests


proxy = "http://USERNAME:PASSWORD@PROXY_HOST:PORT"

r = requests.get("https://httpbin.org/ip", proxies={"http": proxy, "https": proxy}, timeout=30)

print(r.json())  # shows the proxy's IP, not yours
Los proxies rotativos usan una IP nueva para cada solicitud, mientras que las sesiones sticky mantienen una IP durante minutos u horas para que permanezcas conectado. Nuestra guía sobre rotación de direcciones IP explica cuándo usar cada una.
Por qué los scrapers son bloqueados sin un proxy
Los sitios web marcan el tráfico que no parece humano: demasiadas solicitudes desde una IP, rangos de datacenter conocidos o una zona horaria que no coincide con la IP. Los resultados son errores 403, muros de CAPTCHA y respuestas 429, que MDN define como «demasiadas solicitudes en un período de tiempo determinado». Si los CAPTCHAs son tu problema principal, consulta cómo los proxies ayudan con los CAPTCHAs.
Consejo profesional: Una IP limpia importa tanto como el tipo de proxy. Verifica su puntuación de fraude con el verificador de IP de CyberYozh antes de un trabajo grande.
Tipos de proxies para web scraping
Tipo | De dónde proviene la IP | Ideal para |
Proxies residenciales rotativos | Conexiones reales de internet doméstico | Sitios más protegidos, como e-commerce y motores de búsqueda |
Proxies móviles LTE/5G | Redes de operadores móviles | Sitios más estrictos y plataformas sociales |
Proxies de datacenter | Servidores en la nube | Datos públicos y sitios ligeramente protegidos |
Proxies residenciales estáticos (ISP) | IPs fijas de grado residencial | Sesiones con inicio de sesión y trabajos de monitoreo prolongados |
Compara proveedores en nuestra guía de los mejores proxies para web scraping.
Anonimato en web scraping: qué oculta un proxy y qué no
Un proxy oculta tu dirección IP real, proveedor de internet y ubicación. Esa es la base del anonimato en web scraping, pero los sitios web verifican mucho más que las IPs. Si cualquier otra señal te delata, los sitios aún pueden vincular y bloquear tus solicitudes.
Usa esta lista de verificación de cinco puntos:
Dirección IP: enruta cada solicitud a través de un proxy y haz coincidir su país con los datos que necesitas.
Huella digital del navegador: los sitios leen el tamaño de pantalla, fuentes y detalles del dispositivo. Usa un navegador real o headless con un perfil consistente y realista.
Cookies y sesiones: mantén las cookies separadas para cada sesión para que el bloqueo de una sesión no exponga a las demás.
Temporización de solicitudes: añade retrasos aleatorios. Las solicitudes enviadas a intervalos perfectamente uniformes parecen automatizadas.
Encabezados: envía un User-Agent realista y un Accept-Language que coincida con el país de tu proxy.
Error común: Asumir que un proxy por sí solo hace invisible a un scraper. Las huellas digitales idénticas y la temporización robótica aún pueden vincular tus solicitudes.
Cómo elegir un proxy para web scraping
Elige el tipo según el objetivo: residencial para sitios protegidos, datacenter para datos abiertos
Verifica las opciones de sesión: necesitarás tanto rotación como sesiones sticky
Busca herramientas que ahorren tiempo de configuración: un scraper gratuito e integraciones listas reducen días de tu configuración
Pruébalo gratis primero. El Yozh Scraper de código abierto de CyberYozh viene con presets listos para sitios como Amazon y Google. Sigue nuestra guía de configuración de Yozh Scraper para ejecutar tu primer scraping en minutos.
Haz scraping sin bloqueos. Obtén un proxy para web scraping de CyberYozh con más de 100M de IPs residenciales en más de 195 países y sesiones sticky de hasta 24 horas.