Зачем нужны прокси для сбора данных для ИИ
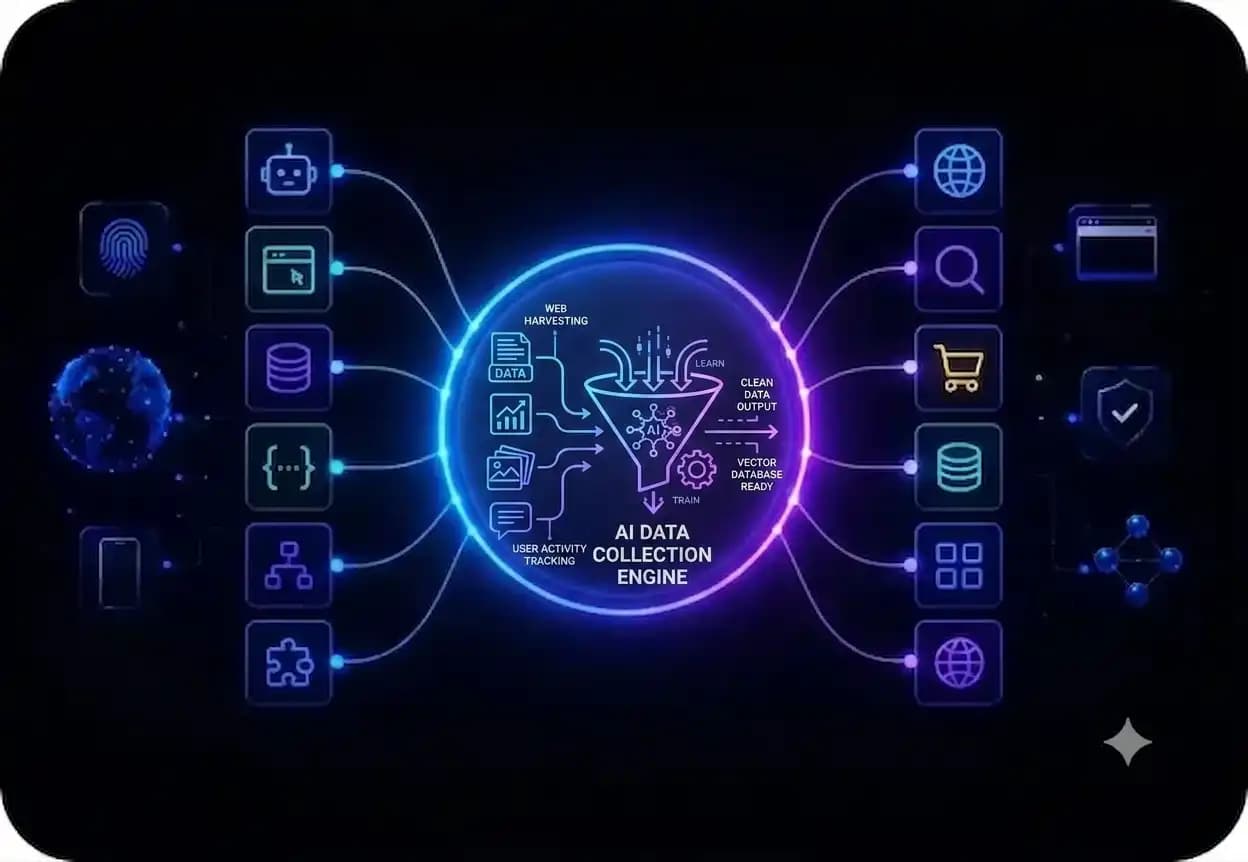
Прокси — это критически важная инфраструктура, которая обеспечивает вашему ИИ непрерывный поток свежих и разнообразных данных для решения задач. Независимо от того, разрабатываете ли вы приложения на базе ИИ, обучаете модели машинного обучения или отслеживаете цены конкурентов и позиции в поиске, вот что это даёт.
Меньше блокировок IP и ограничений по количеству запросов: сайты агрессивно блокируют IP-адреса, которые отправляют слишком много запросов. С ротационными IP вы сможете вести масштабный парсинг без остановок и блокировок со стороны антибот-защиты.
Доступ к локализованному контенту: прокси с геотаргетингом позволяют собирать локализованные результаты поиска, ленты соцсетей и региональные цены, давая вашей модели полную картину по регионам.
Обход антибот-защиты: современные сайты используют продвинутый фингерпринтинг и капчи. Премиальные прокси выглядят как настоящие пользователи, что позволяет проходить проверки и получать нужные данные.
Стабильность и масштабируемость: при сборе данных простои недопустимы. Надёжная прокси-сеть с балансировкой нагрузки поддерживает работу ваших процессов даже в периоды пиковой нагрузки.
Защита вашей инфраструктуры: прокси-серверы работают как буфер, защищая ваш исходный IP и внутренние системы от злоумышленников и юридических рисков.
Как прокси решают типичные проблемы при сборе данных для ИИ
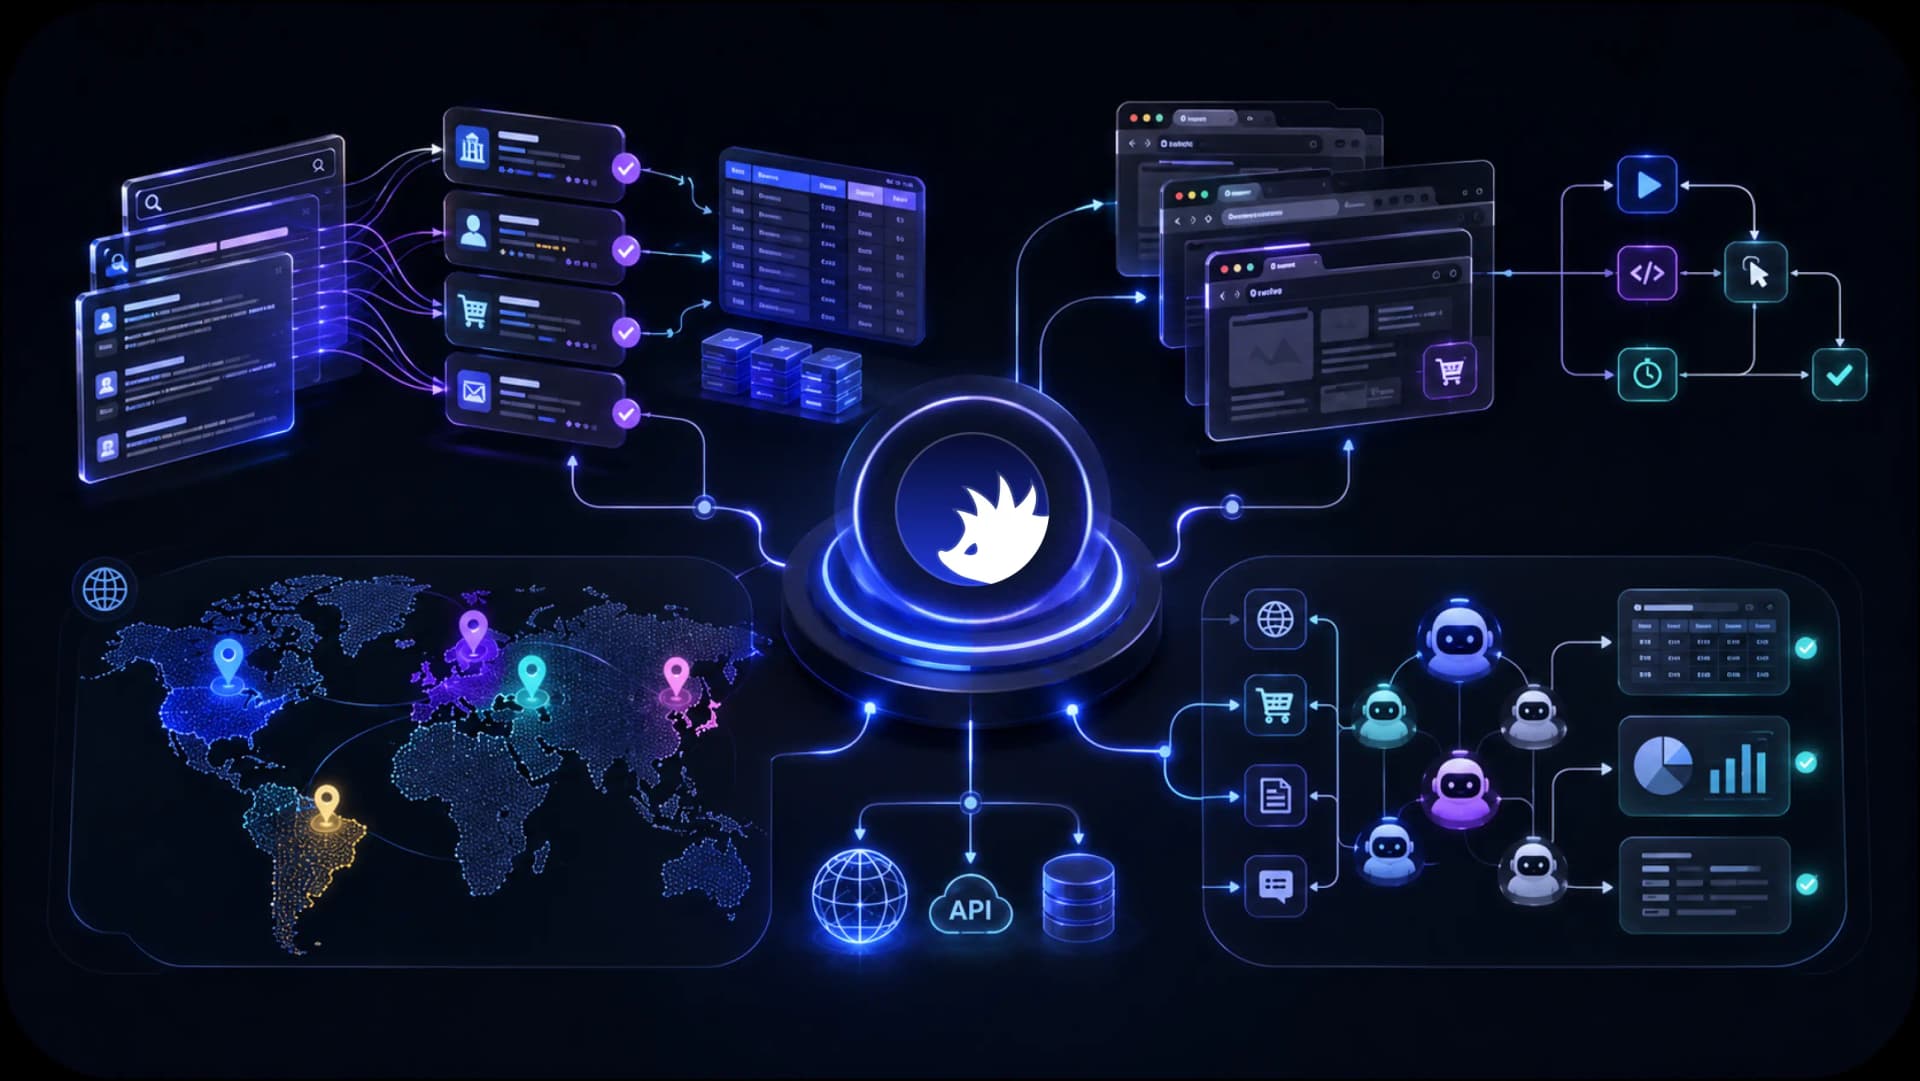
Разные сценарии сбора данных для ИИ требуют разной инфраструктуры — от локализованного сбора SERP до данных о ценах в реальном времени и браузерных ИИ-агентов.
Скрейпинг для обучения моделей ИИ
Команда, которая парсила миллионы веб-страниц для корпуса обучения LLM, столкнулась с лимитами запросов в течение нескольких часов на одном IP. Процессы остановились с неполными пакетами данных, а инженеры тратили дни на разблокировку адресов вместо разработки моделей. Они переключились на датацентровые прокси для сбора обучающих данных ИИ, распределив запросы по тысячам IP, чтобы оставаться ниже порогов обнаружения.
⚡ Результат: непрерывный парсинг на полной пропускной способности и выполнение ежедневных целей, чтобы инженеры могли вернуться к разработке моделей.
➡️
Не стройте инфраструктуру для парсинга с нуля
Yozh Scraper — бесплатный, с открытым исходным кодом, на базе Playwright — сочетает автоматизированное извлечение данных с прокси-сетью CyberYozh, так что вы контролируете тип прокси, GEO, ротацию и сессии в едином процессе.
→ Попробовать Yozh Scraper для сбора данных для ИИ
Сбор данных SERP без капч
Команда SEO-аналитики, отслеживающая позиции по ключевым словам в десятках стран, столкнулась с мгновенными капчами и непоследовательными геолокационными результатами от Google и Bing. Это привело к ненадёжным данным для клиентов и неправильным решениям. Они перешли на ротационные резидентские прокси для сбора данных SERP, распределив объём запросов по большому пулу IP.
⚡ Результат: точные данные SERP по странам в больших объемах с минимальными прерываниями из-за капчи и рейтинги, которым клиенты могли доверять.
📕
Работает через API: API CyberYozh дает полный программный контроль над ротацией и выбором страны/региона, интегрируясь напрямую в существующие стеки для парсинга — Scrapy, Playwright, Postman — без необходимости вручную управлять списками прокси.
Мониторинг цен без искажений
Движку динамического ценообразования требовалось отслеживать цены конкурентов в реальном времени на Amazon и Walmart, но платформы обнаруживали автоматизацию за считаные минуты, выдавая искаженные цены или блокируя IP. ИИ принимал решения на основе устаревших данных. Команда переключилась на ротационные резидентские прокси, благодаря чему запросы выглядели, будто их отправляют реальные местные покупатели.
⚡Результат: точные конкурентные цены в реальном времени для ИИ, что позволило мгновенно корректировать ставки и акции вместо того, чтобы реагировать на вчерашние данные.
Автоматизация агентов без блокировок в процессе выполнения задач
Команда, развернувшая браузерных ИИ-агентов для многошаговых задач (авторизация, формы, бронирование билетов), постоянно сталкивалась с блокировками в процессе работы. Сайты снимали фингерпринты фреймворков автоматизации и фиксировали изменения в паттернах запросов; обычной ротации IP было недостаточно. Команда использовала мобильные прокси для ИИ-агентов с высоким уровнем доверия и опциями фингерпринта ОС, что сохраняло стабильный цифровой профиль каждого агента.
⚡Результат: надежное выполнение многошаговых задач вместо постоянных сбоев.
RAG-поиск без устаревших ответов
Команда, использующая RAG-систему для финансовых исследований, постоянно получала старые или кешированные ответы вместо актуальных страниц. Они перенесли трафик поиска на ротационные резидентские прокси с короткими sticky-сессиями, чтобы каждый запрос получал свежее, некешированное представление исходной страницы.
⚡ Результат: ответы поиска отражали актуальное содержимое веб-страниц вместо кешей, а блокировки реже прерывали процесс.
⭐ Подробнее о прокси-сети для RAG
Масштабная агрегация контента без блокировок на отдельных сайтах
Команда, создающая агрегатор контента на базе ИИ, должна была собирать статьи, списки и спецификации товаров с сотен сайтов. Один тип прокси работал на одних сайтах и мгновенно блокировался на других, вынуждая инженеров поддерживать отдельные обходные решения. Они перешли на смешанную настройку прокси (датацентровые для открытых сайтов, ротационные резидентские для защищенных), маршрутизируемую через единый API, чтобы парсер мог переключать тип прокси для каждой цели.
⚡ Результат: единый процесс парсинга для всех источников, меньше правок для каждого сайта и стабильная поставка данных.
⭐ Узнайте больше о прокси для AI-скрейпинга
Какой тип прокси выбрать для задач сбора данных для ИИ
Не все прокси одинаковы. Каждый тип решает свою задачу в процессе сбора данных для ИИ:
Резидентские прокси для ИИ
Подходят для: сбора обучающих данных ИИ, а также для веб-исследований, мониторинга выдачи поисковых систем и отслеживания цен в e-commerce. Резидентские прокси также используются для машинного обучения.
Почему: Настоящие IP-адреса, назначенные интернет-провайдерами, с органическими паттернами просмотра обеспечивают высокий уровень доверия, что делает их эффективными против продвинутых антибот-систем вроде Cloudflare и DataDome.
Мобильные прокси для ИИ-процессов
Подходят для: данных из мобильных приложений, парсинга социальных платформ (Instagram, TikTok, X) и верификации рекламы.
Почему: IP-адреса мобильных операторов имеют самую высокую репутацию в сети. Мобильные IP редко попадают в чёрные списки, поскольку представляют реальные устройства пользователей.
Датацентровые прокси для ИИ
Подходят для: высокоскоростного сбора публичных данных, массового краулинга для обучения LLM и агрегации цен.
Почему: Серверы обеспечивают высокую пропускную способность при минимальной стоимости за запрос. Идеальны, когда объём важнее обхода агрессивных блокировщиков.
💡
Вывод для специалистов: Ротационные резидентские прокси — стандартный выбор для большинства задач сбора данных для AI. Они не только помогают избежать блокировок, но и добавляют географическое и поведенческое разнообразие в обучающие данные, улучшая обобщающую способность модели. Однако если вам нужны авторизованные сессии, выбирайте статичные резидентские или мобильные прокси.
Законен ли сбор данных для ИИ с помощью прокси
Да. Сбор публично доступных веб-данных для обучения ИИ, исследования рынка или мониторинга цен — это стандартная практика, а инфраструктура CyberYozh создана, чтобы поддерживать эту практику ответственно.
Перед началом сбора:
Проверьте условия использования источника и правила краулинга
Определите, содержатся ли в данных персональные сведения
Собирайте только то, что требуется для вашей задачи
Фиксируйте, где и когда данные были собраны.
Как построить процесс сбора данных для ИИ
Определите источники. Составьте список сайтов, API или платформ, с которых нужны данные, и отметьте, какие из них имеют географические ограничения, лимиты запросов или защиту от ботов.
Выберите тип прокси. Датацентровые — для скорости и объёма, резидентские — для сайтов с мощной антибот-защитой, мобильные — для целей с максимальным уровнем доверия.
Выберите геолокацию. Сопоставьте расположение прокси с регионами, которые обслуживают ваши источники, вплоть до уровня города, где важны локализованные результаты.
Настройте ротацию и сессии. Используйте ротацию на каждый запрос для высокообъёмного парсинга или сохраняйте sticky-сессию (до 24 часов), когда задаче нужна одна стабильная идентичность.
Подключитесь через API. Интегрируйте доступ к прокси в Scrapy, Playwright, Puppeteer или Selenium с программной ротацией и геотаргетингом — без ручного управления списками прокси.
Собирайте данные. Запустите процесс для определённых источников, используя настроенную прокси-конфигурацию.
Загрузите датасет. Направьте проверенные данные в процесс обучения ИИ или в приложение.
Как инфраструктура CyberYozh масштабирует сбор данных для ИИ
CyberYozh объединяет несколько типов прокси, глобальное покрытие и инструменты автоматизации, чтобы ИИ-команды могли подстроить инфраструктуру сбора под размер датасета, географию и требования задачи.
Ротационные резидентские прокси: более 100 млн резидентских IP в 195+ странах. Гибкая ротация, sticky-сессии до 24 часов и бесплатный геотаргетинг для стабильного сбора неискажённых данных.
Настоящие мобильные LTE/5G прокси (безлимитный трафик): собирайте мобильные или геозависимые данные через реальные сети операторов связи без переплаты за гигабайт.
Поддержка API и автоматизации: интеграция с процессами обработки данных ИИ, кастомными скриптами и инструментами, такими как Playwright, Puppeteer, Selenium, Postman и Scrapy.
Гибкая ротация: выбирайте между ротацией на каждый запрос и sticky-сессиями, чтобы адаптировать поведение сбора к разным датасетам и источникам.
Универсальная платформа с прокси, SMS-верификацией, виртуальными платёжными картами и инструментами проверки качества IP для комфортного масштабирования.
Оперативная поддержка клиентов 24/7 на 7 языках через e-mail и Telegram.