Коротко
Сбор данных для ИИ — это процесс получения и подготовки данных для обучения моделей машинного обучения.
Данные собирают шестью основными способами: скрейпинг веб-сайтов, API, собственные пользовательские данные, датчики, существующие датасеты и синтетические данные.
Сырые данные нельзя использовать, пока их не очистят, не удалят дубликаты и часто не разметят.
Публичные данные обычно можно использовать свободно. Персональные данные и данные за авторизацией имеют юридические ограничения.
Краткий ответ: Сбор данных для ИИ — это процесс получения сырого текста, изображений, аудио, видео или записей и их подготовки для обучения, тестирования и улучшения моделей машинного обучения. Команды собирают данные через скрейпинг веб-сайтов, API, взаимодействия с пользователями, датчики, публичные датасеты и синтетическую генерацию, затем очищают и размечают их перед обучением.
Что такое сбор данных для ИИ
Это первый шаг в создании любой модели машинного обучения. Модель может обучаться только на закономерностях в своих примерах, поэтому данные, которые вы собираете, определяют, что она сможет делать и где будет ошибаться.
Отличие от обычного сбора данных заключается в цели. Для отчёта о продажах нужны точные записи. Модели нужны объём, разнообразие и баланс: тысячи или миллионы примеров, которые охватывают реальные ситуации, с которыми она столкнётся, и при этом один источник не заглушает остальные. Поэтому сбор данных в машинном обучении обычно представляет собой непрерывный процесс, а не разовую выгрузку.
Это то же самое, что обучающие данные
Не совсем. Обучающие данные — это результат: очищенные, размеченные примеры, на которых учится модель. Сбор — это работа по поиску, получению и подготовке этих примеров. Большинство команд также откладывают отдельные валидационные и тестовые данные, чтобы проверить модель на примерах, которые она не видела.
Как ИИ собирает данные
ИИ не собирает данные самостоятельно. Их собирают люди и автоматизированные процессы, используя шесть основных методов.
Метод | Что собирает | Типичный пример |
Скрейпинг и краулинг веб-сайтов | Публичные страницы, списки, отзывы, статьи | Данные о ценах для модели прогнозирования |
API | Структурированные данные, которыми платформа решает поделиться | Посты или данные о товарах из официального API |
Собственные данные | Клики, поисковые запросы, покупки, чаты поддержки | Собственная рекомендательная система магазина |
Датчики и устройства | Кадры с камер, GPS, данные с носимых устройств и машин | Модели для беспилотных автомобилей и заводского контроля |
Существующие датасеты | Открытые или лицензионные коллекции | Обучение модели изображений на публичном наборе изображений |
Синтетические данные | Примеры, сгенерированные программным обеспечением или другими моделями | Редкие случаи мошенничества, которых нет в реальных данных |
Большинство промышленных моделей сочетают несколько методов. Чат-бот службы поддержки может использовать собственные логи чатов компании, публичные справочные статьи и синтетические диалоги, охватывающие редкие вопросы.
Откуда ИИ берёт данные
Основной источник — это публичный веб. Common Crawl— некоммерческая организация, которая с 2007 года ведёт бесплатный открытый архив данных веб-краулинга, широко используемый исследователями в области языковых моделей. Помимо этого, команды ИИ используют:
Лицензионный контент: архивы новостей, книги, стоковые изображения и код, используемые по платным соглашениям
Открытые датасеты: исследовательские коллекции, опубликованные для общего доступа
Пользовательские взаимодействия: отзывы, оценки и переписка — там, где это разрешено политикой конфиденциальности продукта
Данные, созданные людьми: эксперты и разметчики, которые пишут, ранжируют или размечают примеры
Обучающие данные для генеративного ИИ в основном опираются на текст, код и изображения из первых двух источников. Небольшие специализированные модели больше полагаются на собственные данные компании.
Экспертное мнение: Большинство проектов по сбору данных останавливаются не из-за кода скрейпера. Они буксуют из-за заблокированных запросов и неполного охвата. Если ваш краулер добирается до 70% страниц сайта, а на остальных молча падает, модель учится на искажённой картине, и никто этого не замечает.
Какие типы данных собирает ИИ
Тип данных | Примеры | Что это обеспечивает |
Структурированные | Цены, даты, транзакции, показания датчиков | Модели прогнозирования, ценообразования и обнаружения мошенничества |
Неструктурированные | Свободный текст, изображения, аудио, видео | Языковые модели, компьютерное зрение, распознавание речи |
Полуструктурированные | JSON, XML, логи чатов, веб-страницы | Чат-боты, ранжирование в поиске, рекомендательные системы |
Как выглядит процесс сбора данных для ИИ
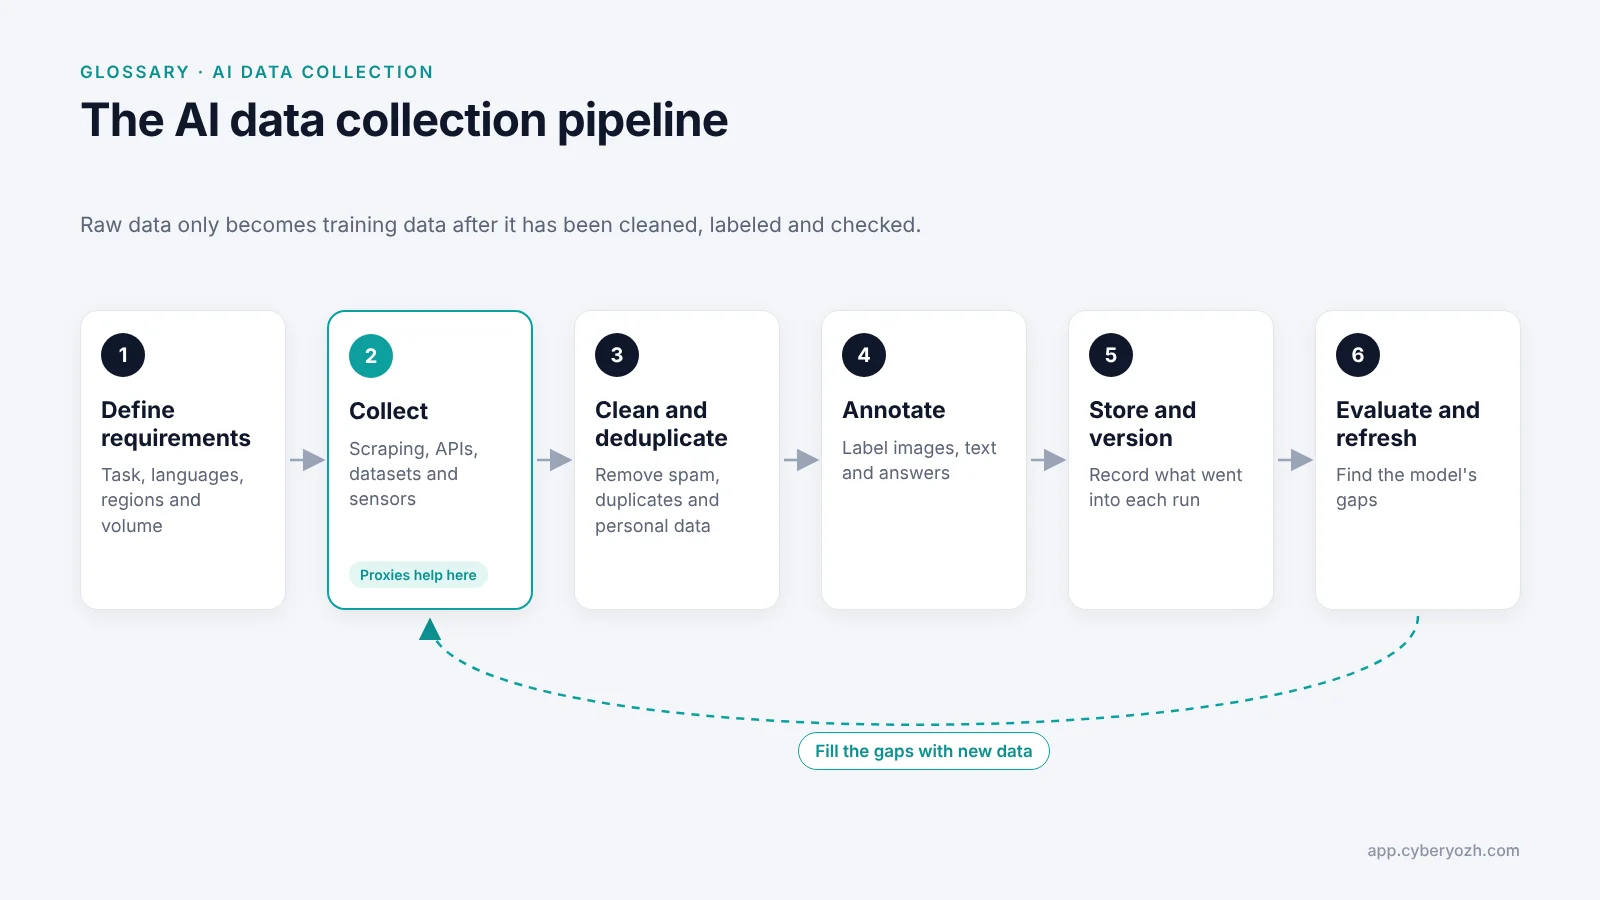
Определение требований: что должна делать модель, какие языки или регионы она охватывает и сколько данных ей нужно
Сбор: запуск скрейперов, выгрузка данных через API и загрузка датасетов
Очистка и дедупликация: удаление битых страниц, спама, почти дубликатов и персональных данных, которые не следует хранить
Разметка: разметка примеров там, где это необходимо, например, тегирование изображений или оценка ответов
Хранение и версионирование: ведение записи о том, что вошло в каждый запуск обучения
Оценка и обновление: проверяйте модель, находите её пробелы и собирайте новые данные, чтобы их заполнить
Сбор данных и аннотирование часто путают. Сбор — это получение исходного материала. Аннотирование добавляет метки, которые объясняют модели, что означает каждый пример.
Распространённая ошибка: Сбор данных только из одной локации. Цены, результаты поиска и даже текст страниц меняются в зависимости от страны. Датасет, полностью собранный с американских IP-адресов, учит модель американской версии интернета и выдаёт её за весь интернет.
Легален ли сбор данных для ИИ
Обычно да, если речь идёт о публичных данных и соблюдаются законы о конфиденциальности. Три момента имеют наибольшее значение:
Публичное и приватное. В деле hiQ против LinkedIn, которое длилось несколько лет, апелляционный суд США постановил, что скрейпинг общедоступных страниц, скорее всего, не нарушает Закон о компьютерном мошенничестве и злоупотреблениях (резюме дела от EFF). Условия использования всё ещё могут стать основанием для договорных претензий — именно так этот спор в итоге был решён не в пользу hiQ.
Персональные данные. Имена, фотографии и контактные данные подпадают под действие законов о конфиденциальности, таких как GDPR в Европе и CCPA в Калифорнии, даже если они находятся в публичном доступе.
Авторские права. Несколько судебных исков по поводу обучения моделей на материалах, защищённых авторским правом, всё ещё находятся на рассмотрении, поэтому лицензированные или открыто лицензированные источники несут меньший риск.
Внимание: Не собирайте данные из-за формы входа и не обходите средства контроля доступа сайта. Именно там сосредоточен основной юридический риск. Эта страница содержит общую информацию, а не юридическую консультацию, поэтому проконсультируйтесь с юристом, прежде чем собирать персональные данные в больших объёмах.
Практический чек-лист смотрите в нашем гайде по этичному веб-скрейпингу.
Зачем для сбора веб-данных нужны прокси
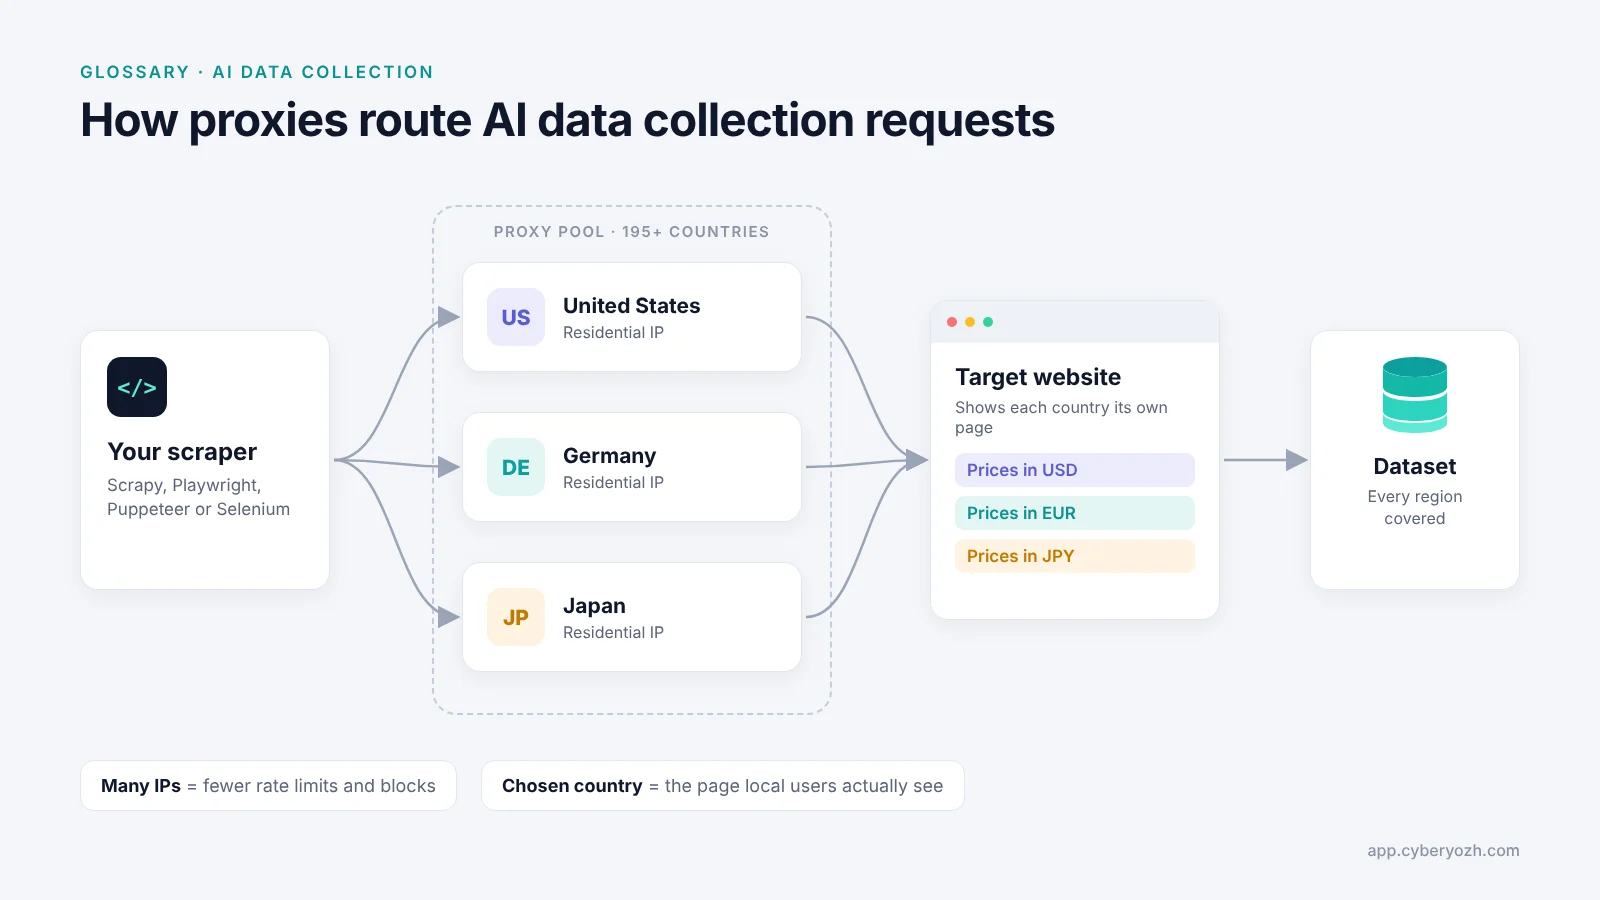
Они нужны только для одного из шести методов: сбора публичных веб-данных в больших объёмах. Если вы отправите тысячи запросов с одного IP-адреса, сайты ограничат скорость или заблокируют вас в течение нескольких минут. Кроме того, вы увидите только ту версию каждой страницы, которая показывается в вашей стране.
Прокси распределяют запросы по множеству IP-адресов и позволяют выбрать страну, из которой отправляется каждый запрос. Вот как типы прокси CyberYozh подходят для типичных задач сбора данных для ИИ:
Задача сбора данных | Оптимальный тип прокси | Цена от |
Масштабный краулинг публичных страниц | $2/ГБ | |
Высокообъёмный сбор данных с сайтов со слабой защитой | Датацентровые, безлимитный трафик | $1.77/месяц (совместные) |
Сессии, требующие сохранения одного IP, например, для постраничных результатов | $5.29/месяц | |
Контент, доступный только с мобильных устройств, и сайты с самой строгой защитой | Смотреть каталог |
Более 100 млн резидентских IP в 195+ странах для сбалансированных датасетов с точной геолокацией
Полный доступ к API с поддержкой Selenium, Playwright, Puppeteer и Scrapy
HTTP(S) и SOCKS5 для всех типов прокси
Рейтинг 4.7+ «Отлично» на Trustpilot
Совет профи: Прогоните выборку ваших IP через бесплатный чекер IP Fraud Score от CyberYozh перед масштабным краулингом. Замена помеченных адресов заранее займёт минуты. Отладка наполовину заблокированного краулинга потом займёт дни.
Настраиваете процесс сбора данных? Посмотрите наши прокси для сбора данных для ИИили сравните провайдеров в нашем обзоре сервисов сбора данных.
Собирайте более чистые и сбалансированные по геолокации данные. Перейти в каталог прокси CyberYozh →