Mạng di động LTE / 5G thực tế
Chạy các tác nhân AI qua mạng lưới nhà mạng thực với lưu lượng di động không giới hạn và các kênh chuyên dụng.
- Mạng nhà mạng LTE / 5G thực sự
- Xoay IP thủ công và qua API
- Môi trường có độ tin cậy cao
- Các phiên AI ổn định
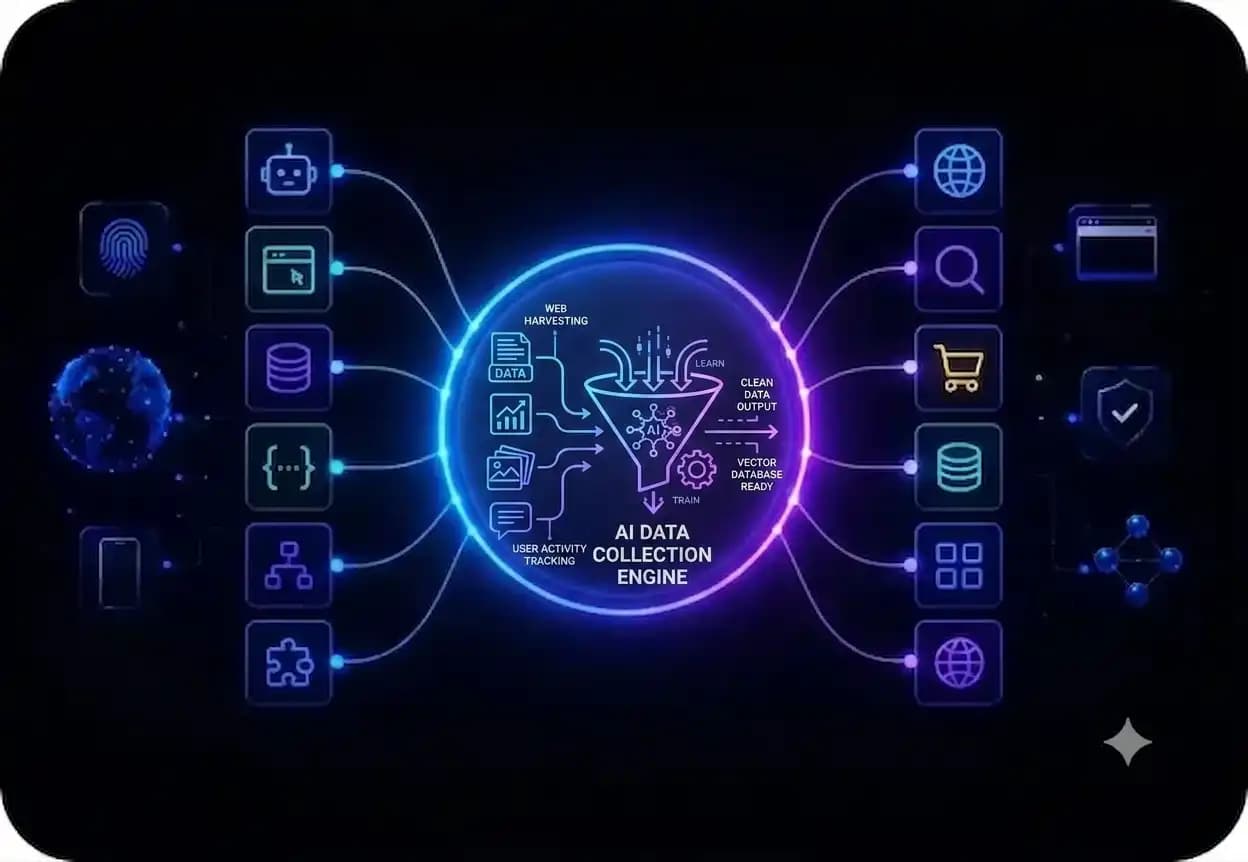
Cung cấp sức mạnh cho huấn luyện AI, pipeline RAG và nghiên cứu thị trường với hơn 100 triệu IP dân cư, di động LTE/5G và datacenter tại hơn 195 quốc gia. Nhắm mục tiêu cấp thành phố, xoay vòng linh hoạt và phiên sticky 24 giờ để giảm giới hạn tốc độ và yêu cầu bị chặn – giúp pipeline của bạn cung cấp dữ liệu khả dụng mà không cần giám sát liên tục.

Kết nối proxy với stack thu thập dữ liệu AI của bạn thông qua truy cập API để duy trì hoạt động của pipeline dữ liệu. Tương thích với Playwright, Puppeteer, Selenium, Scrapy và các script tùy chỉnh.

Thiết lập proxy và bắt đầu thu thập dữ liệu web mà không cần quản lý cơ sở hạ tầng phức tạp. Điều chỉnh hành vi thu thập dữ liệu với tính năng xoay vòng IP linh hoạt và phiên làm việc bền vững khi tập dữ liệu và khối lượng công việc của bạn tăng lên.

Proxy với khả năng nhắm mục tiêu chi tiết đến cấp thành phố và mã bưu điện cho phép bạn thu thập dữ liệu địa phương hóa mà không bị méo mó. Nhận dữ liệu web chính xác cho huấn luyện AI, nghiên cứu thị trường và giám sát giá cả.

Duy trì thu thập dữ liệu ổn định với các tùy chọn dấu vân tay hệ điều hành cùng với cơ sở hạ tầng proxy để duy trì tín hiệu thiết bị nhất quán. Giữ các thông số mạng phù hợp với cài đặt dấu vân tay và xác minh chất lượng IP trước khi chạy thu thập dữ liệu quy mô lớn.
Chạy các tác nhân AI qua mạng lưới nhà mạng thực với lưu lượng di động không giới hạn và các kênh chuyên dụng.

Giảm gián đoạn quy trình làm việc với hỗ trợ giải CAPTCHA và các công cụ xác thực được xây dựng cho tự động hóa.

Quản lý proxy, kích hoạt SMS, dấu vân tay trình duyệt, kiểm tra gian lận và tích hợp từ một môi trường duy nhất.
Hạ tầng proxy của CyberYozh cho phép thu thập dữ liệu quy mô lớn phục vụ huấn luyện AI, nghiên cứu thị trường và quy trình machine learning. Mạng lưới kết hợp hơn 100 triệu IP dân cư, proxy di động LTE/5G và proxy datacenter với khả năng nhắm mục tiêu chính xác, xoay vòng linh hoạt, phiên sticky kéo dài đến 24 giờ và công cụ xác minh IP. Với chất lượng IP được giám sát, tùy chọn fingerprinting và số ảo, CyberYozh cung cấp hạ tầng đáng tin cậy để thu thập dữ liệu không bị méo mó, giảm gián đoạn và mở rộng quy trình AI trên các thị trường toàn cầu.
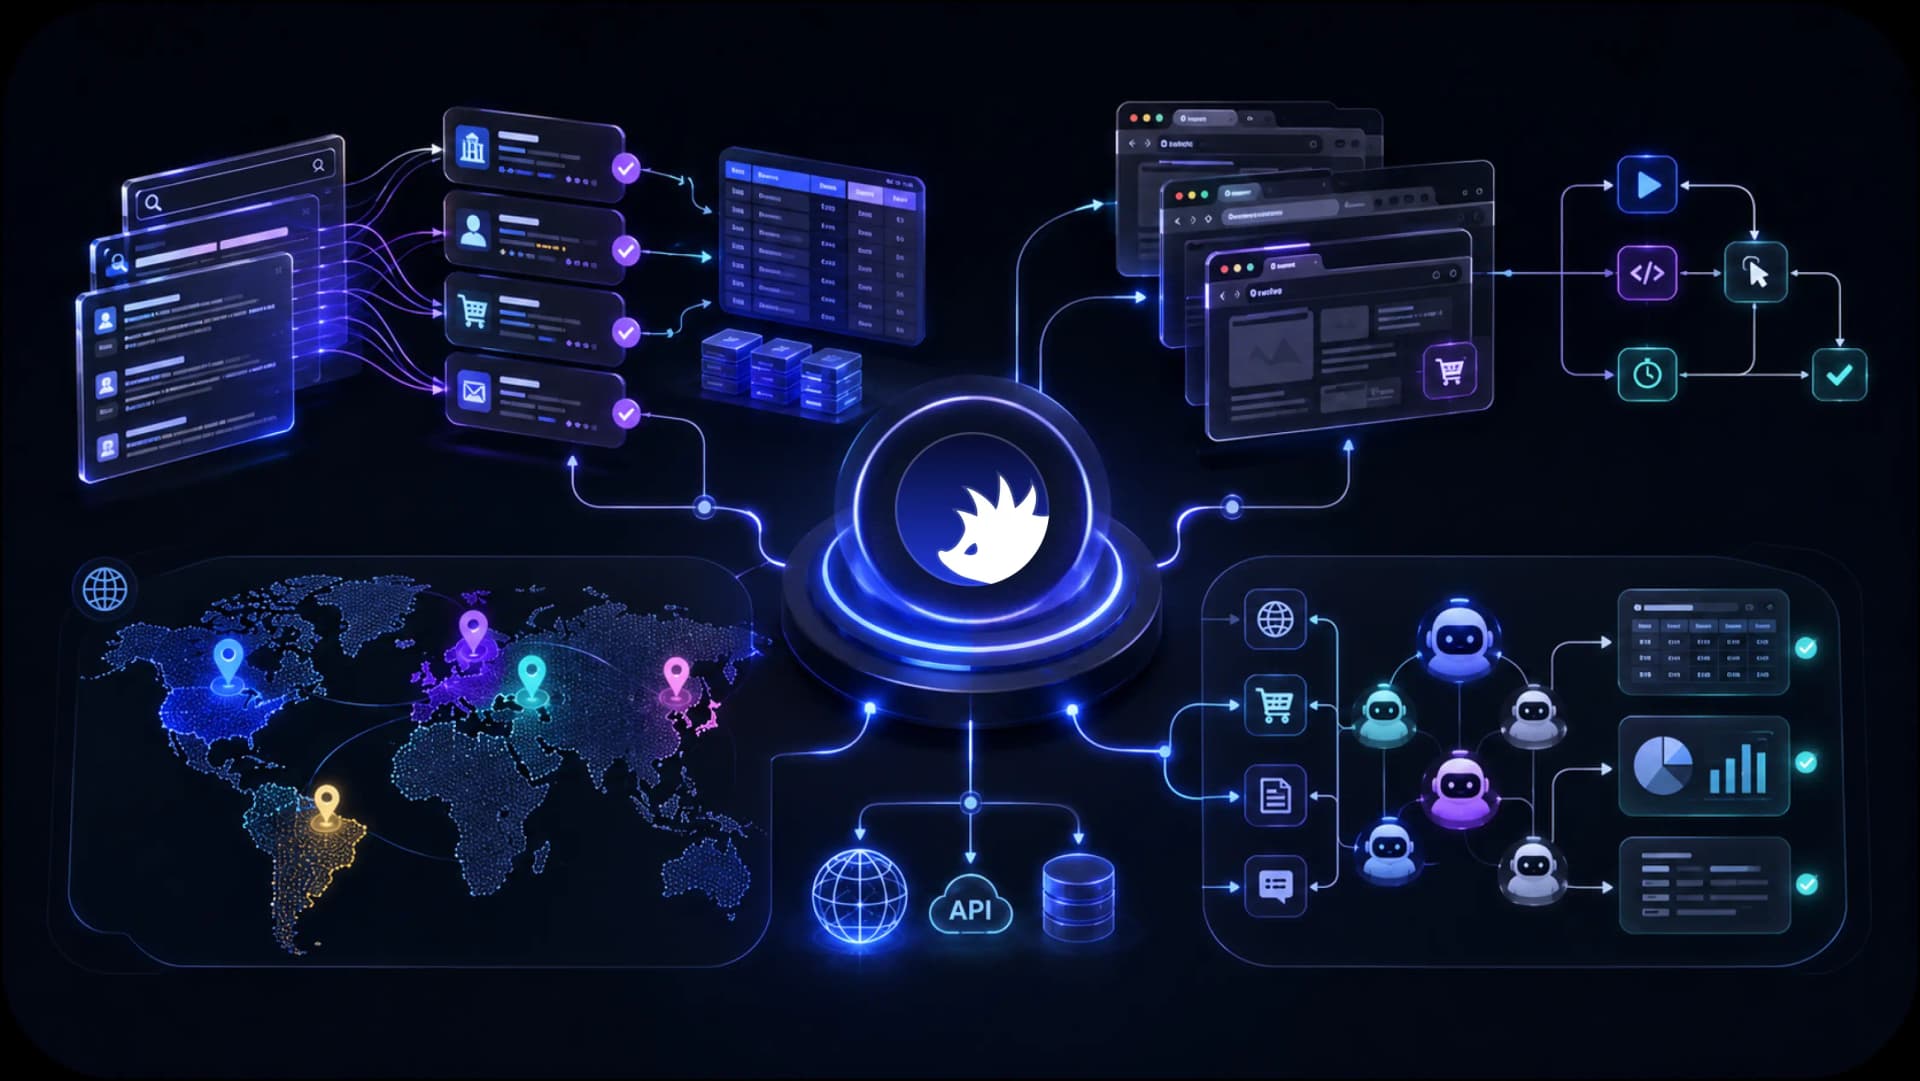
Truy cập kết quả tìm kiếm địa phương, các sàn thương mại điện tử, dữ liệu web công khai và nội dung khu vực tại hơn 195 quốc gia cho các tác nhân AI, hệ thống thu thập dữ liệu và quy trình tự động.
CyberYozh kết hợp cơ sở hạ tầng mà các nhóm AI cần để thu thập dữ liệu, tự động hóa quy trình làm việc, truy cập nội dung theo khu vực và mở rộng môi trường thực thi. Từ proxy di động LTE / 5G và proxy dân cư đến hỗ trợ tự động hóa trình duyệt, nhận diện dấu vân tay thiết bị, kiểm tra gian lận và điện thoại Android trên nền tảng đám mây, mọi thứ đều được thiết kế để hỗ trợ quy trình làm việc AI từ một nền tảng duy nhất.
Trích xuất dữ liệu web bằng AI
Tự động hóa trình duyệt bằng AI
Thu thập dữ liệu AI
Thực thi tác nhân AI
Quy trình làm việc AI trên thiết bị di động
Truy cập AI khu vực
Xem cách CyberYozh hoạt động trong thực tế thông qua các quy trình làm việc thực, tính năng nền tảng và ví dụ về hạ tầng. Khám phá bảng điều khiển, tích hợp, môi trường thực thi và các công cụ dành cho đội ngũ AI cũng như các dự án tự động hóa.
Proxy là cơ sở hạ tầng quan trọng đảm bảo AI của bạn nhận được luồng dữ liệu mới, đa dạng và không bị gián đoạn cho tác vụ của bạn. Cho dù bạn đang phát triển ứng dụng AI, huấn luyện mô hình machine learning hay giám sát giá cả đối thủ và thứ hạng tìm kiếm, đây là những gì nó giúp bạn đạt được.
Giảm lệnh cấm IP và giới hạn tốc độ: Các website chặn IP một cách quyết liệt khi gửi quá nhiều yêu cầu. Với IP luân phiên, bạn có thể chạy scraping khối lượng lớn không bị gián đoạn mà không kích hoạt hệ thống phòng thủ chống bot.
Truy cập nội dung địa phương hóa: Proxy với geo-targeting cho phép bạn thu thập kết quả tìm kiếm địa phương, nguồn cấp dữ liệu mạng xã hội và giá cả theo khu vực, mang lại cho mô hình của bạn góc nhìn toàn cầu thực sự.
Vượt qua biện pháp chống bot: Các website hiện đại sử dụng fingerprinting tiên tiến và CAPTCHA. Proxy cao cấp trông giống như người dùng thực đối với các nền tảng, đảm bảo bạn vượt qua các kiểm tra này và thu thập dữ liệu bạn cần.
Tính ổn định và khả năng mở rộng: Thu thập dữ liệu không thể chịu được thời gian ngừng hoạt động. Mạng lưới proxy mạnh mẽ với cân bằng tải giữ cho pipeline của bạn chạy ngay cả trong thời gian nhu cầu cao điểm.
Bảo vệ cơ sở hạ tầng của bạn: Máy chủ proxy hoạt động như một lớp đệm, che chắn IP gốc và hệ thống nội bộ của bạn khỏi các tác nhân độc hại và rủi ro pháp lý.
Các quy trình thu thập dữ liệu AI khác nhau tạo ra các yêu cầu cơ sở hạ tầng khác nhau, từ thu thập SERP địa phương hóa đến dữ liệu giá cả thời gian thực và AI agent dựa trên trình duyệt.
Một nhóm scraping hàng triệu trang web cho kho ngữ liệu huấn luyện LLM đã gặp giới hạn tốc độ trong vài giờ trên một IP duy nhất. Pipeline bị đình trệ với các lô không đầy đủ, và các kỹ sư lãng phí nhiều ngày để mở khóa địa chỉ thay vì xây dựng mô hình. Họ chuyển sang datacenter proxy dữ liệu huấn luyện AI, phân tán yêu cầu trên hàng nghìn IP để duy trì dưới ngưỡng phát hiện.
⚡ Kết quả: scraping liên tục với thông lượng đầy đủ, đạt mục tiêu hàng ngày và thời gian kỹ thuật quay trở lại phát triển mô hình.
Yozh Scraper — miễn phí, mã nguồn mở, dựa trên Playwright — kết hợp trích xuất tự động với mạng lưới proxy của CyberYozh, để bạn kiểm soát loại proxy, GEO, luân phiên và phiên trong một quy trình.
Một nhóm phân tích SEO theo dõi thứ hạng từ khóa trên hàng chục quốc gia gặp phải CAPTCHA ngay lập tức và kết quả geo không nhất quán từ Google và Bing. Điều này dẫn đến dữ liệu khách hàng không đáng tin cậy và quyết định kém. Họ chuyển sang residential luân phiên proxy cho thu thập dữ liệu SERP phân phối khối lượng truy vấn trên một pool IP lớn.
⚡ Kết quả: dữ liệu SERP chính xác theo từng quốc gia ở quy mô lớn với sự gián đoạn CAPTCHA tối thiểu và thứ hạng mà khách hàng có thể tin tưởng.
Hỗ trợ bởi API: API của CyberYozh cung cấp khả năng kiểm soát lập trình trực tiếp đối với rotation và targeting quốc gia/khu vực, tích hợp ngay vào các scraping stack hiện có như Scrapy, Playwright hoặc Postman — không cần quản lý danh sách proxy thủ công.
Một hệ thống định giá động cần giám sát giá đối thủ theo thời gian thực từ Amazon và Walmart, nhưng các nền tảng phát hiện automation trong vòng vài phút, hiển thị giá bị méo mó hoặc chặn IP. AI đưa ra quyết định dựa trên dữ liệu cũ. Họ chuyển sang rotating residential proxy, làm cho các request trông giống như người mua sắm địa phương thực sự.
⚡Kết quả: định giá cạnh tranh chính xác theo thời gian thực cho AI, cho phép điều chỉnh giá thầu và khuyến mãi ngay lập tức thay vì phản ứng với các con số của ngày hôm qua.
Một team triển khai AI agent dựa trên trình duyệt cho các tác vụ nhiều bước (đăng nhập, biểu mẫu, đặt vé máy bay) liên tục bị chặn giữa chừng. Các trang web fingerprint các framework automation và gắn cờ các request pattern thay đổi; IP rotation cơ bản không đủ để hoàn thành toàn bộ workflow. Họ sử dụng mobile proxy cho AI agent độ tin cậy cao với các tùy chọn OS fingerprint, cung cấp cho mỗi agent một danh tính ổn định cho mỗi tác vụ.
⚡Kết quả: hoàn thành nhiều bước đáng tin cậy và tỷ lệ thành công thay thế cho việc thử lại liên tục và thất bại.
Một team chạy hệ thống RAG cho nghiên cứu tài chính liên tục hiển thị các câu trả lời cũ hoặc được cache thay vì các trang trực tiếp. Họ chuyển lưu lượng retrieval sang rotating residential proxy với sticky session ngắn, để mỗi truy vấn lấy được view mới, không cache của trang nguồn.
⚡ Kết quả: các phản hồi retrieval phản ánh nội dung web hiện tại thay vì cache, với ít block làm gián đoạn pipeline hơn.
⭐ Đọc thêm về mạng lưới RAG proxy
Một team xây dựng content aggregator hỗ trợ AI cần lấy bài viết, danh sách và thông số kỹ thuật sản phẩm từ hàng trăm trang web. Một loại proxy duy nhất hoạt động trên một số trang và bị chặn ngay lập tức trên các trang khác, buộc các kỹ sư phải duy trì các giải pháp thay thế riêng biệt. Họ chuyển sang thiết lập proxy hỗn hợp (datacenter cho các trang cho phép, rotating residential cho các trang được bảo vệ) được định tuyến qua một API duy nhất để scraper có thể chuyển đổi loại proxy cho mỗi target.
⚡ Kết quả: một pipeline scraping duy nhất cho tất cả các nguồn, với ít sửa chữa bảo trì từng trang hơn và phân phối dữ liệu nhất quán.
⭐ Tìm hiểu thêm về proxy web scraping cho AI
Không phải tất cả các proxy đều được xây dựng giống nhau. Mỗi loại phục vụ một mục đích riêng biệt trong pipeline dữ liệu AI:
Phù hợp nhất cho: Hoạt động như proxy dữ liệu huấn luyện AI và cũng dùng cho nghiên cứu web, theo dõi SERP, và giám sát thương mại điện tử. Proxy residential cho machine learning cũng là một lựa chọn phổ biến.
Tại sao: IP thực được ISP cấp phát với các mẫu duyệt web tự nhiên cung cấp điểm tin cậy cao hơn, giúp chúng hiệu quả chống lại các hệ thống chống bot tinh vi như Cloudflare và DataDome.
Phù hợp nhất cho: Dữ liệu ứng dụng di động, scraping nền tảng mạng xã hội (Instagram, TikTok, X), và xác minh quảng cáo.
Tại sao: IP do nhà mạng cấp phát có uy tín mạng mạnh nhất. IP mobile hiếm khi bị đưa vào danh sách đen vì chúng đại diện cho các thiết bị người tiêu dùng thực tế với các cell mạng luân phiên.
Phù hợp nhất cho: Tốc độ cao thu thập dữ liệu công khai, crawling hàng loạt cho huấn luyện LLM, và tổng hợp giá cả.
Tại sao: Máy chủ cung cấp thông lượng nhanh với chi phí thấp nhất mỗi yêu cầu. Lý tưởng khi khối lượng quan trọng hơn việc né tránh các trình chặn mạnh.
Lưu ý cho người vận hành: Proxy residential luân phiên là lựa chọn mặc định cho hầu hết các tác vụ thu thập AI — không chỉ để tránh bị chặn, mà còn để đưa sự đa dạng về địa lý và hành vi vào dữ liệu huấn luyện của bạn, cải thiện khả năng tổng quát hóa của mô hình. Tuy nhiên, nếu bạn cần các phiên đăng nhập, hãy chọn residential tĩnh hoặc mobile.
Có. Thu thập dữ liệu web công khai cho huấn luyện AI, nghiên cứu thị trường, hoặc giám sát giá cả là thực tiễn tiêu chuẩn, và cơ sở hạ tầng của CyberYozh được xây dựng để hỗ trợ điều đó một cách có trách nhiệm.
Trước khi thu thập:
Kiểm tra Điều khoản Dịch vụ và quy tắc crawling của nguồn
Xác định liệu dữ liệu cá nhân có liên quan hay không
Chỉ thu thập những gì trường hợp sử dụng của bạn yêu cầu
Theo dõi nơi và thời điểm dữ liệu được thu thập.
Xác định nguồn dữ liệu của bạn. Liệt kê các trang web, API hoặc nền tảng mà bạn cần thu thập dữ liệu và ghi chú những nguồn nào bị hạn chế theo vùng địa lý, giới hạn tốc độ hoặc được bảo vệ chống bot.
Chọn loại proxy của bạn. Datacenter cho tốc độ và khối lượng, residential cho các trang web có hệ thống chống bot mạnh, mobile cho các mục tiêu đáng tin cậy nhất.
Chọn vị trí địa lý (GEO). Khớp vị trí proxy với các khu vực mà nguồn dữ liệu của bạn phục vụ, xuống đến cấp thành phố nơi kết quả địa phương hóa quan trọng.
Cấu hình rotation và session. Rotation theo từng request cho scraping khối lượng lớn, hoặc giữ sticky session (lên đến 24 giờ) khi một tác vụ cần một danh tính nhất quán.
Kết nối qua API. Tích hợp quyền truy cập proxy vào Scrapy, Playwright, Puppeteer, hoặc Selenium với rotation theo chương trình và nhắm mục tiêu GEO, không cần quản lý danh sách proxy thủ công.
Thu thập. Chạy pipeline đối với các nguồn đã xác định của bạn bằng cách sử dụng cấu hình proxy đã thiết lập.
Cung cấp dataset. Chuyển dữ liệu đã xác thực vào pipeline huấn luyện AI hoặc ứng dụng của bạn.
CyberYozh kết hợp nhiều loại proxy, phủ sóng toàn cầu và các điều khiển sẵn sàng tự động hóa để các nhóm AI có thể khớp cơ sở hạ tầng thu thập của họ với kích thước dataset, vị trí địa lý và yêu cầu quy trình làm việc.
Residential rotating proxies: Hơn 100 triệu IP residential trên hơn 195 quốc gia. Rotation linh hoạt, sticky session 24 giờ và nhắm mục tiêu địa lý miễn phí để thu thập dữ liệu không bị méo mó một cách nhất quán.
Proxy mobile LTE/5G thực (băng thông không giới hạn): Thu thập dữ liệu dành riêng cho mobile hoặc phụ thuộc vào vị trí thông qua mạng nhà mạng thực mà không phải trả quá nhiều cho mỗi GB.
Hỗ trợ API và tự động hóa: Tích hợp với các pipeline dữ liệu AI, script tùy chỉnh và các công cụ như Playwright, Puppeteer, Selenium, Postmanvà Scrapy.
Rotation linh hoạt: chọn giữa rotation theo từng request và sticky session để điều chỉnh hành vi thu thập cho các dataset và nguồn khác nhau.
Nền tảng tất cả trong một với proxy, xác minh SMS, thẻ thanh toán ảo và các công cụ kiểm tra chất lượng IP để mở rộng quy mô thuận tiện.
Hỗ trợ khách hàng nhanh chóng 24/7 bằng 7 ngôn ngữ qua e-mail và Telegram.