Mạng di động LTE / 5G thực tế
Chạy các tác nhân AI qua mạng lưới nhà mạng thực với lưu lượng di động không giới hạn và các kênh chuyên dụng.
- Mạng nhà mạng LTE / 5G thực sự
- Xoay IP thủ công và qua API
- Môi trường có độ tin cậy cao
- Các phiên AI ổn định

Sở hữu hơn 100 triệu proxy residential, proxy di động LTE/5G và proxy datacenter sạch để thu thập dataset cho AI, huấn luyện LLM và xây dựng pipeline RAG. Nhắm mục tiêu chính xác đến cấp thành phố và mã ZIP tại hơn 195 quốc gia để có kết quả đáng tin cậy với tỷ lệ thành công 99.9%. Xoay IP có kiểm soát hoặc sticky session giúp bạn thu thập dữ liệu huấn luyện AI với ít CAPTCHA và giới hạn tốc độ hơn.
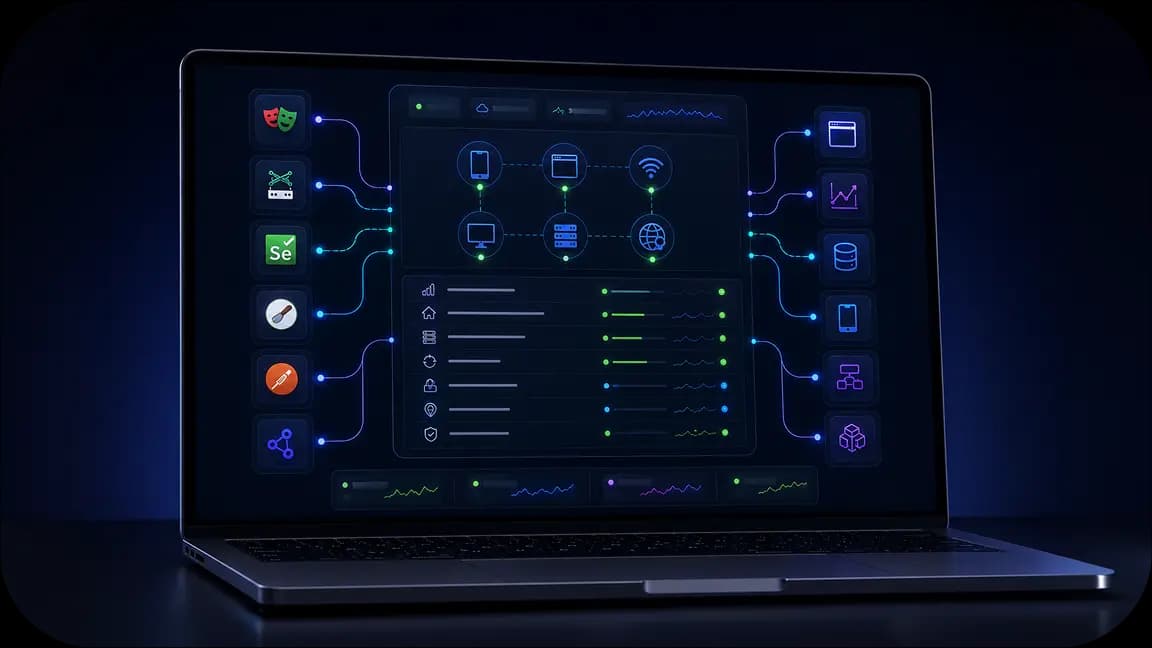
Kết nối proxy trực tiếp với stack thu thập dữ liệu của bạn để xây dựng kho ngữ liệu huấn luyện quy mô lớn. Tích hợp API với Playwright, Puppeteer, Selenium, Scrapy và các script scraping tùy chỉnh.
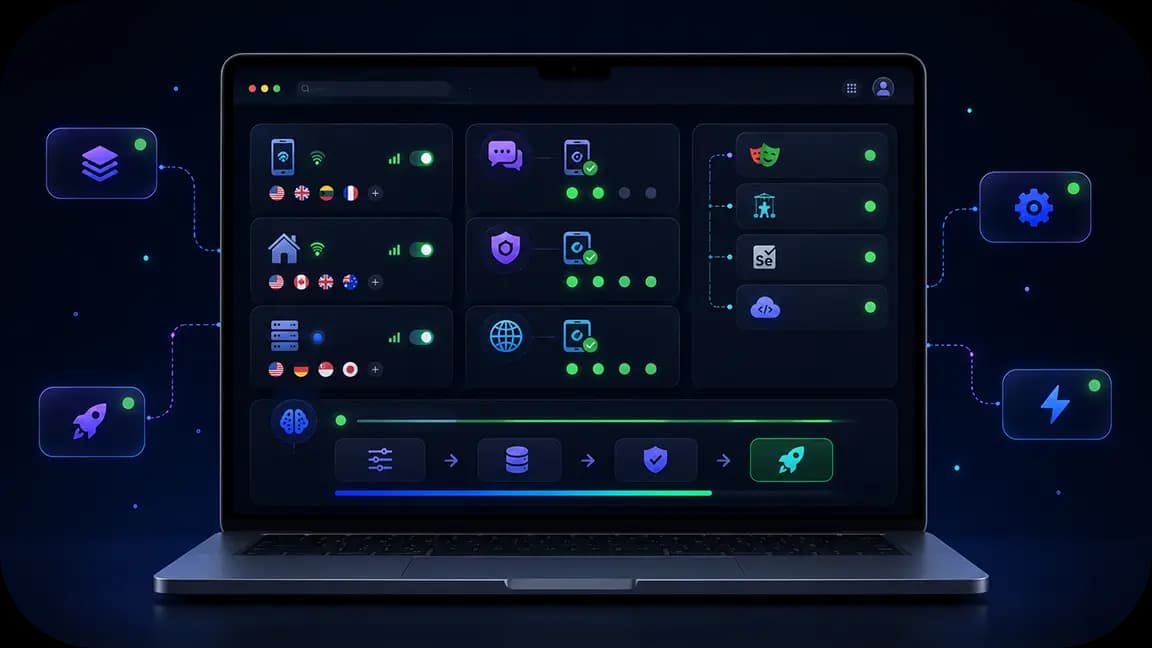
Thiết lập proxy cho web scraping phục vụ RAG hoặc thu thập dataset AI chỉ với vài bước. Kiểm soát xoay IP và sticky sessions từ một dashboard thân thiện với người mới, đồng thời tạo hàng loạt thông tin xác thực để mở rộng theo quy mô dataset và mức độ đa dạng của nguồn dữ liệu.
Thu thập dữ liệu web để huấn luyện LLM và gom dữ liệu đa ngôn ngữ từ hơn 195 quốc gia bằng residential proxy, với khả năng nhắm mục tiêu chi tiết đến cấp thành phố và mã zip. Xây dựng các bộ dữ liệu huấn luyện chính xác, phản ánh đúng sự đa dạng thực tế trên toàn cầu.
Proxy CyberYozh bao gồm các tùy chọn chuyển đổi dấu vân tay hệ điều hành để căn chỉnh hồ sơ thiết bị của bạn với từng IP. Kiểm tra IP của bạn về điểm số gian lận trước khi chạy quy trình làm việc để giảm CAPTCHA và giảm yêu cầu bị chặn.
Chạy các tác nhân AI qua mạng lưới nhà mạng thực với lưu lượng di động không giới hạn và các kênh chuyên dụng.

Giảm gián đoạn quy trình làm việc với hỗ trợ giải CAPTCHA và các công cụ xác thực được xây dựng cho tự động hóa.

Quản lý proxy, kích hoạt SMS, dấu vân tay trình duyệt, kiểm tra gian lận và tích hợp từ một môi trường duy nhất.
CyberYozh App cung cấp hạ tầng proxy ổn định cho việc thu thập dữ liệu huấn luyện AI quy mô lớn. Nền tảng kết hợp hơn 100 triệu IP residential, mạng di động LTE/5G thật và proxy datacenter, cùng khả năng nhắm mục tiêu chi tiết, sticky session, chuyển đổi fingerprint hệ điều hành, kiểm tra gian lận IP và số ảo. Bạn có thể thu thập kho dữ liệu tiền huấn luyện, xây dựng bộ dữ liệu tinh chỉnh theo từng lĩnh vực hoặc lấy dữ liệu từ nhiều khu vực mà ít gặp CAPTCHA hơn và quy trình ít bị gián đoạn hơn.
Truy cập kết quả tìm kiếm địa phương, các sàn thương mại điện tử, dữ liệu web công khai và nội dung khu vực tại hơn 195 quốc gia cho các tác nhân AI, hệ thống thu thập dữ liệu và quy trình tự động.
CyberYozh kết hợp cơ sở hạ tầng mà các nhóm AI cần để thu thập dữ liệu, tự động hóa quy trình làm việc, truy cập nội dung theo khu vực và mở rộng môi trường thực thi. Từ proxy di động LTE / 5G và proxy dân cư đến hỗ trợ tự động hóa trình duyệt, nhận diện dấu vân tay thiết bị, kiểm tra gian lận và điện thoại Android trên nền tảng đám mây, mọi thứ đều được thiết kế để hỗ trợ quy trình làm việc AI từ một nền tảng duy nhất.
Trích xuất dữ liệu web bằng AI
Tự động hóa trình duyệt bằng AI
Thu thập dữ liệu AI
Thực thi tác nhân AI
Quy trình làm việc AI trên thiết bị di động
Truy cập AI khu vực
Xem cách CyberYozh hoạt động trong thực tế thông qua các quy trình làm việc thực, tính năng nền tảng và ví dụ về hạ tầng. Khám phá bảng điều khiển, tích hợp, môi trường thực thi và các công cụ dành cho đội ngũ AI cũng như các dự án tự động hóa.
Khi xây dựng bộ dữ liệu huấn luyện ở quy mô lớn, gần như lần nào bạn cũng gặp cùng một rào cản: nguồn dữ liệu không muốn bị thu thập mạnh như vậy, nhanh như vậy, từ chỉ một địa chỉ.
Các trang web giới hạn hoặc chặn IP gửi lượng yêu cầu lớn – việc thu thập dữ liệu dừng lại rất lâu trước khi đạt kích thước mục tiêu, còn thời gian của kỹ sư thì tiêu tốn vào việc gỡ chặn.
Cloudflare và DataDome nhận diện các mẫu yêu cầu không phải của người dùng thật cùng dấu vân tay thiết bị, khiến bạn gặp các bức tường CAPTCHA.
Chỉ thu thập từ một khu vực – nếu không có IP địa phương, bạn không thể thu thập ổn định các nguồn, ngôn ngữ và góc nhìn đặc thù của những thị trường khác
Reddit, các diễn đàn ngách và những nguồn huấn luyện giá trị cao khác yêu cầu đăng ký và xác minh số điện thoại mới xem được đầy đủ nội dung, tạo thêm một rào cản ngoài việc chặn theo IP.
Proxy của CyberYozh App giải quyết cả bốn vấn đề bằng cách phân tán yêu cầu qua các IP được nhận diện như người dùng thật, đúng vị trí và với khối lượng mà bộ dữ liệu huấn luyện đòi hỏi.
Mở danh mục proxy CyberYozh App cho việc thu thập dữ liệu AI
Kiểm tra chất lượng IP trước khi chạy quy trình
Reddit, Hacker News, Stack Exchange và các cộng đồng ngách là một trong những nguồn phong phú nhất cho dữ liệu hội thoại và dữ liệu chuyên ngành, nhưng cũng là nơi giới hạn tốc độ gắt gao nhất. Proxy mobile cho bộ dữ liệu AI hiệu quả nhất ở đây, vì IP thật từ các nhà mạng di động như Vodafone hay T-Mobile vượt qua được các bước kiểm tra vốn đánh dấu ngay lưu lượng datacenter.
Mẹo: Các trang yêu cầu đăng nhập và luồng bài viết tải lười thường cần Playwright hoặc Puppeteer để hiển thị và phân trang nội dung trước khi có thể thu thập.
GitHub, GitLab và các package registry phần lớn mở và thân thiện với API, nên proxy datacenter xử lý tốt: nhanh, rẻ và đủ độ tin cậy cho các đợt tải khối lượng lớn.
Báo chí, tạp chí khoa học và kho lưu trữ có bản quyền cần cách tiếp cận nhẹ nhàng hơn. Proxy residential hoặc mobile phù hợp ở đây, kèm theo hồ sơ ghi lại những gì đã được truy cập và bằng cách nào, vì các nguồn này chịu sự giám sát pháp lý chặt chẽ nhất trong thu thập dữ liệu huấn luyện AI.
Danh sách sản phẩm và đánh giá trên E-commerce liên tục thay đổi và bị theo dõi sát sao về hoạt động thu thập dữ liệu. Proxy residential xoay IP giữ được khối lượng cao mà không gây ra tình trạng giá bị bóp méo hay các lần chặn nhằm vào lưu lượng tự động.
Muốn xây dựng bộ dữ liệu khái quát hóa tốt giữa nhiều ngôn ngữ và khu vực, bạn cần thu thập trực tiếp từ các nguồn địa phương, chứ không chỉ phiên bản mà máy chủ của bạn tình cờ nhìn thấy. Proxy residential nhắm theo vị trí địa lý tại hơn 195 quốc gia lấy được nội dung bản địa đích thực, thay vì bị lệch về nơi bắt đầu phiên thu thập.
Thay vì xây một lớp thu thập riêng cho từng loại nguồn, Yozh Scraper chạy sẵn các tác vụ dùng Playwright qua proxy mobile, residential hoặc datacenter. Một công cụ đảm nhiệm việc thu thập dữ liệu AI trên mạng xã hội, trang e-commerce và nguồn tin tức.
💡 Điểm rút ra cho người vận hành: Hầu hết bộ dữ liệu huấn luyện kết hợp nhiều nhóm nguồn trên. Kết hợp các loại proxy theo từng nguồn, thay vì mặc định dùng một loại cho mọi thứ, giúp giảm chi phí ở các mục tiêu dễ và giữ tỷ lệ thành công cao ở các mục tiêu khó.
Hãy chọn proxy tương ứng với mức độ chống thu thập của nguồn.
IP của nhà mạng di động có độ tin cậy cao hơn IP residential. Chúng phù hợp nhất khi bạn muốn thu thập dữ liệu huấn luyện AI từ các nền tảng ưu tiên di động: Instagram, TikTok, Reddit hoặc tài khoản Facebook yêu cầu xác minh qua SMS trước khi cấp quyền truy cập đầy đủ.
Mẹo: Hoàn tất đăng ký tài khoản mà không gặp trục trặc nhờ số ảo của CyberYozh App để xác minh qua SMS tại hơn 195 quốc gia.
IP residential gắn với nhà cung cấp dịch vụ Internet thật và được các nền tảng nhìn nhận như người dùng thật. Chúng đáng tin cậy hơn cho các nền tảng mạng xã hội, diễn đàn, e-commerce và trang tin tức, bao gồm các chủ đề trên Reddit và đánh giá sản phẩm.
IP datacenter xử lý tốt các đợt tải khối lượng lớn khi không cần danh tính residential. Chúng phù hợp nhất cho kho mã nguồn, bộ dữ liệu của chính phủ và kho lưu trữ công khai, như GitHub, package registry và các cổng dữ liệu mở.
Với việc thu thập dữ liệu AI quy mô lớn, chi phí proxy tăng nhanh khi khối lượng thu thập lớn dần. Proxy residential tính phí theo lưu lượng đã dùng, còn proxy mobile riêng của CyberYozh App cung cấp lưu lượng không giới hạn với mức giá cố định theo ngày. Hãy so sánh chi phí ở các khối lượng thu thập khác nhau.
Lưu lượng mỗi ngày | Residential ($2.5/GB, từ 100 GB) | Mobile riêng ($3.5/ngày) |
|---|---|---|
3 GB | $7.5 | $3.50 |
10 GB | $25 | $3.50 |
25 GB | $62.50 | $3.50 |
50 GB | $125 | $3.50 |
100 GB | $250 | $3.50 |
Mobile riêng: $105/tháng, bất kể lưu lượng, theo điều khoản sử dụng không giới hạn của gói.
Residential: $62.5/tháng ở mức 25 GB, $250 ở mức 100 GB.
Ở mức 500 GB/tháng: residential có giá $1,100/tháng (gói doanh nghiệp), so với $105 của mobile riêng.
Việc thu thập dữ liệu huấn luyện AI đang chịu sự giám sát pháp lý ngày càng chặt, và trách nhiệm ngày càng truy ngược qua toàn bộ chuỗi xử lý, chứ không chỉ công ty huấn luyện mô hình. Nguồn dữ liệu sạch, có tài liệu rõ ràng là điểm khác biệt giữa một quy trình thu thập có thể bảo vệ được và một quy trình không đứng vững khi bị chất vấn.
Một vài thực hành giúp giảm rủi ro đó và khiến nguồn dữ liệu của bạn có thể bảo vệ được nếu bị chất vấn:
Tôn trọng robots.txt và các giới hạn tốc độ đã công bố thay vì tìm cách lách qua.
Lưu nhật ký scraping – dấu thời gian, URL nguồn và phương thức truy cập, để bạn chứng minh được đã thu thập gì và bằng cách nào.
Theo dõi nguồn gốc IP và dữ liệu từ đầu đến cuối, thay vì tin lời của bên trung gian về cách dữ liệu được thu thập.
Tách thu thập dữ liệu AI khỏi việc phân phối lại và ghi chép mọi mục đích sử dụng tiếp theo, hạn chế giấy phép hoặc quyền dữ liệu của bên thứ ba trước khi chia sẻ bộ dữ liệu huấn luyện.
CyberYozh App gộp mọi lớp cần thiết cho việc thu thập dữ liệu huấn luyện AI trên một nền tảng – proxy, xác minh và phòng chống gian lận. Nhờ vậy, các đội ngũ không phải ghép nối nhiều nhà cung cấp riêng cho từng phần của quy trình.
Hơn 100M proxy residential với phiên xoay IP và sticky-session lên đến 24 giờ, lọc IP, định vị địa lý miễn phí và xoay IP điều khiển qua API
Proxy mobile 5G/LTE thật với băng thông không giới hạn cho việc thu thập khối lượng lớn mà không bị giới hạn dung lượng làm chậm quá trình xây dựng bộ dữ liệu
Định vị theo thành phố và mã zip tại hơn 195 quốc gia cho dữ liệu khu vực và đa ngôn ngữ đích thực
Kiểm tra điểm gian lận IP để lọc trước các IP đầu ra và giữ nguồn dữ liệu sạch
Chuyển đổi dấu vân tay hệ điều hành để giảm CAPTCHA và các yêu cầu bị chặn
Số SMS ảo và thẻ thanh toán để vượt qua các bước đăng ký và xác minh mà không lộ tài khoản cá nhân
Tương thích API với Playwright, Puppeteer, Selenium, Postman, Scrapy và các công cụ tự viết.
Chọn loại proxy. Datacenter cho kho mã nguồn mở và các đợt tải API hàng loạt, residential cho các nguồn có giới hạn tốc độ hoặc bị khóa theo khu vực, mobile LTE/5G cho diễn đàn, nền tảng xã hội và các bước đăng ký.
Cấu hình vị trí. Chọn định vị theo quốc gia, thành phố hoặc mã ZIP để mỗi nguồn dữ liệu được tải từ đúng khu vực tương ứng — nếu không, bộ dữ liệu của bạn sẽ bị lệch về địa lý.
Lấy thông tin xác thực. Sao chép endpoint, tên người dùng và mật khẩu từ bảng điều khiển, hoặc tạo khóa API để dùng trong quy trình lập trình.
Kết nối. Thêm thông tin xác thực vào Playwright, Puppeteer, Selenium, Scrapy hoặc script tự viết — hoặc chạy Yozh Scraper để bỏ qua bước cấu hình. Đặt chế độ xoay IP hoặc sticky cho từng yêu cầu hoặc từng phiên trong cùng một cấu hình.
Kiểm tra kết nối. Kiểm tra IP đầu ra và điểm gian lận IP, sau đó chạy một yêu cầu thử để xác nhận việc xoay IP, thời lượng sticky và định vị địa lý hoạt động đúng như mong đợi trước khi mở rộng quy mô xây dựng bộ dữ liệu.
Khám phá proxy cho các tác vụ tương tự: proxy cho AI search agent, hạ tầng proxy cho ChatGPT và proxy để thu thập dữ liệu SERP.