AI proxy: Proxy hỗ trợ các tác nhân AI như thế nào
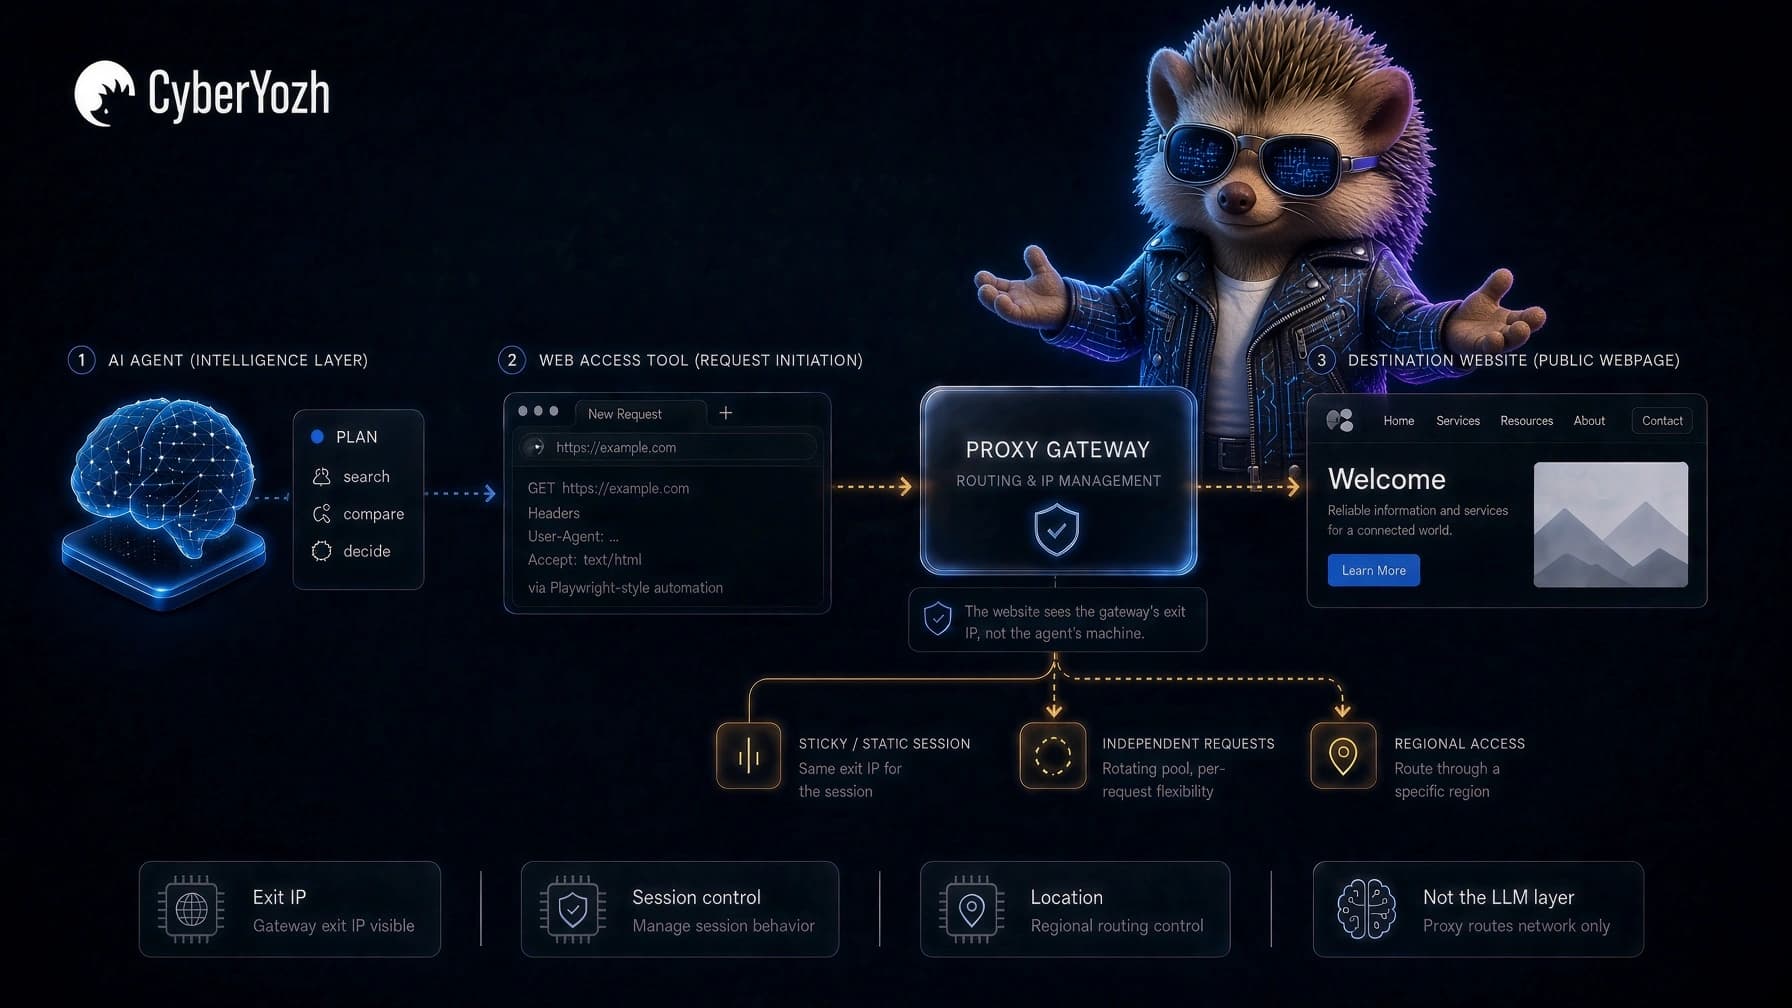
Một AI agent có thể lập kế hoạch tác vụ, chọn công cụ, mở trình duyệt, tìm kiếm trang web, so sánh kết quả và quyết định bước tiếp theo. Nhưng ngay khi nó truy cập web, một điều rất bình thường xảy ra: nó thực hiện một network request.
Request đó vẫn đến từ một địa chỉ IP, có vị trí, tuyến mạng và session đằng sau nó. Tùy thuộc vào tác vụ, agent có thể cần giữ IP đó trong suốt hành trình trình duyệt, truy cập web từ một vị trí cụ thể hoặc phân phối hàng nghìn request độc lập qua một IP pool luân phiên.
Đó là lúc AI proxy phát huy tác dụng.
Đối với browser agent, scraping agent, công cụ nghiên cứu và các tự động hóa kết nối web khác, AI proxy kiểm soát tuyến mạng giữa công cụ truy cập web của agent và đích đến. Nó có thể xác định loại IP và vị trí, thời gian một IP gắn với session, và khi nào lưu lượng di chuyển qua một pool lớn hơn.
CyberYozh App cung cấp lớp mạng đó thông qua AI agent proxy, hạ tầng browser-agent, residential proxy, mobile route, datacenter IP và tích hợp với các công cụ tự động hóa phổ biến.
AI vẫn thực hiện suy nghĩ. Proxy xử lý cách AI đó tiếp cận web.
TL;DR
Một AI proxy có thể có hai nghĩa khác nhau: một network proxy kiểm soát cách AI agent tiếp cận web, hoặc một AI gateway/LLM proxy quản lý request giữa ứng dụng và nhà cung cấp model.
Đối với agent kết nối web, proxy nằm giữa trình duyệt hoặc HTTP client và đích đến, kiểm soát exit IP, vị trí, loại mạng, hành vi session và rotation.
AI proxy có thể hỗ trợ browser agent, AI web scraping, RAG và web retrieval, nghiên cứu, localization và QA, cùng monitoring khi tuyến mạng quan trọng đối với tác vụ.
Chọn proxy dựa trên khối lượng công việc: static ISP cho các session ổn định dài hạn, sticky residential cho tính liên tục tạm thời, rotating residential cho các request độc lập, mobile khi carrier routing quan trọng, và datacenter khi hạ tầng đơn giản là đủ.
Cấu hình proxy trong công cụ thực sự truy cập web, chẳng hạn như Playwright, Puppeteer, Selenium, Scrapy hoặc Postman, thay vì trong chính language model.
Rotation không tự động tốt hơn. Giữ tuyến ổn định khi các request thuộc cùng một session và luân phiên khi khối lượng công việc bao gồm các request độc lập.
Proxy chỉ xử lý lớp mạng. Nó không bảo mật prompt, quản lý trạng thái trình duyệt, sửa logic trích xuất, kiểm soát quyền của agent hoặc làm cho quyết định của model an toàn hơn.
Với CyberYozh App, thiết lập thực tế là chọn đúng vị trí và hành vi phiên, cấu hình kết nối trong công cụ truy cập web, xác minh IP đầu ra và chỉ thêm kiểm soát dựa trên API khi quy trình làm việc cần đến.
AI proxy là gì?
AI proxy là một trung gian được sử dụng trong quy trình làm việc AI để định tuyến kết nối giữa các phần khác nhau của hệ thống. Nó thực sự kết nối cái gì phụ thuộc vào loại AI proxy bạn đang đề cập: network proxy cho AI agent kiểm soát cách AI agent tiếp cận web, hoặc AI gateway hoặc LLM proxy quản lý cách ứng dụng giao tiếp với các nhà cung cấp mô hình.
Chúng nằm ở các lớp khác nhau của ngăn xếp AI và giải quyết các vấn đề khác nhau.
Network proxy cho AI agent
Đây là những gì chúng ta chủ yếu đang nói đến trong bài viết này.
Luồng trông giống như thế này:
AI agent → trình duyệt hoặc HTTP client → proxy → website
AI proxy kiểm soát kết nối mạng giữa công cụ của agent và đích đến.
Điều đó có thể thay đổi:
Địa chỉ IP hiển thị
Vị trí địa lý của kết nối
Loại mạng, chẳng hạn như residential, mobile, ISP hoặc datacenter
IP giống nhau gắn với một phiên trong bao lâu
Các yêu cầu được phân phối như thế nào trên một IP pool
Nhận CyberYozh App AI agent proxy.
AI gateway hoặc LLM proxy
AI gateway nằm ở một nơi khác.
Luồng của nó trông giống như:
Ứng dụng → AI gateway → nhà cung cấp mô hình
Nó có thể tập trung hóa định tuyến mô hình, ghi log, thử lại, kiểm soát tốc độ, lựa chọn nhà cung cấp và các chức năng cấp API tương tự. Ví dụ, Cloudflare mô tả AI Gateway của mình như một lớp để quan sát và kiểm soát các yêu cầu mô hình với các tính năng bao gồm ghi log, caching, giới hạn tốc độ, thử lại và fallback. Tài liệu Cloudflare AI Gateway
Đó là cơ sở hạ tầng hữu ích, nhưng nó không giống như việc cung cấp cho browser agent một IP residential.
Mẹo chuyên nghiệp: AI gateway kiểm soát cách ứng dụng của bạn tiếp cận mô hình. Network AI proxy kiểm soát cách agent tiếp cận web. Cả hai có thể tồn tại trong cùng một hệ thống.
Proxy mạng cho AI agent | |
Nằm giữa | Trình duyệt/client của agent và website |
Kiểm soát | IP, vị trí, loại mạng, sticky session, rotation |
Mục đích sử dụng phổ biến | Browser agent, web scraping, nghiên cứu, kiểm thử theo khu vực |
Luồng ví dụ | Agent → proxy → website |
CyberYozh App cung cấp điều này? | Có |
AI proxy hoạt động như thế nào?
Một AI proxy mạng hoạt động giữa công cụ mà AI agent sử dụng để truy cập web và website hoặc dịch vụ mà nó cần tiếp cận. Thay vì kết nối trực tiếp từ máy đang chạy agent, request trước tiên sẽ đi qua một proxy server.
Tuyến đường cơ bản trông như thế này:
AI agent → trình duyệt hoặc HTTP client → proxy server → website
Khi trình duyệt, scraper hoặc HTTP client gửi một request, proxy sẽ nhận nó và chuyển tiếp đến đích bằng cách sử dụng một exit IP từ mạng của nó. Website sẽ thấy exit IP đó thay vì IP của máy đang chạy agent. Response sau đó sẽ quay trở lại qua proxy đến công cụ truy cập web của agent.
Điều gì xảy ra với IP trên đường đi phụ thuộc vào cấu hình proxy. Agent có thể giữ cùng một IP trong suốt một phiên trình duyệt nhiều bước, sử dụng sticky IP trong một khoảng thời gian nhất định, hoặc rút các exit IP khác nhau từ một pool rotating cho các request độc lập. Vị trí cũng có thể được chọn khi workflow cần truy cập web từ một quốc gia hoặc khu vực cụ thể.
Tại sao AI agent sử dụng proxy khi truy cập web
Nếu một AI agent chỉ hoạt động bên trong cơ sở dữ liệu hoặc phần mềm nội bộ của bạn, nó có thể hoàn toàn không cần proxy.
Proxy trở nên cần thiết khi agent bắt đầu tương tác với các website và dịch vụ bên ngoài.
Hãy nghĩ về một research agent phải mở hàng trăm trang sản phẩm công khai. Hoặc một QA agent kiểm thử website từ nhiều quốc gia. Hoặc một browser agent cần duy trì trong cùng một phiên trong khi thực hiện quy trình năm bước.
Những công việc đó có yêu cầu mạng rất khác nhau.
AI browser agent cần một tuyến đường nhất quán
Một browser agent có thể tìm kiếm, nhấp chuột, điều hướng, so sánh thông tin, chụp ảnh màn hình, điền vào các biểu mẫu được phê duyệt hoặc tương tác với các ứng dụng web.
Nếu workflow kéo dài vài phút, việc thay đổi IP giữa chừng có thể không cần thiết hoặc thậm chí phản tác dụng.
Đối với loại công việc này, tuyến đường mạng thường nên có thể dự đoán được.
Môi trường trình duyệt vẫn là một lớp riêng biệt. Cookie, storage, header, session và bảo mật trình duyệt không biến mất chỉ vì IP thay đổi.
Proxy xử lý danh tính mạng. Nó không thay thế thiết kế browser-agent tốt.
AI research agent có thể cần kiểm soát vị trí
Hãy tưởng tượng một AI agent so sánh kết quả tìm kiếm công khai, giá cả, tình trạng sẵn có hoặc các trang được bản địa hóa ở nhiều quốc gia.
Chạy mọi request từ một vị trí cloud duy nhất có thể khiến agent có một bức tranh rất không đầy đủ.
Proxy cho phép agent thực hiện các request qua một tuyến đường trong khu vực đang được kiểm thử.
Điều đó không thay đổi danh tính hoặc tư cách của người dùng đối với một dịch vụ. Nó chỉ đơn giản thay đổi vị trí mạng được sử dụng cho request.
Agent scraping AI có thể cần nhiều IP
Thu thập dữ liệu công khai quy mô lớn có đặc điểm khác biệt.
Agent có thể không quan tâm đến việc duy trì một danh tính trình duyệt trong một giờ. Nó có thể đang truy xuất nhiều trang độc lập, xác thực phản hồi, trích xuất thông tin có cấu trúc và tiếp tục.
Đó là lúc AI web scraping và cơ sở hạ tầng proxy xoay vòng trở nên hữu ích hơn.
Scraper vẫn cần logic thử lại, phân tích cú pháp, loại bỏ trùng lặp, xác thực và nhịp độ yêu cầu hợp lý. Proxy chỉ giải quyết phần định tuyến mạng của hệ thống đó.
Proxy là cơ sở hạ tầng, không phải trí thông minh. Nó có thể cải thiện cách agent tiếp cận tài nguyên, nhưng không thể sửa logic trích xuất tồi hoặc quyết định sai lầm do mô hình đưa ra.
Các trường hợp sử dụng AI proxy
AI proxy trở nên hữu ích khi hệ thống AI cần tương tác với web công khai và tuyến mạng quan trọng đối với tác vụ. Vai trò cụ thể của proxy phụ thuộc vào những gì agent đang cố gắng truy xuất, kiểm tra, giám sát hoặc tự động hóa.
Trường hợp sử dụng | AI đang làm gì | Proxy bổ sung gì |
Browser agent | Điều hướng trang web và hoàn thành các tác vụ nhiều bước | Phiên ổn định và kiểm soát vị trí mạng |
AI web scraping | Thu thập dữ liệu công khai từ nhiều trang | Truy cập vào pool IP xoay vòng cho các yêu cầu độc lập |
RAG và truy xuất web | Truy xuất nội dung web hiện tại trước khi chuyển đến LLM | Truy cập phân tán và nhận biết vị trí đến các trang nguồn |
Research agent | So sánh thông tin công khai trên các trang web hoặc thị trường | Định tuyến IP theo khu vực cho kết quả được bản địa hóa |
Bản địa hóa và QA | Kiểm tra cách một trang web hoặc ứng dụng hoạt động từ các khu vực khác nhau | Truy cập từ IP tại các vị trí đang được kiểm tra |
Monitoring agent | Kiểm tra các trang công khai lặp đi lặp lại để phát hiện thay đổi | Tuyến nhất quán hoặc phân tán tùy thuộc vào công việc giám sát |
RAG và truy xuất web
Retrieval-augmented generation trở nên đặc biệt liên quan khi thông tin mà hệ thống AI cần không có sẵn trong mô hình hoặc cơ sở kiến thức nội bộ của nó.
Quy trình RAG có thể truy xuất thông tin từ cơ sở dữ liệu, API, tài liệu hoặc web trước khi cung cấp tài liệu liên quan cho mô hình. Khi nguồn truy xuất là một trang web công khai, thành phần truy cập web vẫn phải thực hiện các yêu cầu mạng thông thường.
Proxy có thể kiểm soát IP và vị trí được sử dụng cho các yêu cầu đó. Điều này trở nên hữu ích khi hệ thống truy xuất thu thập thông tin công khai từ nhiều khu vực khác nhau hoặc phân phối khối lượng công việc truy xuất lớn hơn qua nhiều tuyến đường.
Proxy không thực hiện việc truy xuất hoặc cải thiện khả năng suy luận của mô hình. Nó cung cấp lớp mạng được sử dụng để tiếp cận các nguồn mà từ đó hệ thống RAG truy xuất thông tin.
Nhắm mục tiêu địa lý và QA hỗ trợ AI
AI agent cũng có thể tự động hóa các phần của việc kiểm thử website và ứng dụng theo khu vực. Một agent có thể kiểm tra các trang được bản địa hóa, kết quả tìm kiếm, tình trạng sẵn có của sản phẩm, các biến thể ngôn ngữ, hoặc nội dung khác có thể khác nhau tùy thuộc vào nơi yêu cầu xuất phát.
Định tuyến agent qua proxy tại vị trí đang được kiểm thử cho phép quy trình QA quan sát web từ vị trí mạng đó thay vì phụ thuộc hoàn toàn vào máy chủ nơi tự động hóa đang chạy.
Sử dụng proxy nhắm mục tiêu địa lý của CyberYozh App để xuất hiện như một người dùng địa phương thực sự ở bất kỳ quốc gia, thành phố hoặc mạng nhà mạng nào.
Monitoring agent
Monitoring agent liên tục kiểm tra các tài nguyên công khai để phát hiện thay đổi, chẳng hạn như thông tin sản phẩm, tình trạng sẵn có, kết quả tìm kiếm, dữ liệu thị trường hoặc cập nhật website.
Một agent kiểm tra lặp đi lặp lại cùng một tài nguyên có thể hoạt động hoàn hảo với một tuyến đường nhất quán, trong khi một hệ thống giám sát lớn hơn bao phủ nhiều nguồn độc lập có thể được hưởng lợi từ việc phân phối yêu cầu qua một IP pool.
Giống như các trường hợp sử dụng AI proxy khác, chiến lược mạng nên tuân theo khối lượng công việc thay vì áp dụng rotation chỉ đơn giản vì nó có sẵn.
Bạn nên sử dụng loại AI proxy nào?
Không có một proxy tốt nhất duy nhất cho mọi AI agent.
Lựa chọn tốt nhất phụ thuộc vào những gì agent đang làm khi nó rời khỏi hạ tầng của bạn và tiếp cận web công khai.
Khối lượng công việc AI | Proxy cần xem xét | Lý do |
Tác vụ trình duyệt nhiều bước | Static ISP | Giữ một IP nhất quán |
Phiên trình duyệt residential | Sticky residential | Giữ một tuyến đường residential cho phiên |
Khối lượng công việc dữ liệu công khai lớn | Rotating residential | Phân phối các yêu cầu độc lập |
Cổng rotating tự động | Backconnect proxy | Cung cấp cho client một cổng trong khi các exit rotate |
Kiểm thử mạng di động | Mobile | Sử dụng hạ tầng LTE/5G |
Tự động hóa đơn giản | Datacenter | Đơn giản và tiết kiệm chi phí khi không cần định tuyến residential |
Static ISP proxy cho các phiên AI agent dài
Một agent chạy lâu thường được hưởng lợi từ một tuyến đường ổn định.
Ví dụ, nếu một agent mở một website, điều hướng qua nhiều trang, chọn các tùy chọn, và sau đó trả về kết quả, việc giữ một IP trong suốt hành trình sẽ dễ suy luận hơn.
Static ISP proxy của CyberYozh App cung cấp cho quy trình công việc đó một địa chỉ được hỗ trợ bởi ISP bền vững.
Điều này thường phù hợp hơn so với việc xoay vòng IP chỉ đơn giản vì tính năng xoay vòng có sẵn.
Proxy residential dính cho tính liên tục tạm thời
Đôi khi bạn muốn định tuyến residential mà không cần giữ cùng một IP vô thời hạn.
Một phiên dính cho phép nhiều yêu cầu liên quan chia sẻ một lối ra trong khoảng thời gian xác định.
Điều này có thể hoạt động tốt khi agent cần tính liên tục phiên nhưng hệ thống lớn hơn vẫn sử dụng pool residential.
Proxy residential xoay vòng cho các yêu cầu độc lập
Nếu agent đang thu thập nhiều trang công khai không liên quan, việc xoay vòng trở nên hữu ích hơn.
CyberYozh App proxy residential xoay vòng có thể hỗ trợ các khối lượng công việc mà các yêu cầu khác nhau không cần chia sẻ một danh tính mạng tồn tại lâu dài.
Proxy backconnect cho xoay vòng tự động
Một proxy backconnect cung cấp cho tự động hóa của bạn một cổng proxy duy nhất trong khi cơ sở hạ tầng quản lý việc thay đổi IP lối ra phía sau.
Điều này có thể đơn giản hóa một số kiến trúc agent vì client không cần duy trì một danh sách lớn các địa chỉ proxy riêng lẻ.
Đối với tự động hóa khối lượng lớn, điều này thường dễ quản lý hơn so với việc cung cấp IP mới vào ứng dụng theo cách thủ công.
Proxy di động cho quy trình làm việc mạng nhà mạng
Proxy di động sử dụng cơ sở hạ tầng mạng di động.
Chúng có ý nghĩa đối với các quy trình làm việc mà định tuyến LTE hoặc 5G thực sự là một phần của những gì bạn đang kiểm tra.
Điều đó có thể bao gồm QA di động, trải nghiệm di động theo khu vực, hoặc một agent có nhiệm vụ phụ thuộc cụ thể vào tuyến đường mạng nhà mạng.
Đừng tự động chọn di động chỉ vì nó nghe có vẻ tiên tiến hơn. Nếu nhiệm vụ không cần mạng di động, một loại proxy khác có thể đơn giản hơn.
Proxy datacenter cho tự động hóa AI đơn giản hơn
Nhiều tác vụ tự động hóa không cần đặc tính residential hoặc di động chút nào.
Một proxy datacenter có thể là lựa chọn đơn giản cho kiểm tra kỹ thuật, phát triển, giám sát, công việc dữ liệu mở và các công việc khác mà IP cơ sở hạ tầng thông thường là đủ.
Proxy phù hợp là mạng ít phức tạp nhất đáp ứng nhiệm vụ.
Cách thiết lập proxy AI với CyberYozh App
Khi bạn đã biết tuyến đường mạng mà AI agent của bạn cần, việc thiết lập quy về việc cấu hình công cụ mà nó sử dụng để truy cập web. Bạn đã chọn loại proxy phù hợp; bây giờ bạn cần quyết định cách kết nối nên hoạt động và kết nối nó với lớp truy cập web của agent.
Bước 1. Chọn vị trí
Nếu địa lý quan trọng đối với nhiệm vụ, hãy chọn quốc gia, khu vực hoặc tùy chọn nhắm mục tiêu có sẵn khác mà agent cần.
Điều này có thể quan trọng đối với nghiên cứu AI, truy xuất web được bản địa hóa, QA theo khu vực, giám sát và các quy trình làm việc khác mà nội dung được trả về bởi một trang web có thể thay đổi tùy thuộc vào vị trí của yêu cầu.
Nếu địa lý không quan trọng, không có lý do gì để thêm yêu cầu vị trí chỉ đơn giản vì tùy chọn tồn tại.
Bước 2. Quyết định cách IP nên hoạt động
Tiếp theo, quyết định xem agent nên giữ IP của nó hay thay đổi nó.
Một hành trình trình duyệt nhiều bước thường được hưởng lợi từ tính liên tục. Đối với các tập hợp lớn các yêu cầu độc lập, xoay vòng có thể phù hợp hơn. Một phiên dính nằm ở đâu đó giữa hai, giữ cùng một IP lối ra trong khoảng thời gian xác định.
Phần quan trọng là làm cho hành vi IP tuân theo nhiệm vụ của agent thay vì một bộ đếm thời gian tùy ý. Hướng dẫn xoay vòng proxy của chúng tôi giải thích các cách tiếp cận khác nhau chi tiết hơn.
Bước 3. Chọn giao thức mà client của bạn hỗ trợ
Giao thức cần được hỗ trợ bởi trình duyệt, framework tự động hóa, scraper hoặc HTTP client thực hiện request.
Hãy chọn theo những gì mà client và workflow thực sự yêu cầu thay vì coi một giao thức nào đó là tốt nhất cho mọi trường hợp. Nếu bạn cần trợ giúp để quyết định giữa các lựa chọn phổ biến.
Xem so sánh SOCKS5 vs HTTPS proxycủa chúng tôi.
Bước 4. Lấy thông tin xác thực proxy của bạn
Sau khi cấu hình mạng đã sẵn sàng, hãy sử dụng thông tin kết nối được cung cấp trong bảng điều khiển CyberYozh App của bạn. Một kết nối proxy điển hình bao gồm:
Host
Port
Username
Password
Protocol
Cấu hình chính xác có thể thay đổi tùy thuộc vào sản phẩm proxy và các cài đặt vị trí, session hoặc IP mà bạn đã chọn.
Hãy giữ các thông tin xác thực này trong môi trường thực thi thay vì để lộ chúng cho chính mô hình ngôn ngữ.
Bước 5. Kết nối proxy với công cụ thực hiện request
Cấu hình proxy tại nơi agent thực sự truy cập web.
Ví dụ:
LLM → logic agent → Playwright → CyberYozh App proxy → website
Nếu Playwright điều khiển trình duyệt, hãy cấu hình proxy trong Playwright. Nguyên tắc tương tự áp dụng cho Puppeteer, Selenium, Scrapy, Postman, HTTP client hoặc môi trường tự động hóa khác.
Hướng dẫn thiết lập Playwright của CyberYozh App cho thấy một ví dụ kết nối thực tế.
Quy tắc thiết lập: Theo dõi request. Component gửi nó đến web thường là nơi proxy thuộc về.
Bước 6. Xác minh kết nối trước khi chạy agent
Đừng cho rằng proxy đang hoạt động chỉ vì thông tin xác thực đã được thêm thành công.
Sử dụng công cụ kiểm tra IP của CyberYozh App để xác nhận IP đầu ra và vị trí mong đợi. Đối với workflow static hoặc sticky, hãy kiểm tra xem tuyến đường có duy trì nhất quán như mong đợi không. Nếu rotation là một phần của thiết lập, hãy xác minh rằng hành vi IP khớp với cấu hình của bạn.
Chỉ sau đó mới giao workflow cho agent.
Bước 7. Thêm điều khiển API khi workflow cần đến nó
Đối với các workflow AI lớn hơn, quản lý proxy cuối cùng có thể cần trở thành một phần của chính quá trình tự động hóa thay vì một thứ được cấu hình thủ công trước mỗi lần chạy.
Khi được sản phẩm proxy hỗ trợ, các điều khiển dựa trên API có thể được tích hợp vào pipeline tự động hóa rộng hơn. Tuy nhiên, đối với một agent đơn giản hơn, không có lý do gì để thêm một lớp logic khác nếu kết nối proxy tiêu chuẩn đã hoàn thành công việc.
Sẵn sàng kết nối workflow AI của bạn? Chọn một proxy CyberYozh App dựa trên vị trí, hành vi session, giao thức và yêu cầu mạng của agent.
Proxy AI cho web scraping và thu thập dữ liệu
AI đã làm cho các workflow scraping linh hoạt hơn, nhưng nó không loại bỏ các vấn đề kỹ thuật thông thường xung quanh việc thu thập dữ liệu.
Agent vẫn phải tải trang trước khi LLM có thể phân loại, trích xuất, tóm tắt hoặc suy luận về nội dung của nó.
Bước mạng này rất quan trọng.
proxy web scraping có thể giúp phân phối các yêu cầu dữ liệu công khai và tách biệt cơ sở hạ tầng scraping khỏi máy chạy agent.
Nhưng proxy cần nằm trong một hệ thống rộng hơn xử lý:
Nhịp độ yêu cầu
Thử lại
Xác thực
Phát hiện trùng lặp
Lỗi parser
Quản lý session
Xử lý lỗi
Tuân thủ các quy tắc và quyền hạn hiện hành
Proxy không thay thế các thành phần đó.
Đối với các workflow lớn hơn, CyberYozh App web scraping stack cung cấp tầng mạng cùng với các tích hợp scraping và automation hiện có.
Các lỗi AI proxy phổ biến
Hầu hết các thiết lập AI proxy tồi đều đáng ngạc nhiên là rất thông thường. Chúng thường là lỗi kiến trúc hoặc cấu hình chứ không phải vấn đề AI bí ẩn nào đó.
Xoay vòng mọi yêu cầu
Rotation không tự động tốt hơn.
Nếu agent đang thực hiện hàng nghìn yêu cầu độc lập, rotation có thể phù hợp với khối lượng công việc. Nếu nó cần tính liên tục qua một hành trình trình duyệt nhiều bước, việc thay đổi IP giữa chừng có thể khiến session khó duy trì hơn.
Điều chỉnh rotation theo cấu trúc của tác vụ thay vì bật nó theo mặc định.
Sử dụng residential proxy cho mọi thứ
Residential routing hữu ích khi khối lượng công việc thực sự cần nó.
Một số công việc phát triển, tác vụ giám sát, kiểm tra kỹ thuật và workflow automation hoạt động hoàn toàn tốt thông qua cơ sở hạ tầng datacenter. Tương tự, mobile proxy chỉ có ý nghĩa khi tuyến carrier-network có liên quan.
Việc một workflow sử dụng AI không tự động có nghĩa là nó cần loại proxy phức tạp nhất hiện có.
Cung cấp thông tin xác thực proxy cho model
Model thường không cần thấy tên người dùng proxy, mật khẩu hoặc thông tin xác thực API của bạn.
Giữ bí mật trong môi trường thực thi và để Playwright, Puppeteer, Selenium, Scrapy hoặc Postman sử dụng kết nối proxy đã cấu hình. Model có thể điều hướng workflow mà không cần truy cập vào thông tin xác thực đằng sau nó.
Cấu hình proxy ở sai vị trí
Proxy cần được cấu hình trên thành phần thực sự thực hiện yêu cầu web đi ra ngoài.
Ví dụ, nếu Playwright điều khiển trình duyệt, việc thêm thông tin proxy ở đâu đó trong cấu hình LLM không tự động định tuyến lưu lượng Playwright qua nó.
Theo dõi yêu cầu qua kiến trúc và cấu hình proxy tại nơi yêu cầu đó rời khỏi hệ thống.
Quên xác minh exit IP
Cấu hình proxy tồn tại trong code của bạn không nhất thiết là cấu hình proxy hoạt động.
Kiểm tra exit IP và vị trí dự kiến trước khi tác vụ bắt đầu. Nếu không, bạn có thể kết thúc việc debug prompt, logic agent hoặc hành vi trình duyệt khi vấn đề chỉ đơn giản là kết nối cấu hình sai.
Thử lại các hành động thất bại một cách mù quáng
Một yêu cầu mạng thất bại không nên tự động khiến một agent tự động lặp lại mọi hành động.
Trước tiên hãy xác định xem lỗi đến từ xác thực, tuyến proxy, đích đến, phiên làm việc hay công cụ. Tài liệu tham khảo lỗi proxy của CyberYozh App có thể giúp phân biệt các lỗi mạng và proxy phổ biến.
Đối với các hệ thống chạy dài hạn, việc xem xét toàn bộ vòng đời proxy cũng hợp lý hơn là thay thế IP một cách ngẫu nhiên mỗi khi có sự cố xảy ra.