Web scraping proxy là một máy chủ đứng giữa scraper của bạn và các trang web mà nó truy cập, gửi các yêu cầu thông qua các địa chỉ IP khác. Trang web sẽ thấy IP của proxy thay vì IP của bạn, do đó bạn có thể thu thập dữ liệu công khai ở quy mô lớn mà không bị giới hạn tốc độ hoặc chặn.
Điểm chính
Web scraping proxy ẩn IP thực của bạn và phân tán các yêu cầu qua nhiều địa chỉ
Residential proxy, mobile proxy, datacenter proxy và ISP proxy phù hợp với các mục tiêu khác nhau
Proxy cải thiện tính ẩn danh khi web scraping, nhưng nó không tự động ẩn browser fingerprint của bạn
Mới tiếp cận chủ đề này? Hãy đọc web scraping là gì trước.
Web scraping proxy hoạt động như thế nào
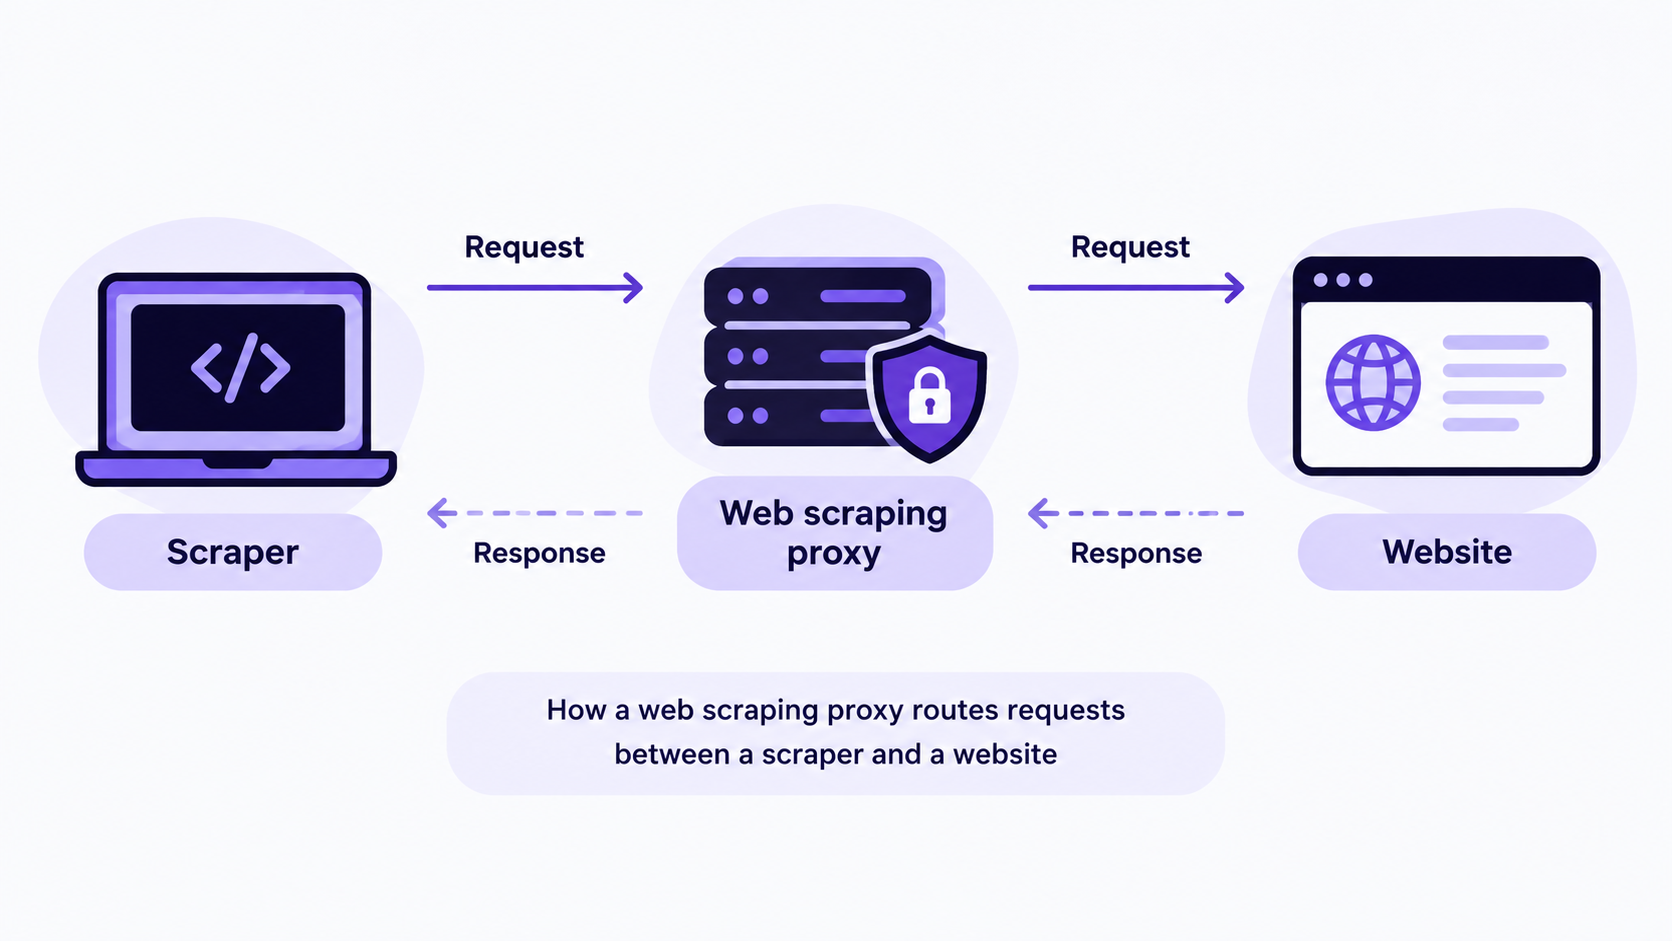
Scraper của bạn gửi một yêu cầu đến proxy, không phải trang web.
Proxy chuyển tiếp yêu cầu đó từ một trong các địa chỉ IP của nó, thường ở quốc gia hoặc thành phố mà bạn chọn.
Trang web phản hồi lại proxy, proxy sau đó chuyển dữ liệu trả về cho scraper của bạn.
Trong code, thường chỉ cần một cài đặt bổ sung. Đây là cách nó trông trong Python:
import requests


proxy = "http://USERNAME:PASSWORD@PROXY_HOST:PORT"

r = requests.get("https://httpbin.org/ip", proxies={"http": proxy, "https": proxy}, timeout=30)

print(r.json())  # shows the proxy's IP, not yours
Rotating proxy sử dụng một IP mới cho mỗi yêu cầu, trong khi sticky session giữ một IP trong vài phút hoặc vài giờ để bạn duy trì đăng nhập. Hướng dẫn của chúng tôi về rotating IP address giải thích khi nào nên sử dụng từng loại.
Tại sao scraper bị chặn khi không có proxy
Các trang web đánh dấu lưu lượng truy cập không giống người thật: quá nhiều yêu cầu từ một IP, các dải datacenter đã biết, hoặc múi giờ không khớp với IP. Kết quả là lỗi 403, tường CAPTCHA và phản hồi 429, MDN định nghĩa là "quá nhiều yêu cầu trong một khoảng thời gian nhất định." Nếu CAPTCHA là vấn đề chính của bạn, hãy xem proxy giúp xử lý CAPTCHA như thế nào.
Mẹo chuyên nghiệp: IP sạch quan trọng không kém loại proxy. Kiểm tra fraud score của nó bằng CyberYozh IP checker trước khi thực hiện công việc lớn.
Các loại proxy cho web scraping
Loại | Nguồn gốc IP | Phù hợp nhất cho |
Proxy residential luân phiên | Kết nối internet gia đình thực | Các trang web được bảo vệ cao, chẳng hạn như thương mại điện tử và công cụ tìm kiếm |
Proxy mobile LTE/5G | Mạng nhà mạng di động | Các trang web nghiêm ngặt nhất và nền tảng mạng xã hội |
Proxy datacenter | Máy chủ đám mây | Dữ liệu công khai và các trang web được bảo vệ nhẹ |
Proxy residential tĩnh (ISP) | IP cấp residential cố định | Phiên đăng nhập và công việc giám sát dài hạn |
So sánh các nhà cung cấp trong hướng dẫn của chúng tôi về proxy tốt nhất cho web scraping.
Tính ẩn danh trong web scraping: proxy ẩn gì và không ẩn gì
Proxy ẩn địa chỉ IP thực, nhà cung cấp internet và vị trí của bạn. Đó là nền tảng của tính ẩn danh trong web scraping, nhưng các trang web kiểm tra nhiều thứ hơn là chỉ IP. Nếu bất kỳ tín hiệu nào khác làm lộ bạn, các trang web vẫn có thể liên kết và chặn các yêu cầu của bạn.
Sử dụng danh sách kiểm tra năm điểm này:
Địa chỉ IP: định tuyến mọi yêu cầu qua proxy và khớp quốc gia của nó với dữ liệu bạn cần.
Browser fingerprint: các trang web đọc kích thước màn hình, phông chữ và chi tiết thiết bị. Sử dụng trình duyệt thực hoặc headless với profile nhất quán và thực tế.
Cookie và session: giữ cookie riêng biệt cho từng session để việc chặn một session không làm lộ các session khác.
Thời gian yêu cầu: thêm độ trễ ngẫu nhiên. Các yêu cầu được gửi theo khoảng thời gian hoàn toàn đều đặn trông giống tự động hóa.
Header: gửi User-Agent thực tế và Accept-Language khớp với quốc gia của proxy.
Sai lầm phổ biến: Cho rằng chỉ proxy thôi đã làm cho scraper trở nên vô hình. Fingerprint giống hệt nhau và thời gian hoạt động như robot vẫn có thể liên kết các yêu cầu của bạn.
Cách chọn proxy cho web scraping
Chọn loại phù hợp với mục tiêu: residential cho các trang web được bảo vệ, datacenter cho dữ liệu công khai
Kiểm tra tùy chọn phiên: bạn sẽ cần cả rotation và sticky session
Tìm kiếm công cụ tiết kiệm thời gian thiết lập: scraper miễn phí và tích hợp sẵn có thể rút ngắn thời gian thiết lập của bạn hàng ngày
Dùng thử miễn phí trước. Yozh Scraper mã nguồn mở của CyberYozh đi kèm với các preset sẵn có cho các trang web như Amazon và Google. Làm theo hướng dẫn thiết lập Yozh Scraper để chạy lần scrape đầu tiên của bạn trong vài phút.
Scrape không bị chặn. Nhận proxy web scraping của CyberYozh với hơn 100 triệu IP residential tại hơn 195 quốc gia và sticky session lên đến 24 giờ.