
Proxy cho web scraping
Thu thập dữ liệu sản phẩm, SERP, giá cả và dữ liệu web khác ở quy mô lớn với tỷ lệ thành công hoạt động 99,95%, không để việc chặn IP hoặc hạn chế địa lý làm chậm quy trình làm việc của bạn. Hơn 100 triệu IP residential, proxy di động LTE/5G thực và proxy datacenter tại hơn 195 quốc gia cho các tác vụ đòi hỏi khắt khe nhất.
Proxy web scraping tốt nhất
Chọn proxy tốt nhất để scrape bất kỳ nền tảng và khối lượng nào với hơn 100 triệu IP proxy residential, mobile 4G/5G thực và datacenter. Kiểm tra chất lượng IP và fraud score trước khi bắt đầu để không có IP xấu nào làm gián đoạn scraper của bạn giữa chừng.
Thu thập dữ liệu địa phương ở bất kỳ quốc gia nào
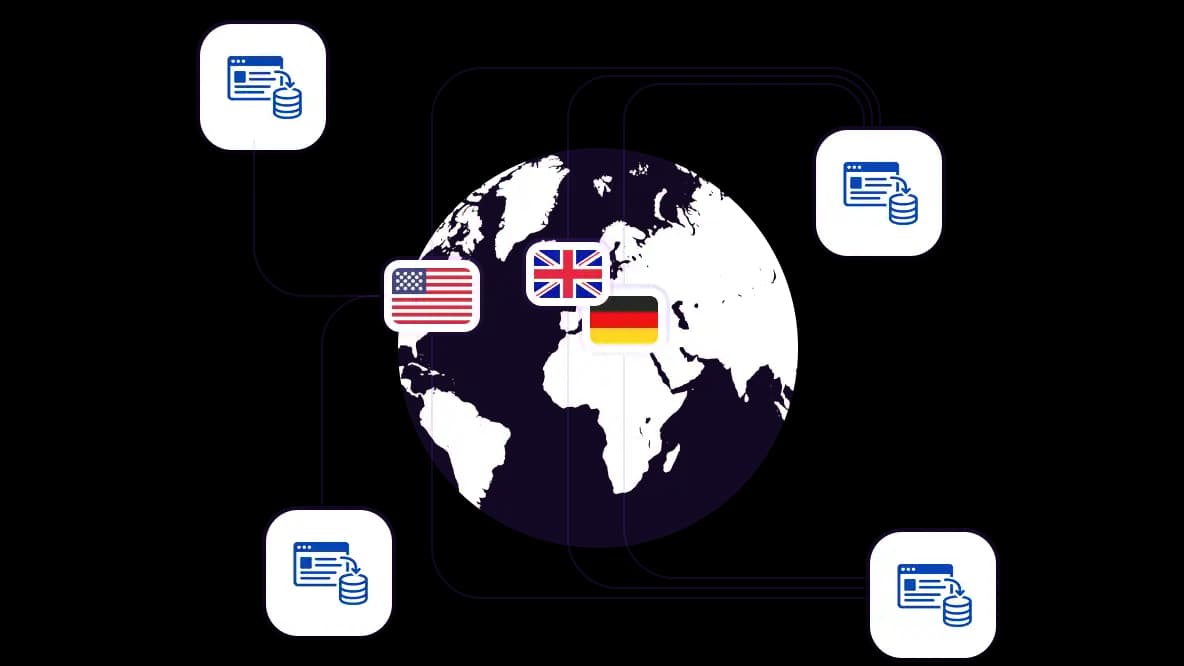
Thu thập giá cả, SERP, danh sách sản phẩm và dữ liệu phụ thuộc vị trí khác với phạm vi proxy trên 195+ quốc gia và khả năng nhắm mục tiêu chi tiết đến cấp thành phố và mã bưu điện. Nhận kết quả chính xác mà không bị sai lệch vị trí.
Tự động hóa và chạy scraping với ít gián đoạn hơn
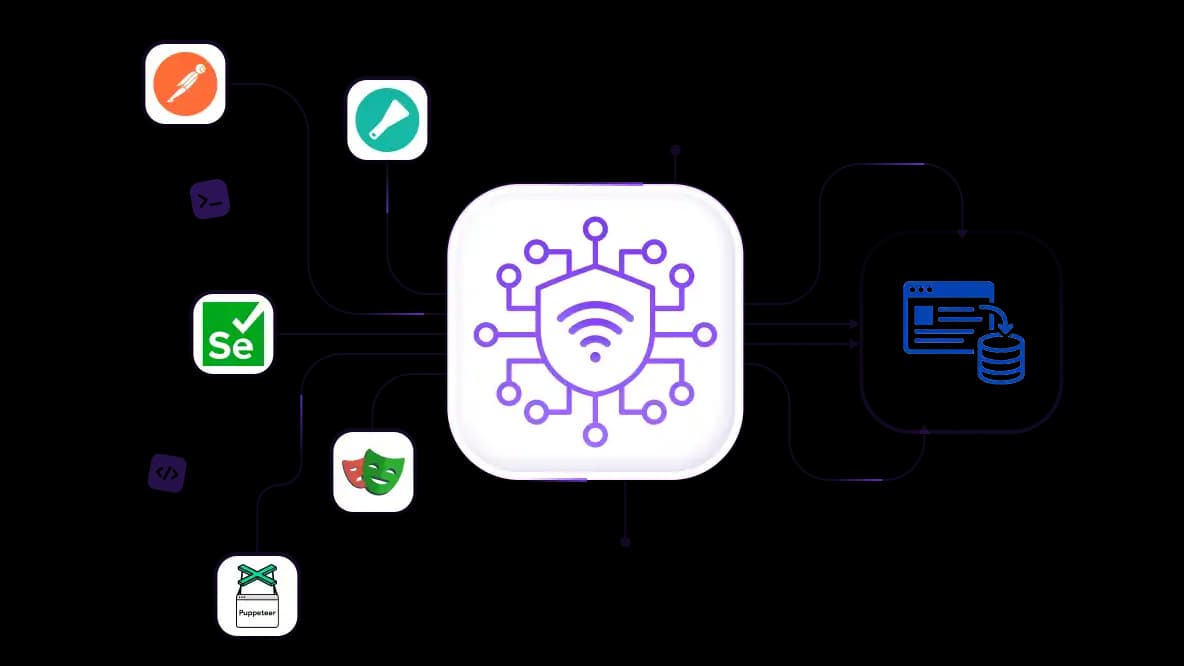
Kết nối proxy với Playwright, Scrapy, Selenium, Puppeteer, Postman hoặc các công cụ tùy chỉnh thông qua API của CyberYozh App. Khả năng xoay vòng IP linh hoạt và kiểm soát phiên giúp giảm thiểu gián đoạn CAPTCHA, giới hạn tốc độ và các lần chặn khi bạn mở rộng quy mô thu thập.
Mở rộng quy mô thu thập dữ liệu với lưu lượng không giới hạn
CyberYozh cung cấp băng thông không giới hạn cho proxy di động và trung tâm dữ liệu, giúp bạn có thể thu thập dữ liệu từ các danh mục lớn, theo dõi giá liên tục hoặc thu thập các trang có nhiều hình ảnh mà không phải lo lắng về việc mỗi gigabyte sẽ tính thêm phí.
Khớp proxy với dấu vân tay trình duyệt của bạn
Chuyển đổi dấu vân tay hệ điều hành giúp căn chỉnh môi trường trình duyệt và proxy, giảm thiểu các tín hiệu hệ điều hành và IP xung đột có thể kích hoạt kiểm tra. Kết hợp proxy CyberYozh với bất kỳ trình duyệt chống phát hiện nào để giữ vị trí proxy, múi giờ và hồ sơ trình duyệt nhất quán trong các phiên scraping.
Đặc biệt dành cho bạn
Proxy tốt nhất theo từng quốc gia

Web scraping - mạng di động không giới hạn chuyên dụng
-
Bộ định tuyến 5G chuyên dụng
-
Socks5/VPN với DNS riêng
-
Thay đổi IP thủ công
-
Thay đổi dấu vân tay p0f (Windows, macOS, Android)
-
Độ tin cậy cao
-
Tốc độ rất cao + độ trễ thấp
-
Tất cả thông số mạng 1:1 như nhà cung cấp
Web scraping - mạng di động dùng chung
-
Bộ định tuyến 5G dùng chung
-
Hỗ trợ SOCKS5 với UDP
-
Tối đa 5 người dùng mỗi cổng
-
Socks5 / HTTP
-
Xoay IP: mỗi 30 phút
-
Dấu vân tay p0f Windows
-
Độ tin cậy cao
-
Tốc độ rất cao + độ trễ thấp
-
Tất cả thông số mạng 1:1 như nhà cung cấp
Web scraping - r résident xoay vòng
-
Có sẵn 24 giờ
-
ISP thực tế
-
Tốc độ lên đến 10 Mbps
-
Truy cập API đầy đủ
-
Giao thức HTTP
-
Hơn 100M IP tại hơn 100 quốc gia
-
Trình tạo thông tin đăng nhập hàng loạt
-
Phiên dài lên đến 6 giờ
Web scraping - residential riêng tư
-
Băng thông không giới hạn
-
ISP thực tế
-
Tốc độ lên đến 150 Mbps
-
Độ trễ thấp
-
Hỗ trợ SOCKS5 với UDP
-
Có sẵn 24 giờ
-
1 IP chuyên dụng
Web scraping - datacenter chuyên dụng
-
Băng thông không giới hạn
-
Quyền sở hữu IP độc quyền
-
Kết nối tốc độ cao
-
Thời gian hoạt động 99.9 %
-
HTTP
Web scraping - datacenter dùng chung
-
Tốc độ cực nhanh
-
Phủ sóng IP toàn cầu
-
Thời gian hoạt động 99.9 %
-
Gói dịch vụ tiết kiệm chi phí
-
1 GB băng thông
-
HTTP
Tại sao họ mua hàng của chúng ta?
Ưu điểm
Thanh toán bằng thẻ riêng
Không quan trọng bạn đã nạp tiền vào số dư của mình bằng cách nào, việc liên kết khoản thanh toán với việc thuê một proxy cụ thể là không thể.
Chúng tôi không lưu trữ dữ liệu trên máy chủ.
Theo quy định, các dịch vụ cho thuê proxy sẽ lưu giữ tất cả dữ liệu về lưu lượng truy cập đi qua máy chủ của họ.
Thiết bị chuyên dụng
Chúng tôi KHÔNG ngụy trang proxy chia sẻ thành proxy cá nhân. Một modem hoặc router chỉ được chuyển giao cho DUY NHẤT một người.
Hỗ trợ kỹ thuật trực tuyến
Chúng tôi luôn sẵn sàng giải quyết các vấn đề và thắc mắc của bạn, kể cả vào đêm khuya hay sáng sớm.
Đảm bảo hoàn tiền
Chúng tôi có cả hoàn trả và đổi hàng. Ưu tiên hàng đầu là dịch vụ chất lượng và khách hàng hài lòng.
API cho Doanh nghiệp
Đối với khách hàng doanh nghiệp, dịch vụ của chúng tôi sẵn sàng cung cấp một API tiện lợi cho phép bạn mua proxy, thay đổi địa chỉ IP và nhiều tính năng khác.
Tại sao bạn cần proxy cho scraping
Scraping ở ","2">quy mô lớn scraping nhanh chóng thất bại khi bạn gửi hàng nghìn request từ cùng một IP. Các nền tảng phản ứng bằng cách giới hạn tốc độ, hiển thị ","4">CAPTCHA CAPTCHA, chặn, hoặc âm thầm phục vụ nội dung khác với những gì khách truy cập ở quốc gia khác sẽ thấy. Nếu không có proxy:
Cấm IP: một địa chỉ thực hiện các request lặp lại dễ dàng bị hạn chế.
Giới hạn tốc độ: các lần crawl khối lượng lớn bị giới hạn tốc độ trước khi tập dữ liệu hoàn tất.
Hạn chế địa lý: giá cả, danh sách và kết quả tìm kiếm thay đổi theo quốc gia và thành phố, do đó một vị trí duy nhất cung cấp cho bạn dữ liệu không đầy đủ hoặc gây hiểu lầm.
Điểm lỗi đơn: một IP bị gắn cờ làm trì hoãn toàn bộ công việc.
Tín hiệu không khớp: ngay cả một IP sạch cũng kích hoạt CAPTCHA và lỗi 403 nếu dấu vân tay trình duyệt, múi giờ hoặc ngôn ngữ của bạn không khớp với kết nối.
Proxy residential của CyberYozh được thiết kế để hỗ trợ scraping khối lượng lớn. Với hơn 100 triệu IP residential tại hơn 195 quốc gia, cộng với ","17">mobile không giới hạn mobile không giới hạn và IP datacenter. Chuyển đổi dấu vân tay hệ điều hành giúp căn chỉnh tín hiệu trình duyệt của bạn với IP bạn đang sử dụng để bạn không bị chặn khi mở rộng quy mô.
Chọn proxy tốt nhất cho scraping từ danh mục CyberYozh
Web scraping proxy mang lại lợi ích gì cho quy trình làm việc chuyên nghiệp của bạn
Trích xuất dữ liệu thương mại điện tử và giám sát giá
Amazon, eBay và AliExpress thay đổi giá và hàng tồn kho theo khu vực, và giới hạn tốc độ các IP yêu cầu hàng nghìn trang sản phẩm. Proxy datacenter xử lý các trang danh mục ít hạn chế, trong khi proxy residential luân phiên với nhắm mục tiêu cấp thành phố xử lý các trang sản phẩm và đánh giá được bảo vệ.
Kết quả: Bạn nhận được danh mục đầy đủ và giá chính xác theo vị trí thay vì những khoảng trống từ các request bị chặn.
SERP scraping
Google và Bing phục vụ kết quả khác nhau theo vị trí và gắn cờ các truy vấn lặp lại từ cùng một IP hoặc hiển thị CAPTCHA. Sử dụng proxy residential luân phiên cho xếp hạng desktop và proxy mobile carrier cho kết quả mobile, thường khác với desktop.
Kết quả: Dữ liệu xếp hạng của bạn giờ đây khớp với những gì người tìm kiếm ở mỗi thị trường thấy trên mỗi thiết bị.
Tìm hiểu thêm về các trường hợp sử dụng proxy web scraping
Thu thập dữ liệu mạng xã hội
Instagram, TikTokvà Facebook nhanh chóng gắn cờ các dải datacenter và liên kết chặt chẽ các phiên với IP. Proxy di động trên mạng nhà mạng thực mang lại độ tin cậy cao nhất, và proxy residential tĩnh duy trì danh tính nhất quán cho việc thu thập khi đã đăng nhập.
Kết quả: Bạn thu thập hồ sơ công khai, bài đăng và dữ liệu tương tác với ít thách thức hoặc phiên bị ngắt hơn.
Thu thập dữ liệu huấn luyện AI
Bộ dữ liệu được xây dựng từ các cổng tin tức, Reddit, trang tài liệu và trang sản phẩm cần hàng triệu yêu cầu, và việc chặn để lại khoảng trống cũng như thiên lệch khu vực trong kho dữ liệu. Proxy cũng phù hợp với giám sát giá AI và thu thập dữ liệu huấn luyện AI. Proxy datacenter xử lý các nguồn mở với chi phí thấp, trong khi proxy residential xoay vòng xử lý các nguồn được bảo vệ.
Kết quả: Bạn có phạm vi bao phủ rộng hơn và đồng đều trên các nguồn và quốc gia, được tính phí theo GB nên bạn chỉ trả cho lưu lượng bạn sử dụng.
Dùng thử Yozh Scraper ngay hôm nay
Yozh Scraper là công cụ scraper Playwright miễn phí, mã nguồn mở của CyberYozh. Nó kết nối với proxy residential xoay vòng của CyberYozh, vì vậy bạn có công cụ trích xuất và IP từ một nguồn duy nhất.
Miễn phí & mã nguồn mở — scraper + crawler đầy đủ, tự lưu trữ, không tính phí theo yêu cầu
10 cài đặt sẵn — Amazon, eBay, Walmart, Google và nhiều hơn nữa
Tích hợp MCP — kết nối trực tiếp vào Claude, Cursor hoặc bất kỳ MCP client nào
Loại proxy nào tốt nhất cho từng tác vụ web scraping
Proxy phù hợp cho web scraping phụ thuộc vào nền tảng, khối lượng yêu cầu, vị trí và yêu cầu phiên. Proxy datacenter hoạt động tốt cho việc thu thập nhanh từ các nguồn ít hạn chế hơn, trong khi proxy residential và di động phù hợp với các mục tiêu mà ở đó danh tiếng IP, vị trí hoặc tính ổn định phiên quan trọng.
Loại proxy | Phù hợp nhất cho | Tại sao nên sử dụng |
Datacenter proxies | Catalog công khai, tài liệu, API mở | Nhanh và tiết kiệm chi phí cho các mục tiêu có hạn chế IP nhẹ hơn |
Rotating residential proxies | Amazon, eBay, Google, SERP, giám sát giá | Xoay vòng IP và nhắm mục tiêu vị trí cụ thể khi khối lượng scraping hoặc uy tín IP quan trọng |
Bảng điều khiển người bán, tài khoản đã đăng nhập, phiên dài hạn | Giữ IP residential ổn định trong suốt quy trình scraping nhiều bước | |
Mobile proxies | Instagram, TikTok, SERP di động, dữ liệu đặc thù nhà mạng | Định tuyến yêu cầu qua mạng nhà mạng di động thực khi các mục tiêu xử lý lưu lượng di động khác biệt |
Rotating và sticky sessions cho web scraping: khi nào chọn loại nào
Rotating sessions cung cấp cho bạn một IP mới với mỗi yêu cầu. Đây là lựa chọn mặc định phù hợp cho các công việc độc lập — kiểm tra giá, truy xuất SERP, danh sách sản phẩm — nơi khối lượng quan trọng và không có gì để mất khi chuyển đổi địa chỉ giữa các lần truy cập.
Sticky sessions giữ cùng một IP trong một khoảng thời gian nhất định, từ 5 phút đến vài giờ. Sử dụng chúng khi tính liên tục quan trọng: đăng nhập, giỏ hàng, luồng nhiều bước, bất cứ thứ gì mà việc thay đổi địa chỉ giữa chừng sẽ phá vỡ phiên.
Quy tắc thực tế: xoay vòng cho khối lượng, giữ nguyên cho trạng thái. Hầu hết các hoạt động thực tế sử dụng cả hai — xoay vòng trên web mở, giữ nguyên bên trong bất cứ thứ gì hoạt động như một phiên người dùng.
CyberYozh hỗ trợ cả hai chế độ, với sticky sessions có sẵn lên đến 24 giờ và xoay vòng thủ công cũng như dựa trên API. Điều chỉnh xoay vòng proxy cho tác vụ của bạn thay vì thỏa hiệp ở mọi nơi.
Đọc hướng dẫn của chúng tôi về tự động hóa web scraping
Cách thiết lập scraping proxy
1. Chọn loại proxy của bạn. Residential hoặc mobile cho các mục tiêu được bảo vệ; datacenter cho các trang web nhanh, ít hạn chế hơn.
2. Lấy thông tin xác thực của bạn. Host, port, username, password và chế độ xoay vòng bạn chọn — per-request hoặc sticky.
3. Cấu hình scraper của bạn. Chỉ định yêu cầu qua proxy endpoint trước khi thực hiện một lệnh gọi duy nhất.
4. Xác minh IP đầu ra. Kiểm tra IP và vị trí được trả về để xác nhận lưu lượng đang định tuyến qua proxy.
5. Đặt xoay vòng phù hợp với mục tiêu. Xoay vòng các yêu cầu độc lập; sử dụng sticky sessions khi quy trình phụ thuộc vào cùng một IP. Điều chỉnh nếu mục tiêu bắt đầu trả về 403 hoặc CAPTCHA.
Cách thiết lập trong Playwright:
PROXY = {

    "server": "http://gate.cyberyozh.net:10000",

    "username": "user123-us-s-session1",

    "password": "your_password"

}

with sync_playwright() as p:

    browser = p.chromium.launch(proxy=PROXY)

    page = browser.new_page()

    page.goto("https://api.ipify.org")

    print(page.inner_text("body"))

browser.close()Chuyển đổi trình duyệt trong Playwright
Playwright hỗ trợ nhiều engine trình duyệt. Chuyển từ Chromium sang Firefox hoặc WebKit bằng cách thay đổi chính xác một dòng code. Khớp engine với yêu cầu của trang web mục tiêu.
# For Firefox

browser = p.firefox.launch(proxy=PROXY)

# For WebKit (Safari engine)

browser = p.webkit.launch(proxy=PROXY)
Thiết lập xong, xác minh kết nối, sau đó để hạ tầng proxy xử lý việc định tuyến.
Tại sao nên dùng CyberYozh cho web scraping
CyberYozh cung cấp hạ tầng proxy để chạy các công việc scraping trên nhiều mục tiêu, vị trí và khối lượng request mà không cần xây dựng thiết lập proxy riêng cho từng workflow. Chọn loại IP, vị trí và hành vi session phù hợp với mục tiêu.
Hơn 100 triệu IP residential tại hơn 195 quốc gia
Proxy mobile LTE/5G thực với băng thông không giới hạn
Proxy datacenter cho scraping nhanh và tiết kiệm chi phí
Số ảo cho SMS và thẻ ảo trên một nền tảng
Session sticky + rotating cho các yêu cầu workflow khác nhau
Kiểm tra điểm IP/fraud để đánh giá chất lượng IP trước khi sử dụng
Tích hợp API với Scrapy, Selenium, Playwright, Postman và các script tùy chỉnh.
Khách hàng nói gì về chúng tôi trên Trustpilot
Bắt đầu scraping với proxy CyberYozh
Xây dựng scraper của bạn xung quanh hạ tầng proxy có thể xử lý mục tiêu, khối lượng và vị trí mà workflow của bạn yêu cầu. Chọn từ proxy residential, mobile và datacenter và kết nối thông qua các công cụ bạn đã sử dụng.
Với hơn 100 triệu IP residential tại hơn 195 quốc gia, CyberYozh cung cấp phạm vi IP và kiểm soát session để mở rộng quy mô thu thập dữ liệu mà không cần xây dựng lại thiết lập scraping của bạn.
Chọn proxy của bạn và bắt đầu scraping
Nạp tiền vào số dư của bạn bằng bất kỳ cách thuận tiện nào!
Thẻ ngân hàng


Tiền điện tử


