Cách thiết lập proxy trong Playwright cho web scraping
Playwright là một framework web scraping và tự động hóa hiện đại hỗ trợ nhiều ngôn ngữ lập trình và tích hợp tốt với các proxy CyberYozh để tăng cường bảo mật và độ ổn định phiên. Tại đây, hãy tìm hiểu cách thiết lập Playwright và đảm bảo công việc của bạn được hoàn thành tốt.
Chuẩn bị: Lựa chọn proxy để sử dụng với Playwright
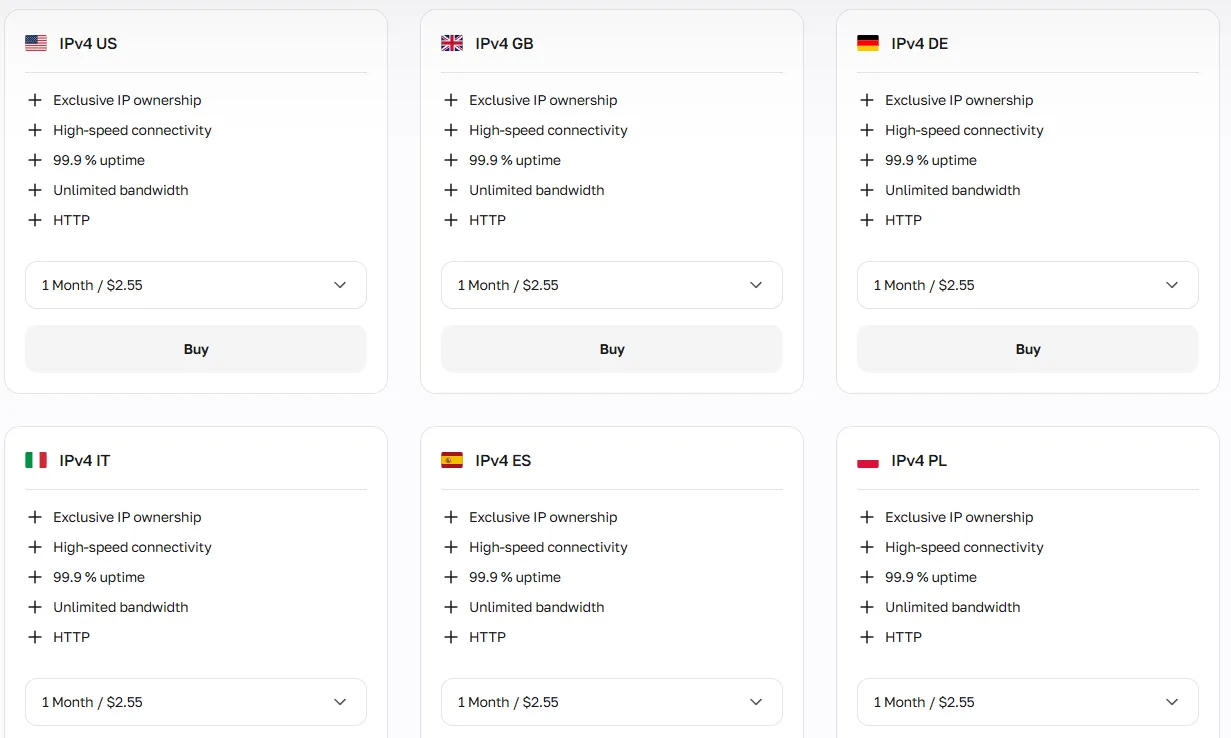
Trước khi cấu hình tích hợp proxy Playwright, bạn phải xây dựng hạ tầng scraping/tự động hóa phù hợp. Loại proxy của bạn quyết định mức độ tin cậy, độ ổn định phiên, tốc độ và cách các nền tảng nhận thức lưu lượng truy cập của bạn.
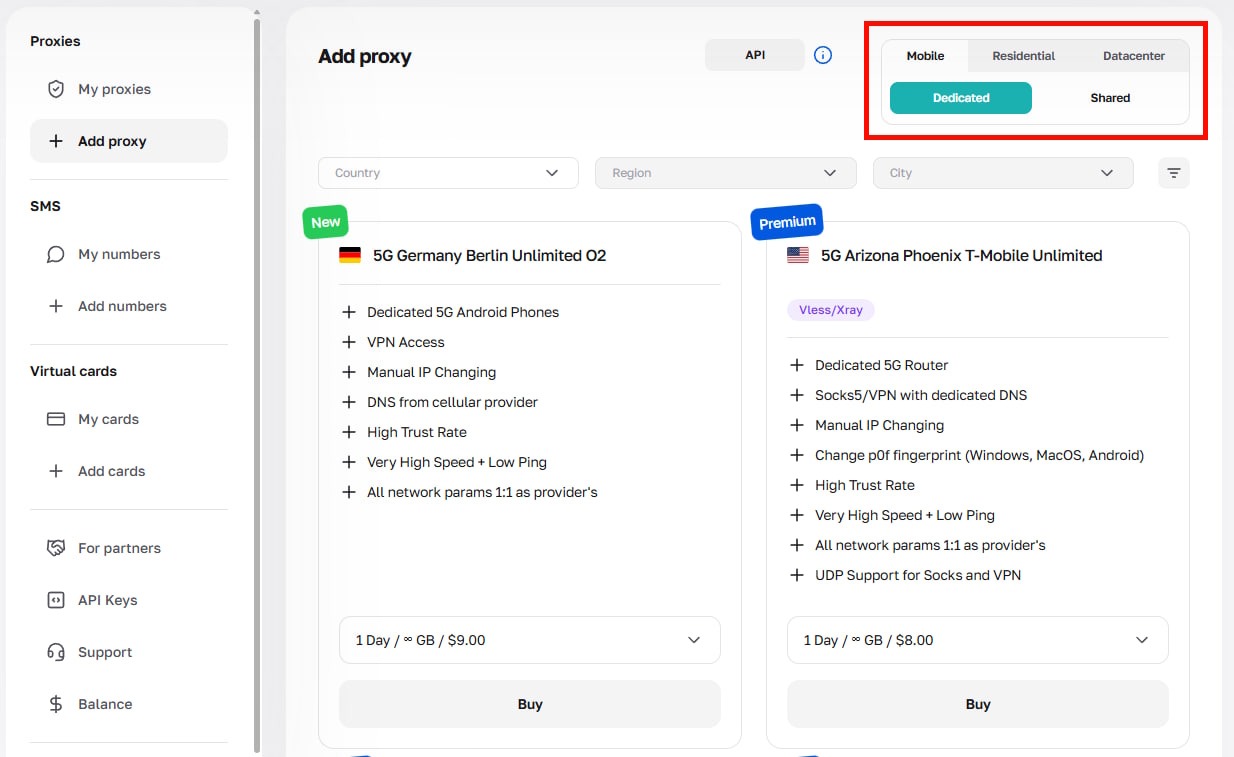
Mobile proxy: Dữ liệu mạng xã hội, geotargeting chính xác và Google SERP
Mobile proxy có tỷ lệ tin cậy cao nhất tuyệt đối trong tất cả các loại proxy. Chúng là lựa chọn bắt buộc cho việc trích xuất dữ liệu mạng xã hội như Instagram, TikTokvà Snapchat. Bạn cũng có thể triển khai hạ tầng mobile LTE/5G cho việc scraping Google SERP đa luồng, hoạt động 24/7. Các nhà mạng di động sử dụng công nghệ CGNAT, ẩn hàng nghìn người dùng smartphone thực sau một địa chỉ IP duy nhất. Google không thể chặn các node này mà không ngắt kết nối toàn bộ khu vực. Kiến trúc này cung cấp cho bạn lưu lượng không giới hạn để mở rộng các parser vô hạn mà không phải trả tiền theo gigabyte.
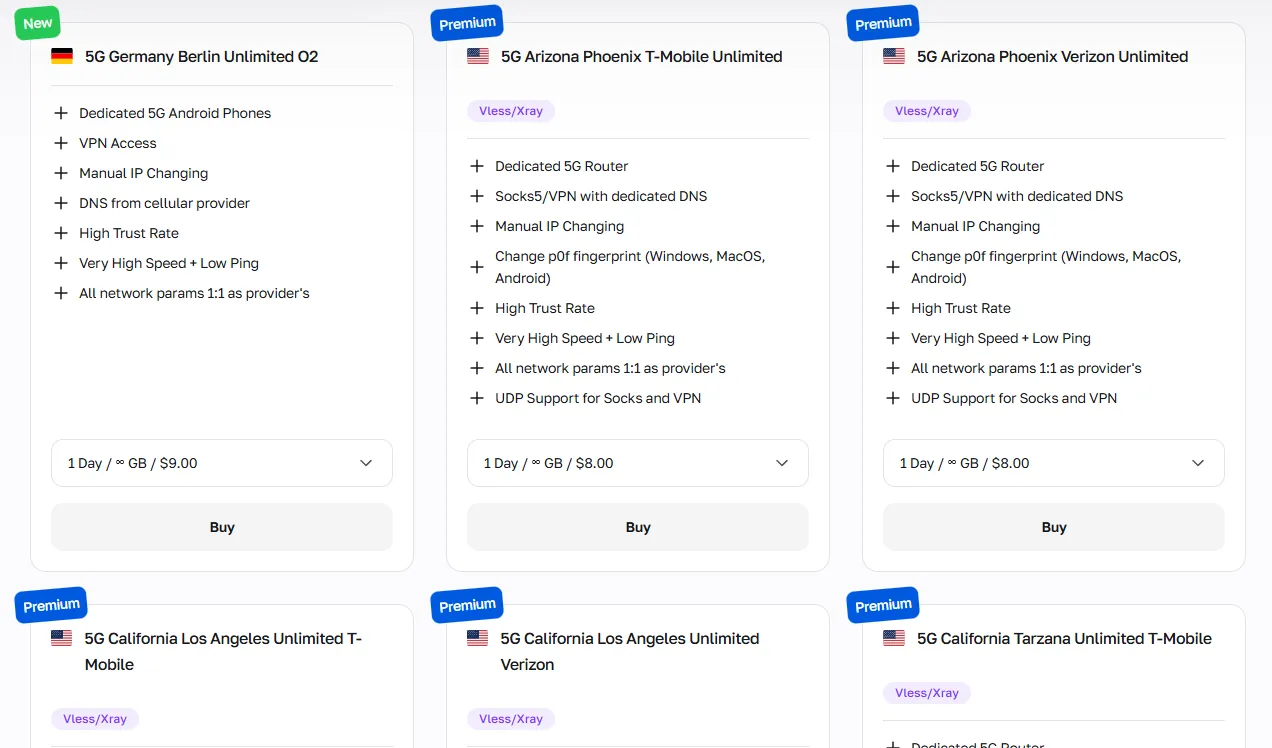
CyberYozh mobile proxy cung cấp khả năng tùy chỉnh cao cho geotargeting chính xác, cài đặt fingerprint và lưu lượng không giới hạn; lý tưởng khi bạn cần Playwright mô phỏng một người dùng mobile thực.
Residential proxy: Scraping dữ liệu và tự động hóa tổng quát
Residential proxy được chia thành hai loại dựa trên trường hợp sử dụng của bạn:
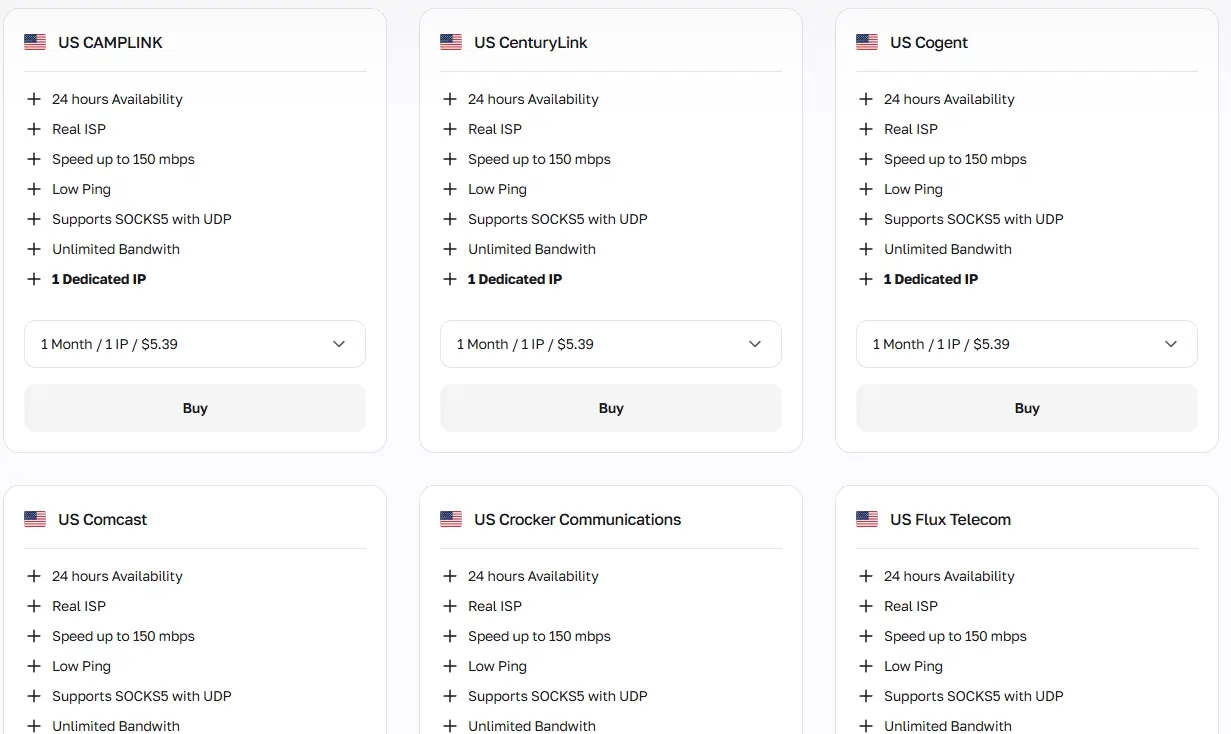
Static residential proxy cung cấp một IP residential cố định từ một quốc gia cụ thể, được các nền tảng nhận thức như một người dùng Internet gia đình thông thường. Chúng lý tưởng cho các quy trình làm việc liên kết tài khoản.
Rotating residential proxy tận dụng hạ tầng hơn 100 triệu IP trên hơn 195 quốc gia. Bạn có thể xoay vòng địa chỉ trên mỗi yêu cầu hoặc duy trì sticky session lên đến 24 giờ. Chúng tạo thành nền tảng cần thiết cho tự động hóa hàng loạt, web scraping quy mô lớn và cung cấp ngữ cảnh mạng ổn định cho các AI agent hiện đại như Crawl4AI và Open Scraper.
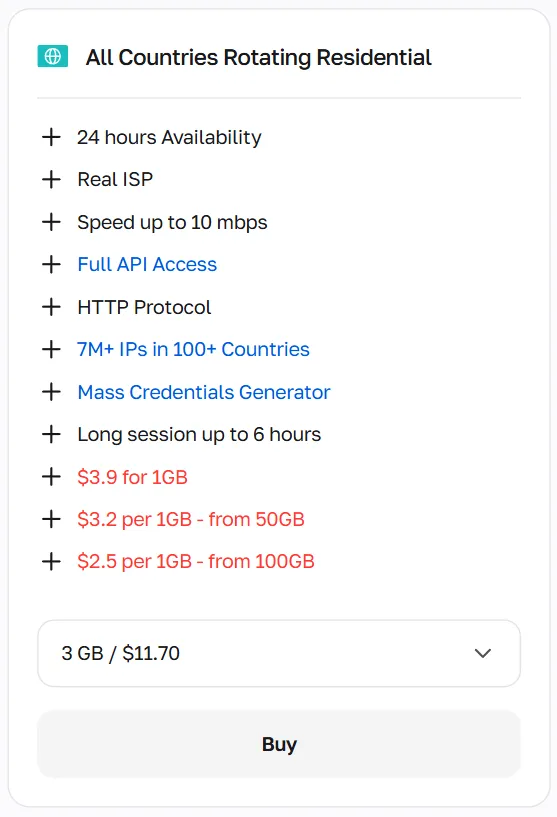
Chọn static residential IP cho quản lý tài khoản dài hạn, với sơ đồ 1 IP = 1 tài khoản, trong khi rotating IP được yêu cầu cho tất cả các hoạt động web hàng loạt, với chiến lược xoay vòng IP phù hợp dựa trên từng trường hợp sử dụng cụ thể.
Datacenter proxy: Cơ sở dữ liệu mở và kiểm thử ứng dụng
Datacenter proxy cung cấp tốc độ kết nối nhanh nhất, nhưng được liên kết với lưu lượng truy cập không phải residential, giống bot. Chúng hoạt động tốt cho việc scraping cơ sở dữ liệu mở, kiểm thử API và các tác vụ tốc độ cao nơi các nền tảng áp dụng phát hiện bot tối thiểu, nhưng có thể bị hạn chế nhanh chóng trên các nền tảng mạng xã hội như Reddit hoặc LinkedIn.
Công cụ bổ sung: Đánh giá rủi ro trước khi thực thi
CyberYozh cung cấp IP Checker quét mọi địa chỉ IP với các cơ sở dữ liệu gian lận lớn để trả về Fraud Score nghiêm ngặt và lịch sử đầy đủ. Triển khai quy trình "Đánh giá rủi ro trước khi thực thi". Chạy IP của bạn qua trình kiểm tra trước khi khởi chạy browser instance. Điều này đánh giá mức độ rủi ro thực tế của bạn và giúp duy trì tỷ lệ thành công hoạt động cao, thay thế hoàn toàn các đảm bảo "chống cấm" sai lệch.
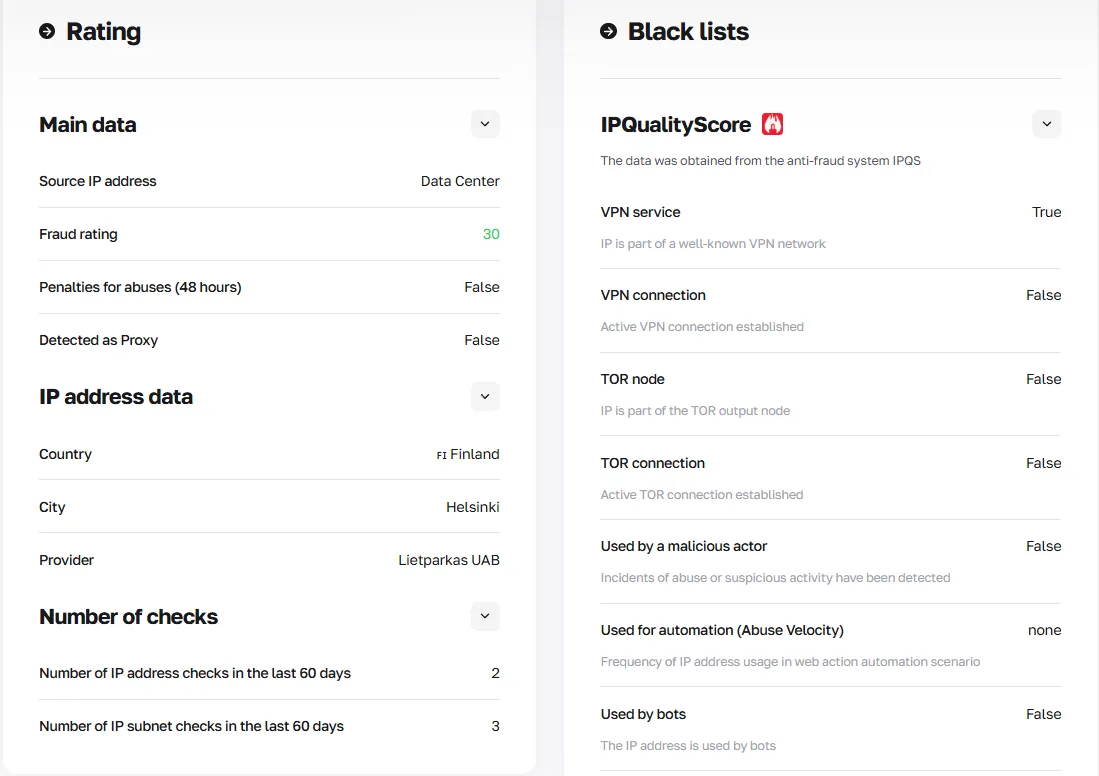
Nhận quyền truy cập CyberYozh API để tự động hóa xoay vòng IP và kiểm tra mọi địa chỉ IP đến trước khi xoay vòng, đảm bảo chất lượng của nó.
Bắt đầu với cài đặt Playwright: Lựa chọn ngôn ngữ
Playwright hỗ trợ bốn ngôn ngữ. Trước khi bạn bắt đầu cài đặt Playwright và cấu hình proxy, hãy chọn ngôn ngữ phù hợp với stack của bạn. Hướng dẫn này sử dụng Python, là lựa chọn được sử dụng phổ biến nhất cho các quy trình làm việc với proxy, nhưng cả bốn tùy chọn đều được đề cập trong bảng và hướng dẫn ngắn bên dưới.
Ngôn ngữ | Điểm khác biệt chính | Trường hợp sử dụng chính | Khi nào nên chọn |
Node.js (JS/TS) | Ngôn ngữ Playwright mặc định; hỗ trợ TypeScript sẵn có; cộng đồng và tài liệu lớn nhất | Kiểm thử end-to-end, tự động hóa trình duyệt, frontend CI/CD | Nhóm của bạn làm việc với JS/TS, hoặc bạn cần bộ công cụ trưởng thành nhất |
Python | Được sử dụng rộng rãi nhất trong scraping/ML; async thông qua asyncio; tích hợp với Requests, Scrapy | Web scraping, data pipeline, tự động hóa proxy, thu thập dữ liệu ML | Bạn cần scraping sử dụng nhiều proxy hoặc tích hợp khoa học dữ liệu |
.NET (C#) | Phân phối qua NuGet; strong typing, tốt cho QA doanh nghiệp | Tự động hóa kiểm thử doanh nghiệp, ứng dụng .NET | Tổ chức của bạn sử dụng .NET stack |
Java | Phân phối qua Maven/Gradle; tích hợp JUnit | Ứng dụng doanh nghiệp Java, kiểm thử liên quan đến Android | Dự án của bạn dựa trên Java hoặc yêu cầu hệ sinh thái JVM |
Node.js
Ngôn ngữ Playwright mặc định và được tài liệu hóa đầy đủ nhất. TypeScript được hỗ trợ sẵn có: Playwright được cài đặt bằng npm, không cần cấu hình thêm.
npm init playwright@latestPython
Ngôn ngữ ưu tiên cho các tác vụ proxy Playwright, scraping và tự động hóa dữ liệu. Yêu cầu Python 3.8+ và thường được cài đặt qua PyPI (pip).
pip install playwright

playwright install
.NET (C#)
Phân phối dưới dạng gói NuGet. Yêu cầu PowerShell (pwsh) để chạy bước cài đặt trình duyệt.
dotnet new console -n PlaywrightDemo

cd PlaywrightDemo

dotnet add package Microsoft.Playwright

dotnet build

pwsh bin/Debug/netX/playwright.ps1 install
Java
Phân phối dưới dạng module Maven (mvn). Thêm dependency vào pom.xml trong Maven, và các trình duyệt sẽ tự động tải xuống khi biên dịch lần đầu.
<dependency>

  <groupId>com.microsoft.playwright</groupId>

  <artifactId>playwright</artifactId>

  <version>1.59.0</version>

</dependency>
Sau đó chạy lệnh:
mvn compile exec:java -D exec.mainClass="org.example.App"Thiết lập proxy Playwright với Python
Ở đây, chúng ta sẽ khám phá cách triển khai phiên scraping Playwright tổng quát với proxy CyberYozh. Mặc dù ngôn ngữ Playwright mặc định là Node.js/TypeScript, chúng ta sẽ sử dụng Python trong ví dụ này, vì Playwright với Python được sử dụng rộng rãi cho tự động hóa web, scraping và các tác vụ liên quan đến proxy khác. Nếu bạn cần sử dụng TypeScript hoặc có trường hợp sử dụng cụ thể yêu cầu C# hoặc Java, chỉ cần tham khảo phiên bản tài liệu Playwright tương ứng; việc điều chỉnh code khá dễ dàng.
Máy chủ proxy Playwright là một trung gian mạng chuyển tiếp các yêu cầu của trình duyệt thông qua một địa chỉ IP khác. Playwright truyền cấu hình proxy trực tiếp tại thời điểm khởi chạy trình duyệt hoặc cấp độ context, định tuyến toàn bộ lưu lượng qua máy chủ được chỉ định.
1. Lấy proxy cho tác vụ của bạn
Đăng nhập vào tài khoản CyberYozh, điều hướng đến My Proxiesvà chọn loại proxy phù hợp với tác vụ của bạn (mobile, residential static, residential rotating, datacenter).
Sau khi mua, mở thẻ proxy, nhấp Generate Credentials, chọn chế độ rotation của bạn (Random IP, Short Session hoặc Long Session) và điều hướng đến host, port, username và password.
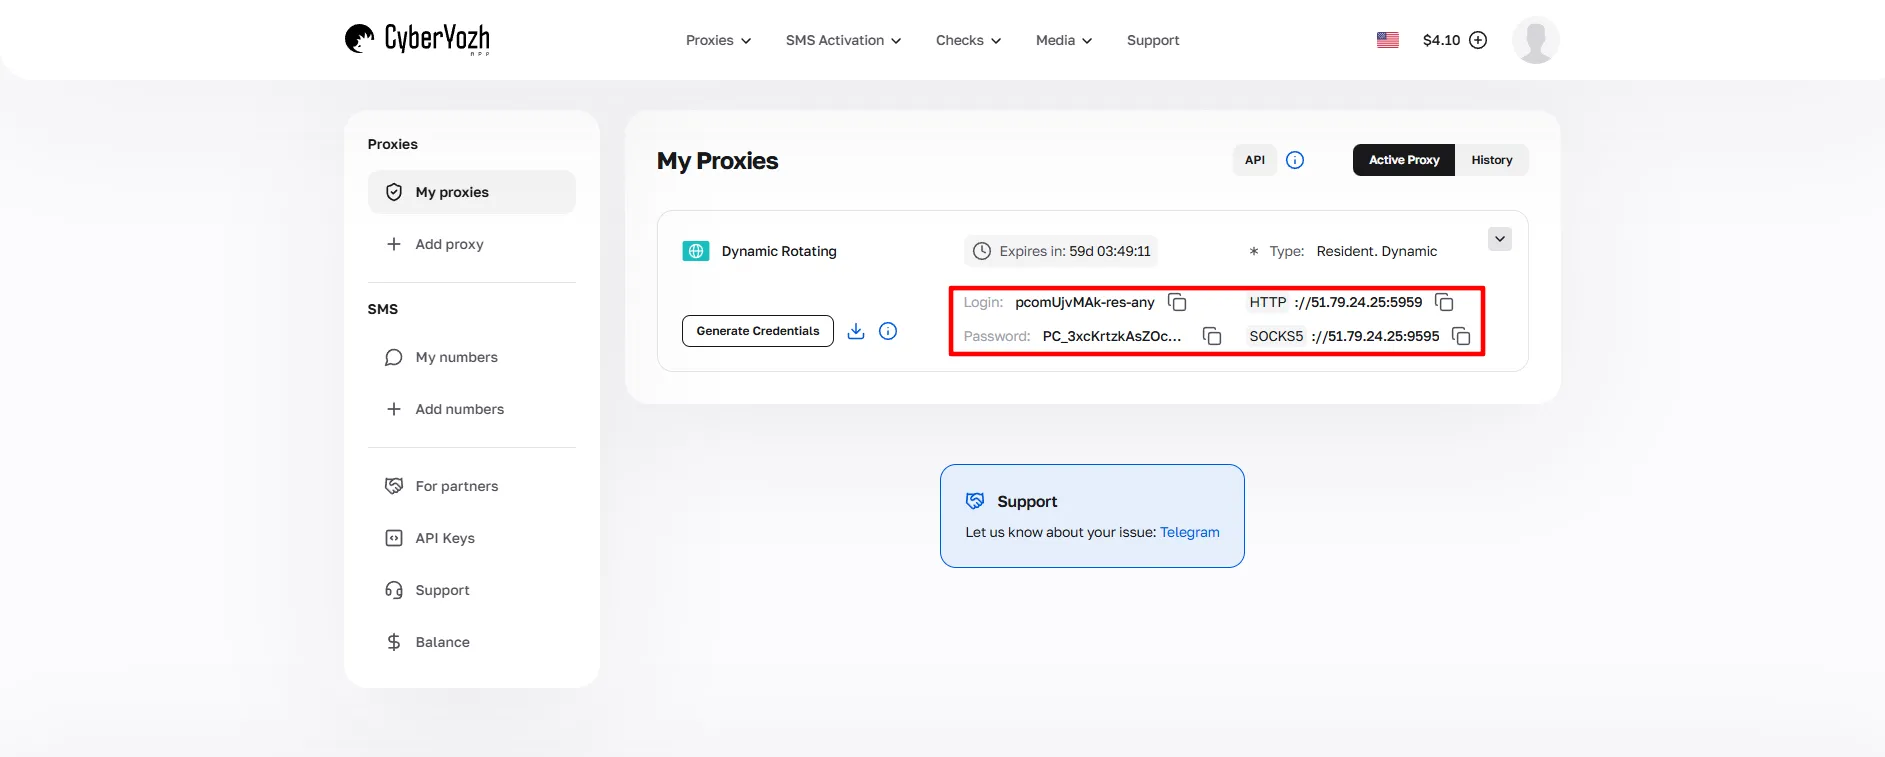
Các thông tin xác thực này sẽ được sử dụng trong suốt quá trình thiết lập.
2. Tải xuống và cài đặt Playwright
Cài đặt thư viện Playwright và các tệp nhị phân trình duyệt qua PyPI:
pip install playwright

playwright install
Lệnh này tải xuống các tệp nhị phân Chromium, Firefox và WebKit. Đối với scraping, Chromium là lựa chọn tiêu chuẩn.
3. Tổ chức cấu trúc dự án
Tạo một thư mục dự án riêng (ví dụ: scraper/). Giữ thông tin xác thực tách biệt khỏi code của bạn và xác định đường dẫn output rõ ràng cho dữ liệu đã scrape:
-Tài liệu .env cho thông tin xác thực proxy (luôn thêm vào .gitignore)
-scraper.py làm script Playwright chính
-requirements.txt cho các dependencies
output/ thư mục cho dữ liệu đã scrape (CSV/JSON)
4. Thêm cấu hình proxy vào tệp .env
Mở tệp .env của bạn trong VS Code hoặc bất kỳ trình soạn thảo nào và sao chép-dán thông tin xác thực CyberYozh của bạn. Luôn thêm .env vào .gitignore để ngăn chặn rò rỉ thông tin xác thực vào các kho lưu trữ version control.
HTTP_PROXY=http://username:password@proxy-server-ip:host
SOCKS5_PROXY=socks5://username:password@proxy-server-ip:host
Đối với cấu hình proxy Playwright SOCKS5, sử dụng scheme socks5://. Đối với sử dụng proxy Playwright HTTP tiêu chuẩn, sử dụng scheme http://. Đảm bảo bao gồm các cổng chính xác từ dashboard CyberYozh. Nếu bạn sử dụng API CyberYozh, API key của bạn cũng phải được chỉ định ở đây.
CYBERYOZH_API_KEY=Your_API_URL_Key5. Tạo script scraping/tự động hóa
Tạo file test Python sử dụng Playwright. Nó nên có cấu trúc gần như sau:
Tạo browser entity và context entity với cài đặt proxy
Thiết lập rotation tự động và kiểm tra IP qua CyberYozh API
Truy cập website mục tiêu và thực hiện scraping qua thư viện Requests
Thiết lập xử lý lỗi
Chỉ định thư mục output cho dữ liệu đã scrape
Script dưới đây triển khai đầy đủ thiết lập Playwright proxy trong Python: một browser entity, một context entity với xác thực Playwright proxy, rotation IP tự động qua CyberYozh API, thực thi request, xử lý lỗi và xuất file output.
Truy cập tài liệu API của CyberYozh để khám phá cách chính xác bạn có thể triển khai các lệnh API cho việc sử dụng dịch vụ CyberYozh tự động
import asyncio
import os
import json
import requests
from dotenv import load_dotenv
from playwright.async_api import async_playwright

load_dotenv()

PROXY_URL = os.getenv("HTTP_PROXY")  # or SOCKS5, from the .env document
CYBERYOZH_API_KEY = os.getenv("CYBERYOZH_API_KEY") # API key from the .env document
TARGET_URL = "https://httpbin.org/ip" # the website to scrape; here is the test one
OUTPUT_FILE = "output/results.json" # output folder


def check_ip_quality(ip: str) -> bool:

    """Use CyberYozh IP Checker API to verify trust score before rotating."""

    try:

        response = requests.get(
            f"https://app.cyberyozh.com/api/v1/checkers/socks/",
            headers={"Authorization": f"Bearer {CYBERYOZH_API_KEY}"},
            timeout=5
        )

        score = response.json().get("fraud_score", 100)
        return score < 50  # Accept IPs with fraud score below 50

    except Exception:

        return True  # Allow on API error


async def scrape(proxy_url: str) -> dict:

    """Run a single Playwright scraping session with proxy."""

    # Parse proxy credentials for Playwright proxy authentication

    from urllib.parse import urlparse

    parsed = urlparse(proxy_url)

    proxy_config = {
        "server": f"{parsed.scheme}://{parsed.hostname}:{parsed.port}",
        "username": parsed.username,
        "password": parsed.password,
    }


    async with async_playwright() as p:

        # Browser entity (headless to save traffic): launch with proxy server

        browser = await p.chromium.launch(headless=True)
        # Context entity: proxy settings applied per context

        context = await browser.new_context(proxy=proxy_config)
        page = await context.new_page()


        try:

            await page.goto(TARGET_URL, timeout=30000)
            content = await page.inner_text("body")
            result = json.loads(content)
            return {"status": "ok", "ip": result.get("origin")}

        except Exception as e:

            return {"status": "error", "error": str(e)}

        finally:

            await context.close()
            await browser.close()


async def main():

    results = []

    for i in range(5):

        print(f"Request {i+1}: using proxy {PROXY_URL}")
        data = await scrape(PROXY_URL)
        print(f"  → IP: {data.get('ip')} | Status: {data.get('status')}")
        results.append(data)

    os.makedirs("output", exist_ok=True)

    with open(OUTPUT_FILE, "w") as f:

        json.dump(results, f, indent=2)

    print(f"Results saved to {OUTPUT_FILE}")


asyncio.run(main())Xem thêm hướng dẫn liên quan: Cấu hình Proxy Rotation trong Python.
6. Chạy test và rotate proxy
Khởi chạy scraper từ thư mục gốc của project:
python scraper.pyXác minh rằng mỗi request ghi lại một địa chỉ IP khác nhau (xác nhận rotation đang hoạt động) và file output/results.json được điền đầy đủ. Sử dụng CyberYozh API cho rotation tự động và kiểm tra chất lượng tự động qua IP Checker: các proxy có fraud score cao sẽ bị từ chối trước chu kỳ rotation tiếp theo.
Xem thêm: Hướng dẫn Tự động hóa Web Scraping
Tóm tắt: Sử dụng Playwright với hạ tầng CyberYozh
Với Playwright proxy được cấu hình và thông tin xác thực CyberYozh đang hoạt động, bạn có thể chạy scraping đa mục tiêu, tự động hóa geo-targeted và quy trình quản lý tài khoản ở quy mô lớn, định tuyến mọi phiên browser qua các IP residential hoặc mobile sạch với xác thực fraud score, đồng thời xuất dữ liệu có cấu trúc theo định dạng bạn chọn.