Tóm tắt
Thu thập dữ liệu AI là quá trình thu thập và chuẩn bị dữ liệu cho các mô hình machine learning.
Dữ liệu đến từ sáu phương pháp chính: web scraping, API, dữ liệu người dùng first-party, cảm biến, dataset có sẵn và dữ liệu tổng hợp.
Dữ liệu thô không thể sử dụng được cho đến khi được làm sạch, loại bỏ trùng lặp và thường phải gắn nhãn.
Dữ liệu công khai thường được phép sử dụng. Dữ liệu cá nhân và dữ liệu đằng sau đăng nhập có giới hạn pháp lý.
Trả lời nhanh: Thu thập dữ liệu AI là quá trình thu thập văn bản thô, hình ảnh, âm thanh, video hoặc bản ghi và chuẩn bị chúng để huấn luyện, kiểm tra và cải thiện các mô hình machine learning. Các nhóm thu thập dữ liệu thông qua web scraping, API, tương tác người dùng, cảm biến, dataset công khai và tạo dữ liệu tổng hợp, sau đó làm sạch và gắn nhãn trước khi huấn luyện.
Thu thập dữ liệu AI là gì
Đây là bước đầu tiên trong việc xây dựng bất kỳ mô hình machine learning nào. Một mô hình chỉ có thể học các mẫu từ các ví dụ của nó, vì vậy dữ liệu bạn thu thập quyết định những gì nó có thể làm và nơi nó thất bại.
Điều làm cho nó khác biệt so với thu thập dữ liệu thông thường là mục tiêu. Một báo cáo bán hàng cần bản ghi chính xác. Một mô hình cần khối lượng, đa dạng và cân bằng: hàng nghìn hoặc hàng triệu ví dụ bao phủ các tình huống thực tế mà nó sẽ đối mặt, mà không có một nguồn nào lấn át phần còn lại. Đó là lý do tại sao thu thập dữ liệu trong machine learning thường là một quá trình liên tục thay vì một lần xuất dữ liệu.
Nó có giống với training data không
Không hẳn. Training data là kết quả: các ví dụ đã được làm sạch, gắn nhãn mà mô hình học từ đó. Thu thập là công việc tìm kiếm, thu thập và chuẩn bị các ví dụ đó. Hầu hết các nhóm cũng giữ lại validation data và test data riêng biệt để kiểm tra mô hình trên các ví dụ mà nó chưa thấy.
AI thu thập dữ liệu như thế nào
AI không tự thu thập dữ liệu. Con người và các pipeline thu thập nó, sử dụng sáu phương pháp chính.
Phương pháp | Thu thập gì | Ví dụ điển hình |
Web scraping và crawling | Trang công khai, danh sách, đánh giá, bài viết | Dữ liệu giá cho mô hình dự báo |
API | Dữ liệu có cấu trúc mà nền tảng chọn chia sẻ | Bài đăng hoặc dữ liệu sản phẩm từ API chính thức |
Dữ liệu first-party | Nhấp chuột, tìm kiếm, mua hàng, chat hỗ trợ | Công cụ gợi ý của cửa hàng |
Cảm biến và thiết bị | Khung hình camera, GPS, số đo từ thiết bị đeo và máy móc | Mô hình tự lái và kiểm tra nhà máy |
Dataset có sẵn | Bộ sưu tập mở hoặc có giấy phép | Huấn luyện mô hình hình ảnh trên bộ hình ảnh công khai |
Dữ liệu tổng hợp | Các ví dụ được tạo bởi phần mềm hoặc các mô hình khác | Các trường hợp gian lận hiếm mà dữ liệu thực thiếu |
Hầu hết các mô hình production kết hợp nhiều phương pháp. Một chatbot hỗ trợ khách hàng có thể kết hợp nhật ký chat của chính công ty, bài viết trợ giúp công khai và các cuộc hội thoại tổng hợp bao gồm các câu hỏi hiếm gặp.
AI lấy dữ liệu từ đâu
Nguồn lớn nhất là web công khai. Common Crawl, một tổ chức phi lợi nhuận, đã duy trì kho lưu trữ dữ liệu thu thập web miễn phí và mở từ năm 2007, và các nhà nghiên cứu sử dụng rộng rãi trong nghiên cứu mô hình ngôn ngữ. Ngoài ra, các nhóm AI còn khai thác từ:
Nội dung được cấp phép: kho lưu trữ tin tức, sách, hình ảnh stock và code, được sử dụng theo thỏa thuận trả phí
Dataset mở: bộ sưu tập nghiên cứu được phát hành để sử dụng công khai
Tương tác người dùng: phản hồi, đánh giá và hội thoại, khi điều khoản bảo mật của sản phẩm cho phép
Dữ liệu do con người tạo: các chuyên gia và người gán nhãn viết, xếp hạng hoặc gán nhãn các ví dụ
Dữ liệu huấn luyện cho AI tạo sinh phụ thuộc nhiều vào văn bản, code và hình ảnh từ hai nguồn đầu tiên. Các mô hình nhỏ hơn dành riêng cho tác vụ cụ thể phụ thuộc nhiều hơn vào dữ liệu first-party của chính công ty.
Góc nhìn chuyên gia: Hầu hết các dự án dữ liệu không bị đình trệ ở code scraping. Chúng bị đình trệ ở các request bị chặn và phạm vi thu thập không đồng đều. Nếu crawler của bạn chỉ tiếp cận được 70% trang của một site và thất bại âm thầm ở phần còn lại, mô hình sẽ học một bức tranh lệch lạc mà không ai nhận ra.
AI thu thập những loại dữ liệu nào
Loại dữ liệu | Ví dụ | Ứng dụng |
Có cấu trúc | Giá cả, ngày tháng, giao dịch, số liệu cảm biến | Mô hình dự báo, định giá và phát hiện gian lận |
Không có cấu trúc | Văn bản tự do, hình ảnh, âm thanh, video | Mô hình ngôn ngữ, computer vision, nhận dạng giọng nói |
Bán cấu trúc | JSON, XML, chat log, trang web | Chatbot, xếp hạng tìm kiếm, hệ thống gợi ý |
Pipeline thu thập dữ liệu AI trông như thế nào
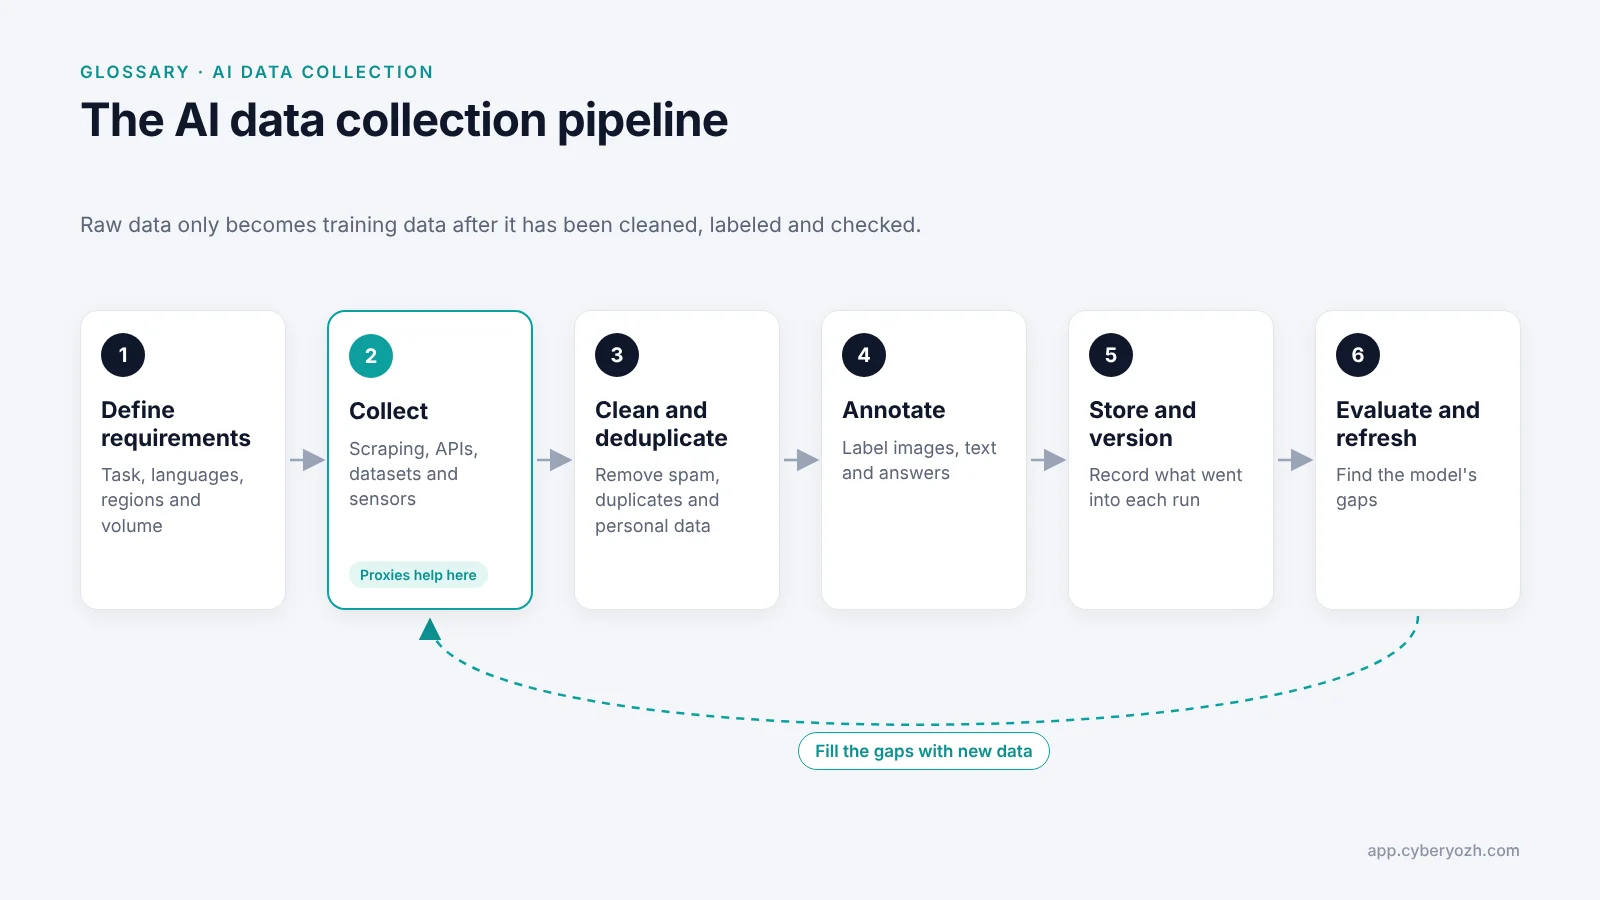
Xác định yêu cầu: mô hình phải làm gì, bao gồm ngôn ngữ hoặc khu vực nào và cần bao nhiêu dữ liệu
Thu thập: chạy scraper, kéo API và tải dataset
Làm sạch và loại bỏ trùng lặp: loại bỏ trang bị lỗi, spam, bản gần trùng và dữ liệu cá nhân không nên giữ lại
Gán nhãn: gán nhãn các ví dụ khi cần thiết, chẳng hạn như gắn thẻ hình ảnh hoặc đánh giá câu trả lời
Lưu trữ và quản lý phiên bản: giữ hồ sơ về những gì đã được đưa vào mỗi lần chạy huấn luyện
Đánh giá và làm mới: kiểm tra mô hình, tìm ra các khoảng trống và thu thập dữ liệu mới để lấp đầy chúng
Thu thập dữ liệu và gán nhãn thường bị nhầm lẫn. Thu thập dữ liệu là việc tập hợp nguyên liệu thô. Gán nhãn là việc thêm các nhãn cho mô hình biết mỗi ví dụ có nghĩa là gì.
Sai lầm phổ biến: Thu thập dữ liệu chỉ từ một vị trí. Giá cả, kết quả tìm kiếm và thậm chí cả nội dung trang đều thay đổi theo quốc gia. Một bộ dữ liệu được scrape hoàn toàn từ địa chỉ IP Hoa Kỳ sẽ dạy mô hình phiên bản web của Hoa Kỳ và coi đó là toàn bộ web.
Thu thập dữ liệu AI có hợp pháp không
Thường thì có, khi tuân thủ dữ liệu công khai và tôn trọng luật bảo mật. Ba ranh giới quan trọng nhất:
Công khai so với riêng tư. Trong vụ kiện kéo dài hiQ v. LinkedIn, tòa phúc thẩm Hoa Kỳ nhận định rằng việc scrape các trang có thể truy cập công khai có thể không vi phạm Đạo luật Gian lận và Lạm dụng Máy tính (tóm tắt vụ kiện của EFF). Điều khoản dịch vụ vẫn có thể tạo ra các khiếu nại hợp đồng, đó là lý do tranh chấp cuối cùng không có lợi cho hiQ.
Dữ liệu cá nhân. Tên, ảnh và thông tin liên hệ thuộc phạm vi các luật bảo mật như GDPR ở Châu Âu và CCPA ở California, ngay cả khi chúng hiển thị công khai.
Bản quyền. Một số vụ kiện về việc huấn luyện mô hình trên tác phẩm có bản quyền vẫn đang mở, do đó các nguồn được cấp phép hoặc có giấy phép mở mang ít rủi ro hơn.
Cảnh báo: Không thu thập dữ liệu từ sau đăng nhập hoặc vượt qua các biện pháp kiểm soát truy cập của trang web. Đó là nơi tập trung hầu hết rủi ro pháp lý. Trang này chỉ là thông tin chung, không phải tư vấn pháp lý, vì vậy hãy tham khảo luật sư trước khi thu thập dữ liệu cá nhân ở quy mô lớn.
Để có danh sách kiểm tra thực tế, hãy xem hướng dẫn của chúng tôi về web scraping có đạo đức.
Tại sao thu thập dữ liệu web cần proxy
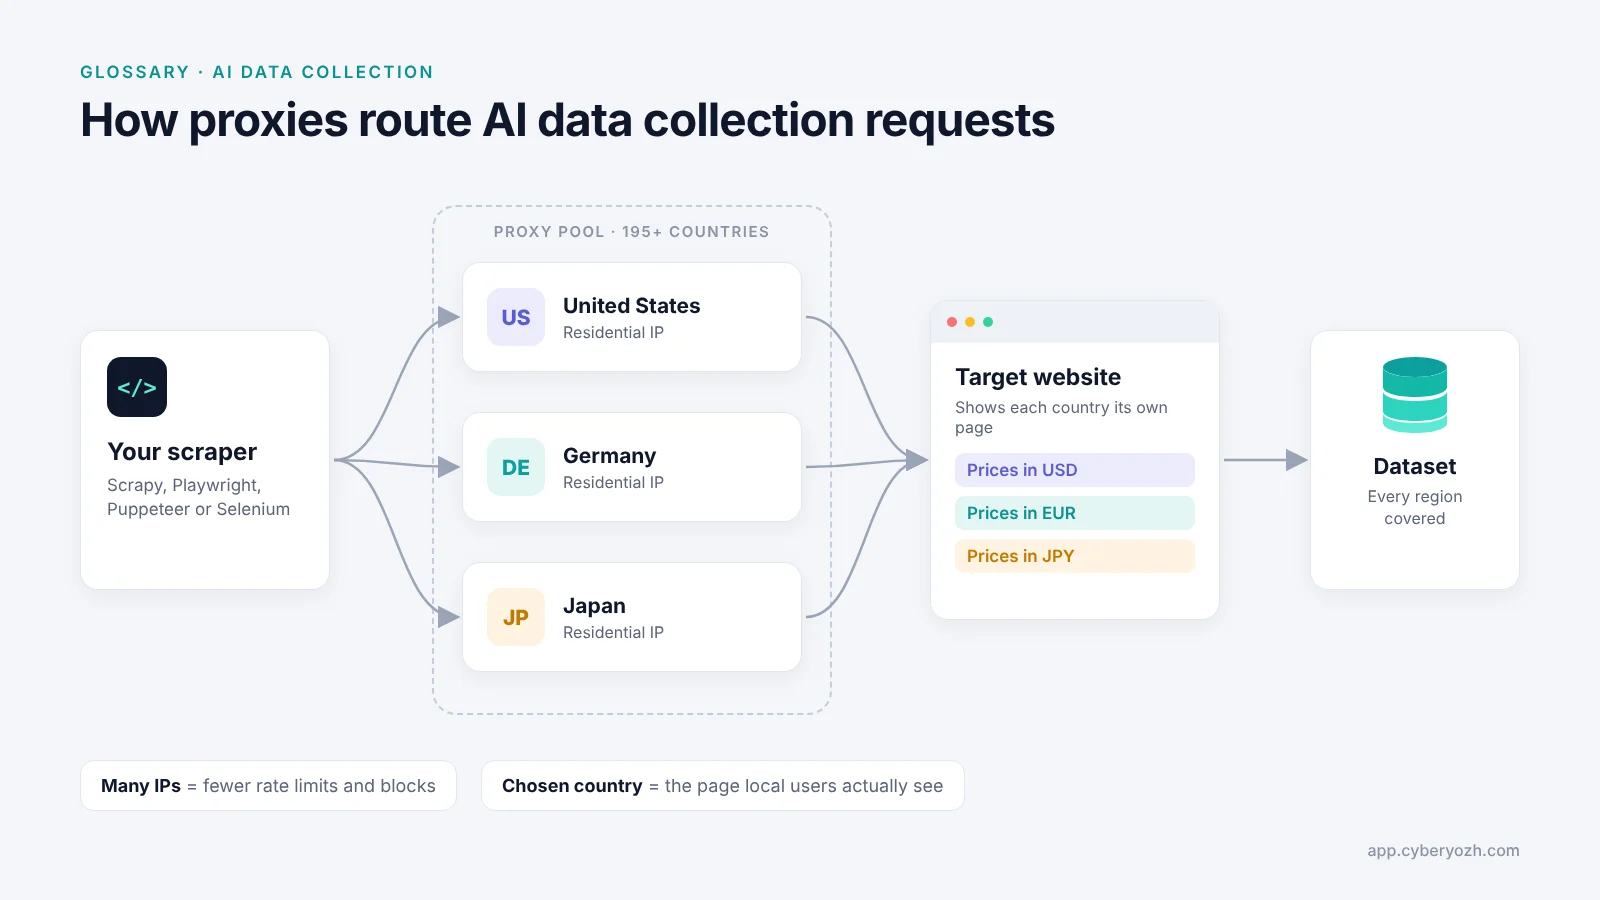
Chỉ một trong sáu phương pháp cần chúng: thu thập dữ liệu web công khai ở quy mô lớn. Nếu bạn gửi hàng nghìn yêu cầu từ một địa chỉ IP, các trang web sẽ giới hạn tốc độ hoặc chặn bạn trong vài phút. Bạn cũng chỉ thấy phiên bản của mỗi trang được hiển thị cho quốc gia của chính bạn.
Proxy phân tán các yêu cầu trên nhiều địa chỉ IP và cho phép bạn chọn quốc gia mà mỗi yêu cầu đến từ đó. Dưới đây là cách các loại proxy của CyberYozh phù hợp với các công việc thu thập dữ liệu AI phổ biến:
Công việc thu thập | Loại proxy tốt nhất | Giá từ |
Crawl quy mô lớn các trang công khai | $2/GB | |
Thu thập khối lượng lớn từ các trang web được bảo vệ nhẹ | Datacenter, băng thông không giới hạn | $1.77/tháng (dùng chung) |
Các phiên phải giữ một IP, chẳng hạn như kết quả phân trang | $5.29/tháng | |
Nội dung chỉ dành cho mobile và các trang web nghiêm ngặt nhất | Xem danh mục |
Hơn 100 triệu IP residential tại hơn 195 quốc gia cho các bộ dữ liệu cân bằng, đặc thù theo vị trí
Truy cập API đầy đủ với hỗ trợ cho Selenium, Playwright, Puppeteer và Scrapy
HTTP(S) và SOCKS5 trên mọi loại proxy
Được đánh giá 4.7+ Xuất sắc trên Trustpilot
Mẹo chuyên nghiệp: Chạy một mẫu IP của bạn qua công cụ miễn phí của CyberYozh IP Fraud Score checker trước khi crawl lớn. Thay thế các địa chỉ bị gắn cờ trước chỉ mất vài phút. Debug một crawl bị chặn một nửa sau đó mất hàng ngày.
Đang xây dựng pipeline? Xem proxy cho thu thập dữ liệu AIcủa chúng tôi, hoặc so sánh các nhà cung cấp trong bản tổng hợp của chúng tôi về dịch vụ thu thập dữ liệu.
Thu thập dữ liệu sạch hơn, cân bằng theo vị trí. Duyệt danh mục proxy CyberYozh →