Por qué necesitas un proxy para la recopilación de datos de IA
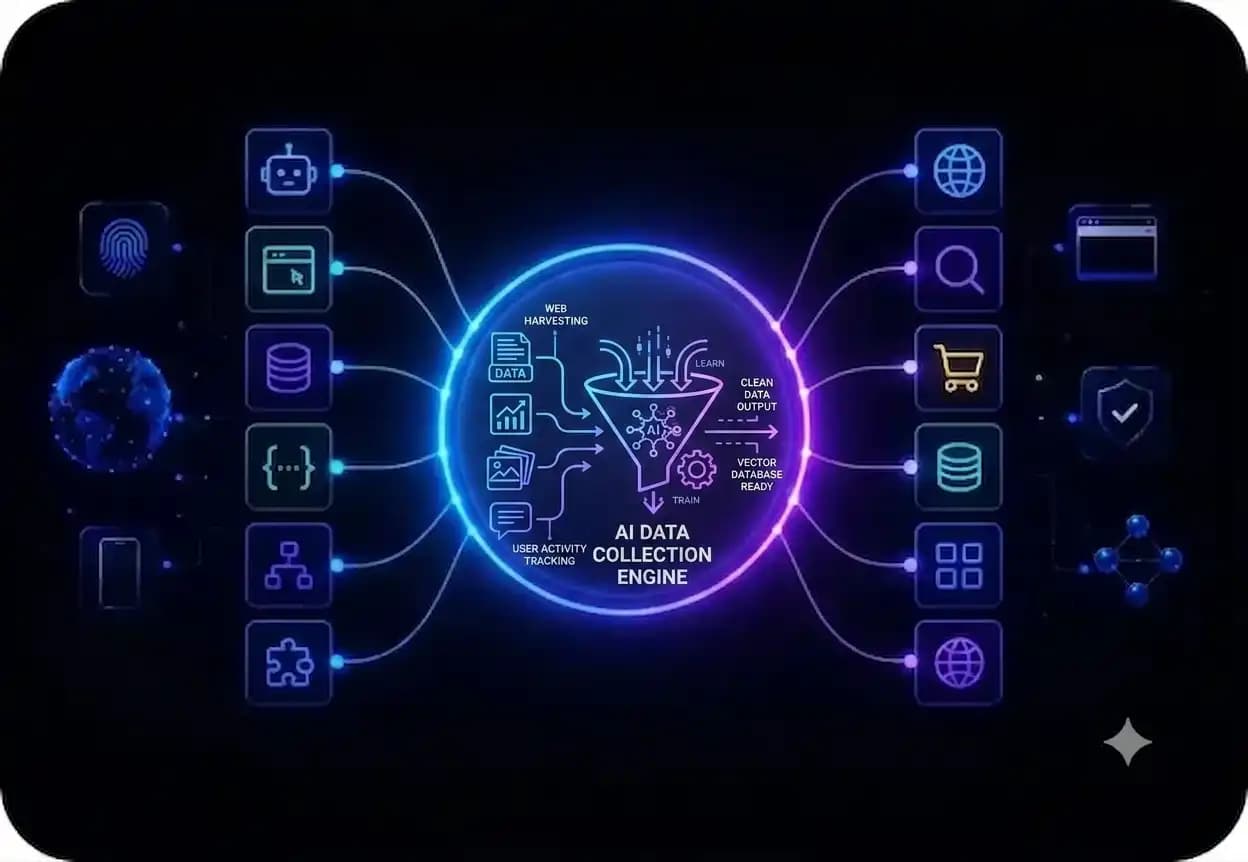
Los proxies son la infraestructura crítica que garantiza que tu IA reciba flujos de datos frescos, diversos e ininterrumpidos para tu tarea. Ya sea que estés desarrollando aplicaciones de IA, entrenando modelos de machine learning o monitoreando precios de la competencia y rankings de búsqueda, esto es lo que te ayuda a lograr.
Menos bloqueos de IP y límites de tasa: Los sitios web bloquean agresivamente las IPs que envían demasiadas solicitudes. Con IPs rotativas, puedes ejecutar scraping de alto volumen ininterrumpido sin activar defensas anti-bot.
Acceso a contenido localizado: Los proxies con geo-targeting te permiten recopilar resultados de búsqueda localizados, feeds sociales y precios regionales, dándole a tu modelo una verdadera perspectiva mundial.
Vence las medidas anti-bot: Los sitios modernos utilizan fingerprinting avanzado y CAPTCHAs. Los proxies premium parecen usuarios reales para las plataformas, asegurando que pases estas verificaciones y captures los datos que necesitas.
Estabilidad y escalabilidad: La recopilación de datos no puede permitirse tiempo de inactividad. Una red de proxies robusta con balanceo de carga mantiene tus pipelines funcionando incluso durante picos de demanda.
Protege tu infraestructura: Los servidores proxy actúan como un buffer, protegiendo tu IP de origen y sistemas internos de actores maliciosos y exposición legal.
Cómo los proxies resuelven problemas comunes de flujos de trabajo de recopilación de datos de IA
Diferentes flujos de trabajo de recopilación de datos de IA crean diferentes demandas de infraestructura, desde la recopilación de SERP localizada hasta datos de precios en tiempo real y agentes de IA basados en navegador.
Web scraping para entrenamiento de modelos de IA
Un equipo que hacía scraping de millones de páginas web para un corpus de entrenamiento de LLM alcanzó límites de tasa en horas con una sola IP. Los pipelines se estancaron con lotes incompletos, y los ingenieros perdieron días desbloqueando direcciones en lugar de construir modelos. Cambiaron a proxies de datacenter para datos de entrenamiento de IA, distribuyendo solicitudes a través de miles de IPs para mantenerse por debajo de los umbrales de detección.
⚡ Resultado: scraping continuo a máxima capacidad, objetivos diarios cumplidos y tiempo de ingeniería de vuelta al desarrollo de modelos.
➡️
Evita construir infraestructura de scraping desde cero
Yozh Scraper — gratuito, de código abierto, basado en Playwright — combina extracción automatizada con la red de proxies de CyberYozh, para que controles el tipo de proxy, GEO, rotación y sesiones en un solo flujo de trabajo.
→ Prueba Yozh Scraper para recopilación de datos de IA
Recopilación de datos SERP sin CAPTCHAs
Un equipo de analítica SEO que rastreaba rankings de palabras clave en docenas de países enfrentó CAPTCHAs instantáneos y resultados geo inconsistentes de Google y Bing. Esto llevó a datos de clientes poco confiables y malas decisiones. Se cambiaron a proxies residenciales rotativos para recopilación de datos SERP distribuyendo el volumen de consultas a través de un gran pool de IPs.
⚡ Resultado: datos SERP precisos y específicos por país a escala con interrupciones mínimas de CAPTCHA y rankings en los que los clientes podían confiar.
📕
Impulsado por API: la API de CyberYozh ofrece control programático directo sobre la rotación y la segmentación por país/región, integrándose directamente en stacks de scraping existentes como Scrapy, Playwright o Postman, sin necesidad de gestión manual de listas de proxies.
Monitoreo de precios con menos distorsiones
Un motor de precios dinámicos necesitaba monitorear precios de la competencia en tiempo real desde Amazon y Walmart, pero las plataformas detectaron la automatización en cuestión de minutos, mostrando precios distorsionados o bloqueando IPs. La IA tomaba decisiones basadas en datos obsoletos. Cambiaron a proxies residenciales rotativos, haciendo que las solicitudes parecieran de compradores locales reales.
⚡Resultado: precios competitivos precisos en tiempo real para la IA, permitiendo ajustes instantáneos de ofertas y promociones en lugar de reaccionar a los números de ayer.
Automatización de agentes sin bloqueos en medio de tareas
Un equipo que desplegaba agentes de IA basados en navegador para tareas de múltiples pasos (inicios de sesión, formularios, reservas de vuelos) seguía siendo bloqueado a mitad del proceso. Los sitios detectaban frameworks de automatización mediante fingerprinting y marcaban patrones de solicitudes cambiantes; la rotación básica de IP no era suficiente para completar un flujo de trabajo completo. Utilizaron un proxy móvil de alta confianza para agentes de IA con opciones de fingerprint de sistema operativo, otorgando a cada agente una identidad estable por tarea.
⚡Resultado: finalización confiable de múltiples pasos y una tasa de éxito que reemplazó los reintentos y fallos constantes.
Recuperación RAG sin respuestas obsoletas
Un equipo que ejecutaba un sistema RAG para investigación financiera seguía obteniendo respuestas antiguas o en caché en lugar de páginas en vivo. Trasladaron el tráfico de recuperación a proxies residenciales rotativos con sesiones sticky cortas, de modo que cada consulta obtuviera una vista fresca y sin caché de la página fuente.
⚡ Resultado: respuestas de recuperación que reflejan el contenido web actual en lugar de cachés, con menos bloqueos interrumpiendo el pipeline.
⭐ Leer más sobre la red de proxies RAG
Agregación de contenido a gran escala sin bloqueos sitio por sitio
Un equipo que construía un agregador de contenido impulsado por IA necesitaba extraer artículos, listados y especificaciones de productos de cientos de sitios. Un solo tipo de proxy funcionaba en algunos sitios y era bloqueado instantáneamente en otros, obligando a los ingenieros a mantener soluciones alternativas separadas. Cambiaron a una configuración mixta de proxies (datacenter para sitios permisivos, residenciales rotativos para los protegidos) enrutada a través de una sola API para que el scraper pudiera cambiar el tipo de proxy según el objetivo.
⚡ Resultado: un solo pipeline de scraping para todas las fuentes, con menos correcciones de mantenimiento por sitio y entrega de datos consistente.
⭐ Más información sobre proxies de web scraping para IA
Qué tipo de proxy elegir para tareas de recopilación de datos de IA
No todos los proxies son iguales. Cada tipo cumple un propósito específico en el pipeline de datos de IA:
Proxies residenciales para IA
Ideal para: Funciona como proxy de datos de entrenamiento de IA y también para investigación web, seguimiento de SERPy monitoreo de comercio electrónico. Los proxies residenciales para aprendizaje automático también son una opción popular.
Por qué: Las IPs reales asignadas por ISP con patrones de navegación orgánicos proporcionan puntuaciones de confianza más altas, haciéndolos efectivos contra sistemas anti-bot sofisticados como Cloudflare y DataDome.
Proxies móviles para flujos de trabajo de IA
Ideal para: Datos de aplicaciones móviles, scraping de plataformas sociales (Instagram, TikTok, X) y verificación de anuncios.
Por qué: Las IPs asignadas por operadores tienen la reputación de red más sólida. Las IPs móviles rara vez son incluidas en listas negras porque representan dispositivos de consumidores reales con celdas de red rotativas.
Proxies de datacenter para IA
Ideal para: Alta velocidad en recopilación de datos públicos, rastreo masivo para entrenamiento de LLM y agregación de precios.
Por qué: Los servidores ofrecen un rendimiento rápido al menor costo por solicitud. Ideal cuando el volumen importa más que evadir bloqueadores agresivos.
💡
Conclusión para operadores: Los proxies residenciales rotativos son la opción predeterminada para la mayoría de las tareas de recopilación de IA, no solo para evitar bloqueos, sino para inyectar diversidad geográfica y de comportamiento en tus datos de entrenamiento, mejorando la generalización del modelo. Sin embargo, si necesitas sesiones con inicio de sesión, opta por residenciales estáticos o móviles.
¿Es legal la recopilación de datos de IA con proxies?
Sí. Recopilar datos web públicamente disponibles para entrenamiento de IA, investigación de mercado o monitoreo de precios es una práctica estándar, y la infraestructura de CyberYozh está diseñada para respaldarlo de manera responsable.
Antes de recopilar:
Verifica los Términos de Servicio y las reglas de rastreo de la fuente
Identifica si hay datos personales involucrados
Recopila solo lo que tu caso de uso requiere
Lleva un registro de dónde y cuándo se recopilaron los datos.
Cómo construir un flujo de trabajo de recopilación de datos para IA
Define tus fuentes. Enumera los sitios, APIs o plataformas de los que necesitas datos, y anota cuáles están geográficamente restringidos, tienen límites de tasa o están protegidos contra bots.
Elige tu tipo de proxy. Datacenter para velocidad y volumen, residencial para sitios con detección anti-bot robusta, móvil para los objetivos de mayor confianza.
Selecciona tu GEO. Haz coincidir las ubicaciones de proxy con las regiones que sirven tus fuentes, hasta el nivel de ciudad donde los resultados localizados importan.
Configura la rotación y las sesiones. Rota por solicitud para scraping de alto volumen, o mantén una sesión persistente (hasta 24 horas) cuando una tarea necesite una identidad consistente.
Conéctate vía API. Integra el acceso proxy en Scrapy, Playwright, Puppeteer o Selenium con rotación programática y segmentación GEO, sin gestión manual de listas de proxies.
Recopila. Ejecuta el pipeline contra tus fuentes definidas usando la configuración de proxy establecida.
Alimenta el conjunto de datos. Dirige los datos validados hacia tu pipeline de entrenamiento de IA o aplicación.
Cómo la infraestructura de CyberYozh escala la recopilación de datos para IA
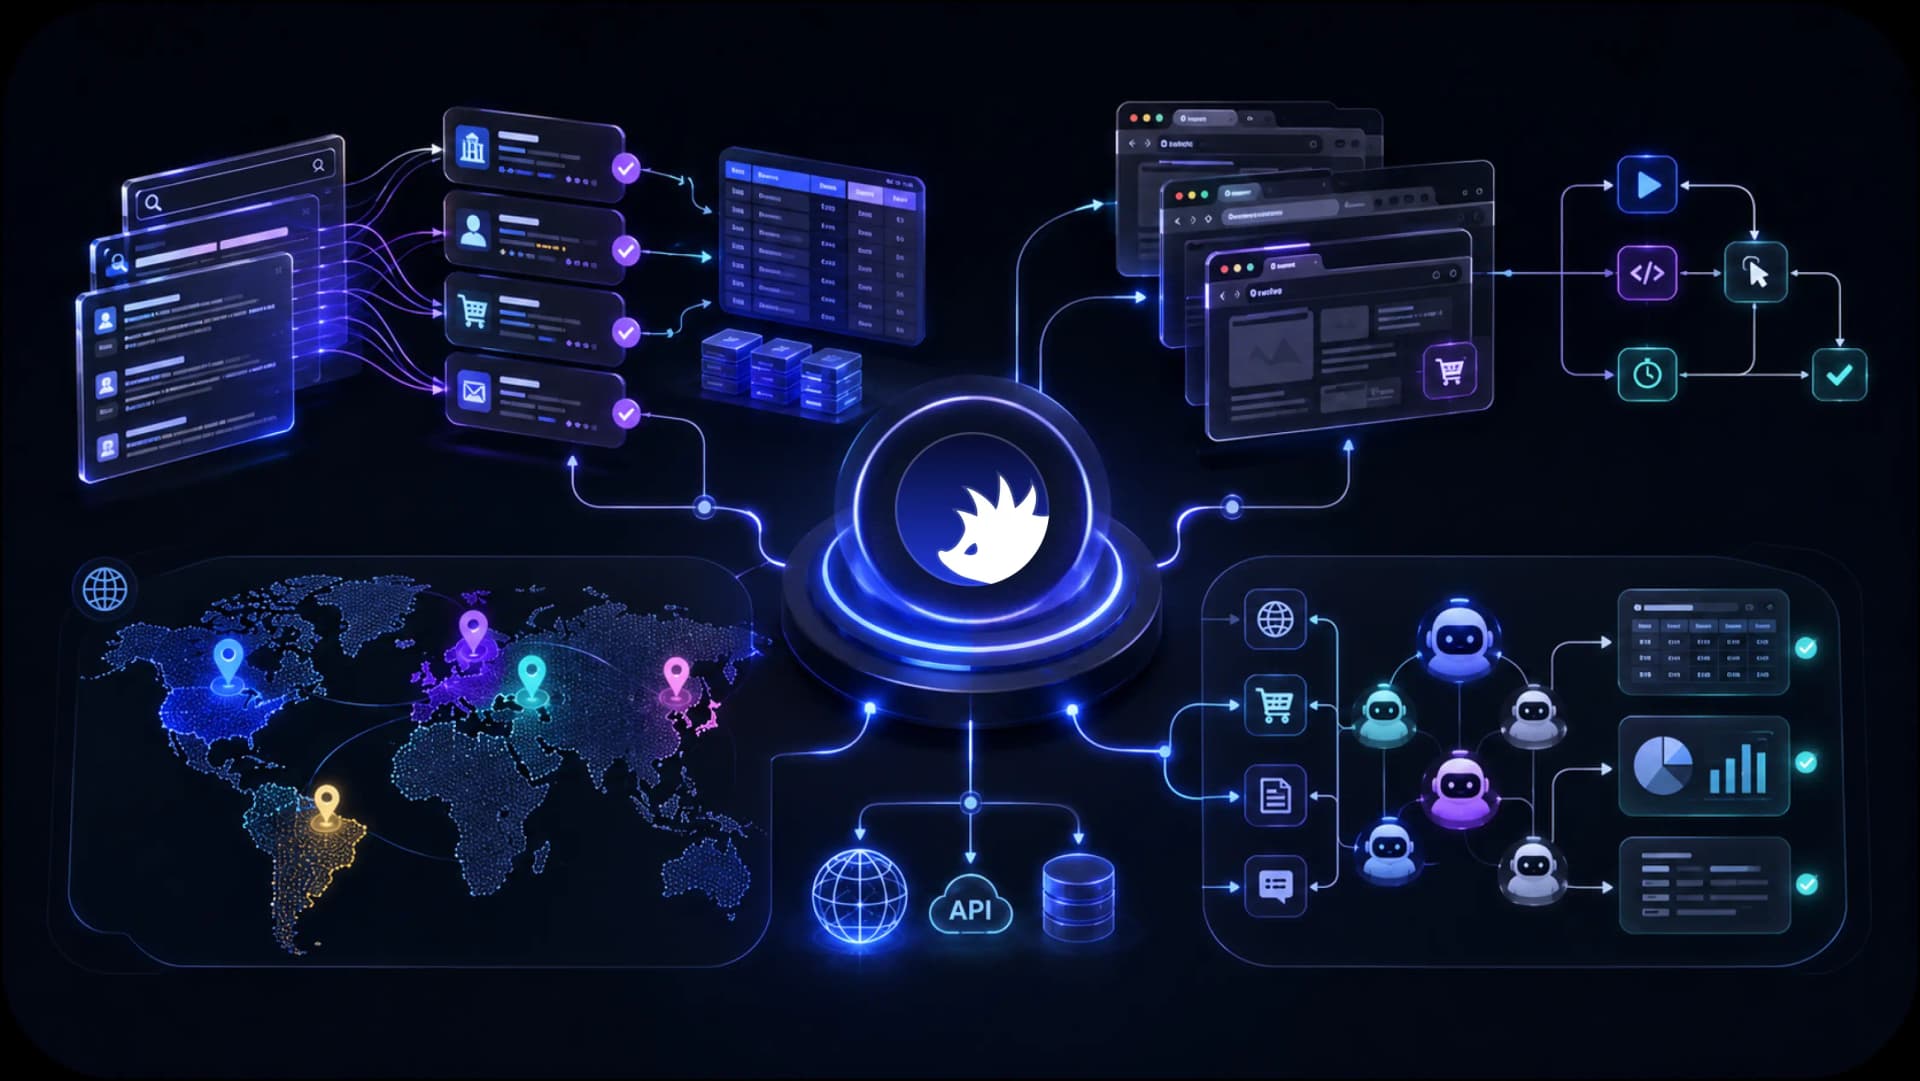
CyberYozh combina múltiples tipos de proxy, cobertura global y controles listos para automatización para que los equipos de IA puedan ajustar su infraestructura de recopilación al tamaño del conjunto de datos, geografía y requisitos del flujo de trabajo.
Proxies residenciales rotativos: Más de 100M de IPs residenciales en más de 195 países. Rotación flexible, sesiones persistentes de 24 horas y segmentación geográfica gratuita para la recopilación consistente de datos sin distorsión.
Proxies móviles LTE/5G reales (ancho de banda ilimitado): Recopila datos específicos de móviles o dependientes de ubicación a través de redes de operadores reales sin pagar de más por GB.
Soporte de API y automatización: Integra con pipelines de datos de IA, scripts personalizados y herramientas como Playwright, Puppeteer, Selenium, Postmany Scrapy.
Rotación flexible: elige entre rotación por solicitud y sesiones persistentes para adaptar el comportamiento de recopilación a diferentes conjuntos de datos y fuentes.
Plataforma todo en uno con proxies, verificación por SMS, tarjetas de pago virtuales y verificación de calidad de IP para un escalado cómodo.
Soporte al cliente receptivo 24/7 en 7 idiomas por correo electrónico y Telegram.