Obtén más de 100M de proxies residenciales, móviles LTE/5G y de datacenter limpios para la recopilación de datasets de IA, el entrenamiento de LLM y pipelines de RAG. Configura una segmentación precisa a nivel de ciudad y código postal en más de 195 países y obtén resultados exactos con una tasa de éxito del 99.9%. La rotación de IP controlada o las sticky sessions permiten recopilar datos de entrenamiento de IA con menos CAPTCHAs y límites de solicitudes.
Integra proxies en tu pipeline de datos de entrenamiento de IA
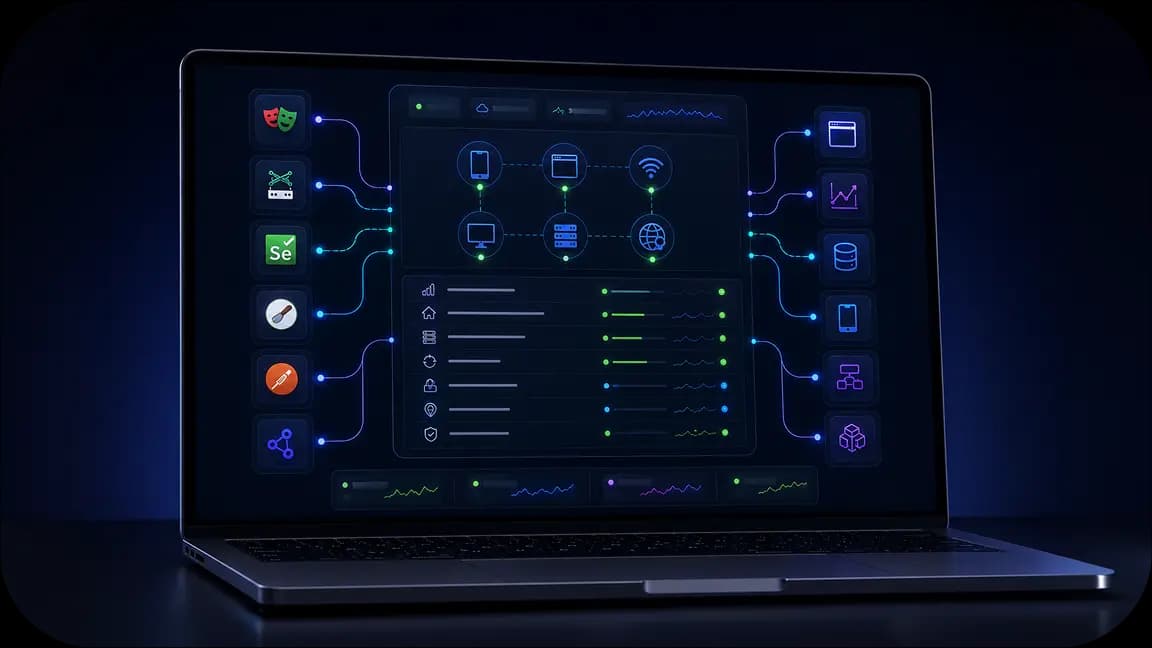
Conecta proxies directamente a tu stack de recopilación de datos para construir corpus de entrenamiento a gran escala. Integración API con Playwright, Puppeteer, Selenium, Scrapy y scripts de scraping personalizados.
Configuración sencilla de proxy para recopilación de datos de entrenamiento de IA
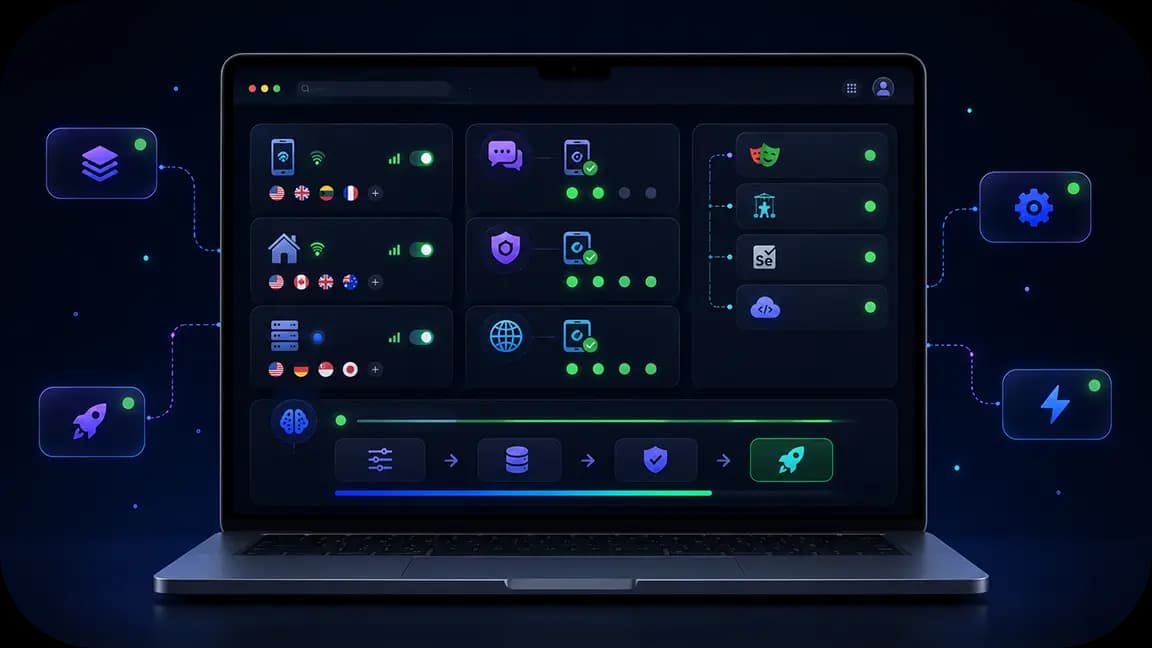
Configura un proxy para el web scraping de RAG o la recopilación de datasets de IA en unos pocos pasos. Controla la rotación de IP y las sticky sessions desde un panel de control apto para principiantes y genera credenciales en bloque a medida que crecen el tamaño de tu dataset y la diversidad de tus fuentes.
Recopila datos de entrenamiento de IA desde más de 195 países
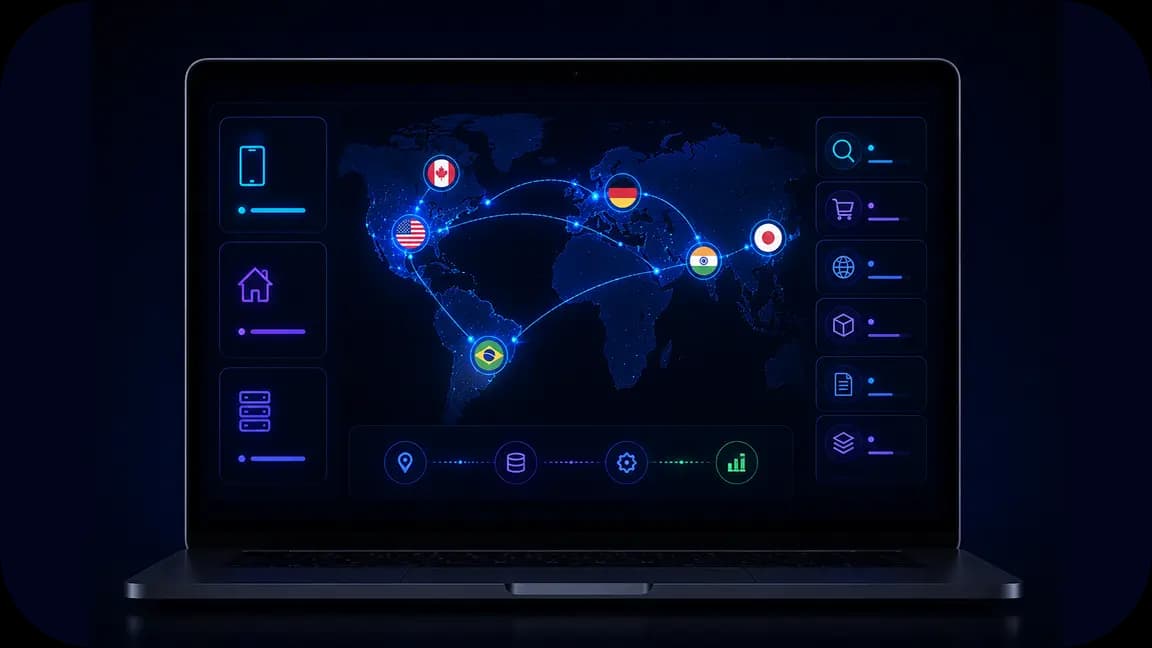
Realice web scraping para entrenar LLM y recopile datos multilingües en más de 195 países con proxies residenciales y segmentación detallada por ciudad y código postal. Cree conjuntos de entrenamiento precisos que reflejen la diversidad real del mundo.
Reduzca los bloqueos con soporte de fingerprinting
Los proxies de CyberYozh incluyen opciones de cambio de huella digital del sistema operativo para alinear el perfil de tu dispositivo con cada IP. Verifica tu IP para detectar su puntuación de fraude antes de ejecutar flujos de trabajo para reducir los CAPTCHAs y las solicitudes bloqueadas.
Funciones de CyberYozh para flujos de trabajo de entrenamiento de IA
Redes móviles reales LTE / 5G
Ejecuta agentes de IA a través de redes reales de operadores con tráfico móvil ilimitado y canales dedicados.
Redes reales de operadores LTE / 5G
Rotación de IP manual y por API
Entornos de alta confianza
Sesiones de IA estables
Resuelve los CAPTCHAs antes de la ejecución
Reduzca las interrupciones del flujo de trabajo con soporte para resolución de CAPTCHA y herramientas de validación diseñadas para la automatización.
Soporte para resolución de CAPTCHA
Validación previa a la ejecución
Controles de fraude
Control de calidad de la sesión
Una plataforma en lugar de múltiples herramientas
Administre proxies, activación de SMS, huellas digitales, verificaciones de fraude e integraciones desde un solo entorno.
Proxies + activación por SMS
Toma de huellas dactilares
Controles de fraude
Integraciones de API
Cómo CyberYozh impulsa la recopilación de datos para el entrenamiento de IA
CyberYozh App ofrece una infraestructura de proxies fiable para el scraping de datos a gran escala destinado al entrenamiento de IA. La plataforma combina más de 100M de IP residenciales, redes móviles LTE/5G reales y proxies de centros de datos con segmentación granular, sticky sessions, cambio de huella digital del sistema operativo, verificaciones antifraude de IP y números virtuales. Recopile un corpus de preentrenamiento, cree un conjunto de fine-tuning específico de un dominio o reúna datos de distintas regiones con menos CAPTCHAs e interrupciones en los procesos.
Cree flujos de trabajo de IA que recopilen, naveguen y se ejecuten a nivel global.
Accede a resultados de búsqueda localizados, mercados, datos públicos de la web y contenido regional en más de 195 países para agentes de IA, sistemas de scraping y flujos de trabajo autónomos.
Conjuntos de datos localizados para el entrenamiento y enriquecimiento de IA
Acceso multinacional para flujos de trabajo de scraping con IA
Infraestructura rentable para escalar la ejecución de IA
Ventajas competitivas de CyberYozh
CyberYozh combina la infraestructura que los equipos de IA necesitan para recopilar datos, automatizar flujos de trabajo, acceder a contenido regional y escalar entornos de ejecución. Desde proxies móviles LTE / 5G y residenciales hasta soporte para automatización de navegadores, fingerprinting, verificaciones antifraude y teléfonos Android en la nube, todo está diseñado para respaldar flujos de trabajo de IA desde una sola plataforma.
Rastreo web con IA
Automatización de navegador con IA
Recopilación de datos de IA
Ejecución de agente de IA
Flujos de trabajo de IA móvil
Acceso regional a la IA
Vea la infraestructura de IA de CyberYozh en acción
Vea cómo funciona CyberYozh en la práctica a través de flujos de trabajo reales, características de la plataforma y ejemplos de infraestructura. Explore el panel de control, las integraciones, los entornos de ejecución y las herramientas disponibles para equipos de IA y proyectos de automatización.
Por qué necesitas proxies para recopilar datos de entrenamiento de IA
Al construir un corpus de entrenamiento a gran escala, casi siempre te topas con el mismo muro: la fuente no quiere que la extraigan con tanta intensidad, tan rápido y desde una sola dirección.
Los sitios limitan o bloquean las IP que envían un gran volumen de solicitudes – la recopilación de datos se detiene mucho antes de alcanzar el tamaño objetivo y el equipo de ingeniería pierde tiempo en desbloquear accesos.
Cloudflare y DataDome detectan patrones de solicitudes no humanos y fingerprints de dispositivo, lo que te lleva a muros de CAPTCHA.
Recopilar desde una sola región – sin IP locales no puedes obtener de forma fiable fuentes, idiomas y perspectivas propios de otros mercados
Reddit, foros de nicho y otras fuentes de entrenamiento de alto valor exigen registro y verificación por teléfono para acceder al contenido completo, lo que añade una segunda barrera además del bloqueo por IP.
Los proxies de CyberYozh App resuelven las cuatro: distribuyen las solicitudes entre IP que parecen usuarios reales, en las ubicaciones adecuadas y con el volumen que requieren los corpus de entrenamiento.
✅
Abre el catálogo de proxiesde CyberYozh App para la recopilación de datos de IA
Tipos de datos que recopilan los equipos de IA (y el proxy adecuado para cada uno)
Redes sociales y foros
Reddit, Hacker News, Stack Exchange y las comunidades de nicho se cuentan entre las fuentes más ricas de datos conversacionales y de dominio específico, pero también son las más estrictas con los límites de solicitudes. Aquí los proxies móviles para datasets de IA funcionan mejor, ya que las IP reales de operadores móviles como Vodafone o T-Mobile superan los controles que detectan al instante el tráfico de datacenter.
Consejo: Los muros de inicio de sesión y los hilos con carga diferida suelen requerir Playwright o Puppeteer para renderizar y paginar el contenido antes de poder capturarlo.
Repositorios de código
GitHub, GitLab y los registros de paquetes son en su mayoría abiertos y compatibles con API, por lo que los proxies de datacenter funcionan bien aquí: rápidos, económicos y con la confianza suficiente para descargas de gran volumen.
Publicaciones, revistas científicas y archivos con licencia exigen un enfoque más delicado. Aquí ayudan los proxies residenciales o móviles, junto con un registro de qué se consultó y cómo, ya que estas fuentes son las que más escrutinio legal reciben en la recopilación de datos para entrenar IA.
E-commerce y reseñas
Los listados de productos y las reseñas de E-commerce se actualizan constantemente y se vigilan de cerca para detectar scraping. Los proxies residenciales rotativos mantienen el volumen alto sin provocar los precios distorsionados ni los bloqueos que delatan el tráfico automatizado.
Para construir un corpus que generalice entre idiomas y regiones hay que recopilar directamente de fuentes locales, no solo la versión que tu servidor llega a ver. Los proxies residenciales con geotargeting en más de 195 países obtienen contenido auténtico de cada región, en lugar de sesgarse hacia el lugar desde donde se origina el rastreo.
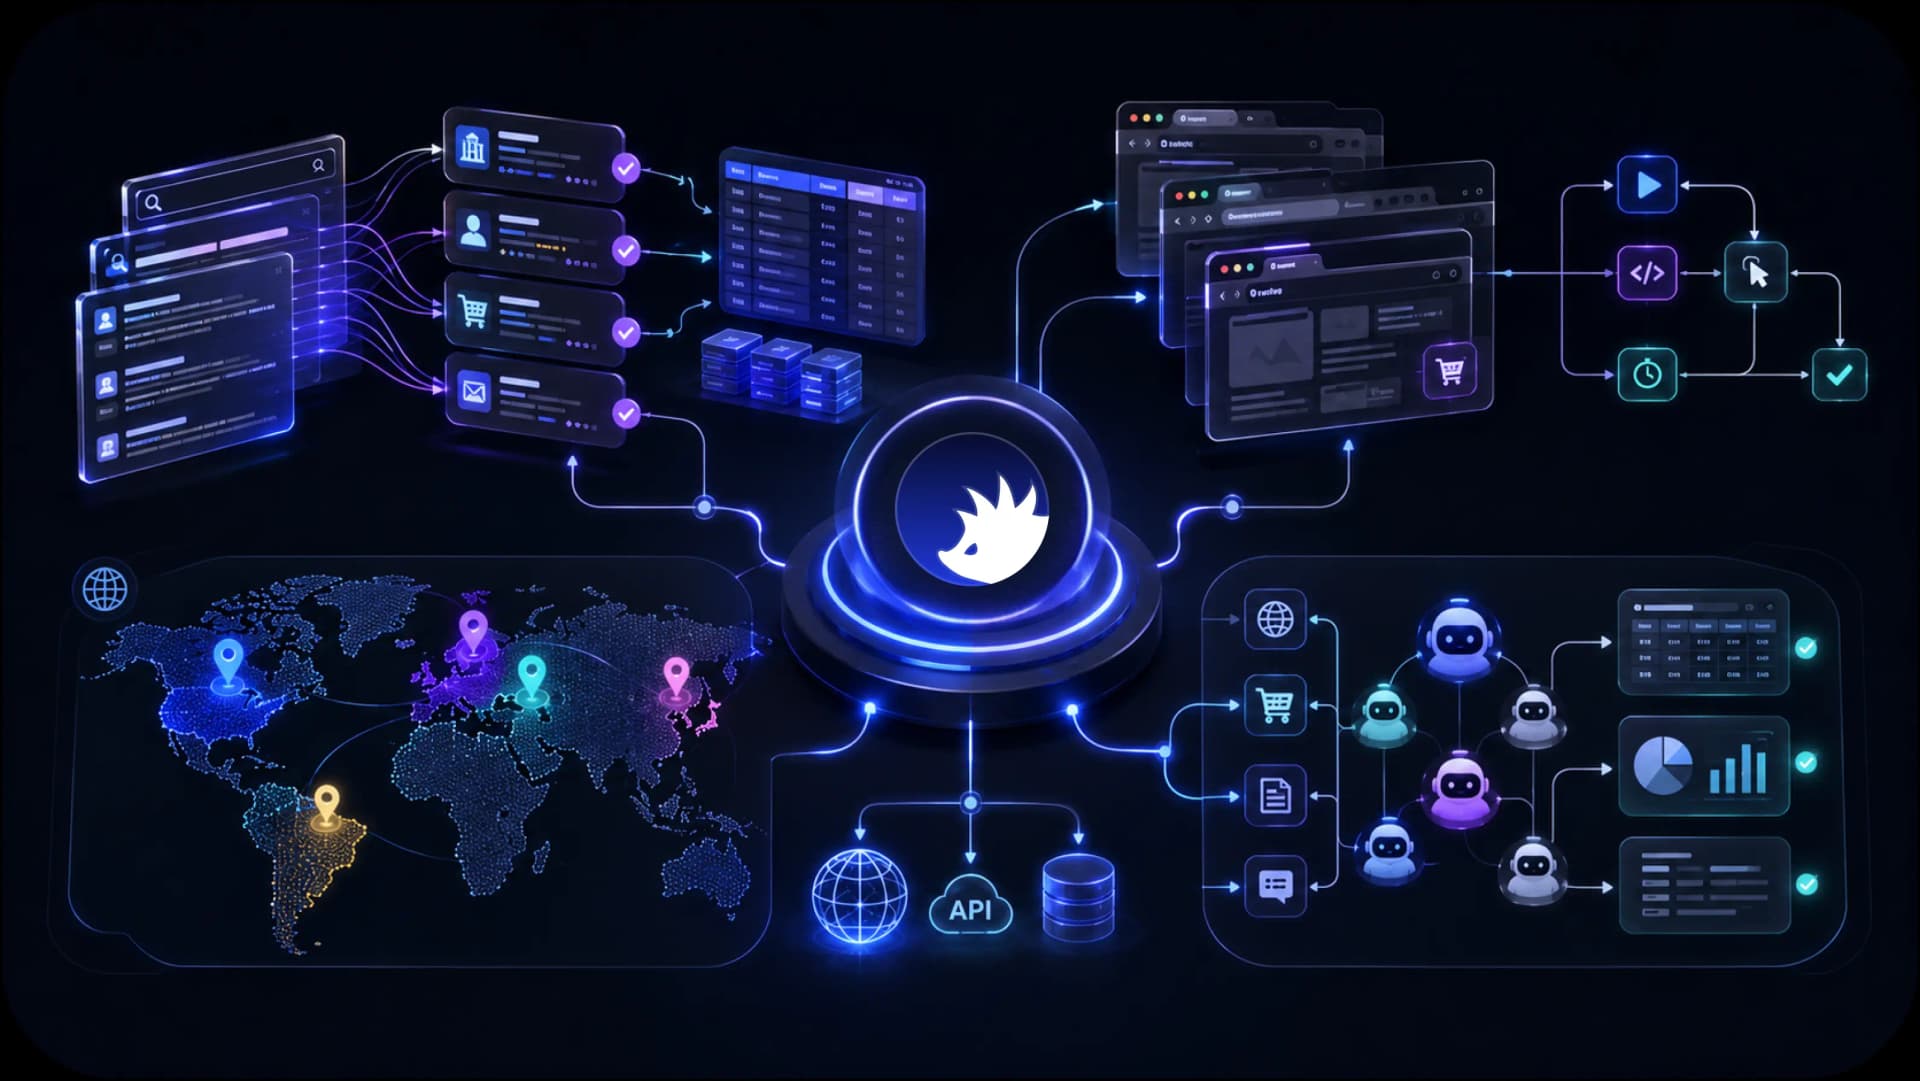
En lugar de construir una capa de scraping distinta para cada tipo de fuente, Yozh Scraper ejecuta tareas basadas en Playwright a través de proxies móviles, residenciales o de datacenter desde el primer momento. Una sola herramienta cubre la recopilación de datos de IA en redes sociales, tiendas online y fuentes de noticias.
💡 Conclusión para el operador: la mayoría de los corpus de entrenamiento combinan varias de estas categorías. Combinar tipos de proxy según la fuente, en lugar de usar un único tipo para todo, mantiene los costes bajos en los objetivos fáciles y la tasa de éxito alta en los difíciles.
Proxies residenciales, móviles y de datacenter para entrenar IA
Elige el proxy según la resistencia que oponga la fuente.
Proxies móviles: para los objetivos más difíciles y los muros de registro
Las IP de operadores móviles inspiran más confianza que las residenciales. Son la mejor opción para recopilar datos de entrenamiento de IA en plataformas orientadas al móvil: Instagram, TikTok, Reddit o cuentas de Facebook que exigen verificación por SMS antes de dar acceso completo.
Proxies residenciales: para fuentes protegidas y que exigen un usuario real
Las IP residenciales están vinculadas a proveedores de internet reales y las plataformas las ven como usuarios reales. Son más fiables para plataformas de redes sociales, foros, e-commerce y sitios de noticias, incluidos los hilos de Reddit y las reseñas de productos.
Proxies de datacenter: para la recopilación masiva de fuentes abiertas
Las IP de datacenter soportan descargas de gran volumen en las que no hace falta una identidad residencial. Son lo más adecuado para repositorios de código, datasets gubernamentales y archivos públicos, como GitHub, registros de paquetes y portales de datos abiertos.
Comparación de costes según el volumen diario de tráfico
En la recopilación de datos de IA a gran escala, el coste de los proxies se dispara rápidamente a medida que crece el volumen de scraping. Los proxies residenciales se cobran por el tráfico consumido, mientras que los proxies móviles dedicados de CyberYozh App ofrecen tráfico ilimitado por un precio diario fijo. Compara los costes con distintos volúmenes de recopilación.
Tráfico al día
Residencial ($2.5/GB, desde 100 GB)
Móvil dedicado ($3.5/día)
3 GB
$7.5
$3.50
10 GB
$25
$3.50
25 GB
$62.50
$3.50
50 GB
$125
$3.50
100 GB
$250
$3.50
Comparación de costes mensuales (30 días)
Móvil dedicado: $105/mes, independientemente del volumen de tráfico, sujeto a las condiciones de uso ilimitado del plan.
Residencial: $62.5/mes con 25 GB, $250 con 100 GB.
Con 500 GB/mes: el residencial cuesta $1,100/mes (plan business), frente a $105 del móvil dedicado.
Cumplimiento normativo y obtención ética en la recopilación de datos de IA
La recopilación de datos para entrenar IA está bajo un escrutinio legal cada vez mayor, y la responsabilidad alcanza cada vez más a toda la cadena, no solo a la empresa que entrena el modelo. Una obtención limpia y documentada marca la diferencia entre un proceso de recopilación defendible y uno que no resiste un cuestionamiento.
Unas cuantas prácticas reducen esa exposición y hacen que tu obtención de datos sea defendible si alguna vez se cuestiona:
Respeta robots.txt y los límites de solicitudes publicados en lugar de esquivarlos.
Conserva los registros de scraping – marcas de tiempo, URL de origen y métodos de acceso, para poder demostrar qué se recopiló y cómo.
Rastrea la procedencia de las IP y de los datos de extremo a extremo, en lugar de fiarte de lo que diga un intermediario sobre cómo se obtuvieron.
Separa la recopilación de datos de IA de la redistribución y documenta cualquier uso posterior, restricción de licencia o derecho de terceros sobre los datos antes de compartir datasets de entrenamiento.
Por qué elegir CyberYozh App para tus tareas con datos de entrenamiento de IA
CyberYozh App reúne en una sola plataforma todas las capas necesarias para recopilar datos de entrenamiento de IA: proxies, verificación y prevención del fraude. Así, los equipos no tienen que juntar proveedores distintos para cada parte del proceso.
Más de 100M de proxies residenciales con sesiones rotativas y sticky de hasta 24 h, filtrado de IP, geotargeting gratuito y rotación controlada por API
Proxies móviles 5G/LTE reales con tráfico ilimitado para recopilaciones de gran volumen, sin que los límites de datos frenen la construcción del corpus
Geotargeting a nivel de ciudad y código postal en más de 195 países para obtener datos regionales y multilingües auténticos
Cómo configurar proxies para la recopilación de datos de IA
Elige un tipo de proxy. Datacenter para repositorios abiertos y descargas masivas por API, residencial para fuentes con límite de solicitudes o restringidas por geografía, móvil LTE/5G para foros, plataformas sociales y muros de registro.
Configura la ubicación. Selecciona el targeting por país, ciudad o código postal para que cada fuente de datos se consulte desde su región correspondiente; de lo contrario, tu corpus heredará un sesgo geográfico.
Obtén las credenciales. Copia el endpoint, el nombre de usuario y la contraseña desde la panel de control, o genera una clave de API para usarla en pipelines programáticos.
Conecta. Añade las credenciales a Playwright, Puppeteer, Selenium, Scrapy o a tu propio script, o ejecuta Yozh Scraper para ahorrarte la configuración. Define la rotación o las sesiones sticky por solicitud o por sesión en la misma configuración.
Prueba la conexión. Comprueba la IP de salida y su puntuación de fraude, y luego lanza una solicitud de prueba para confirmar que la rotación, la duración de las sesiones sticky y el geotargeting se comportan como se espera antes de escalar la construcción del corpus.