Mengapa Anda memerlukan proxy untuk pengumpulan data AI
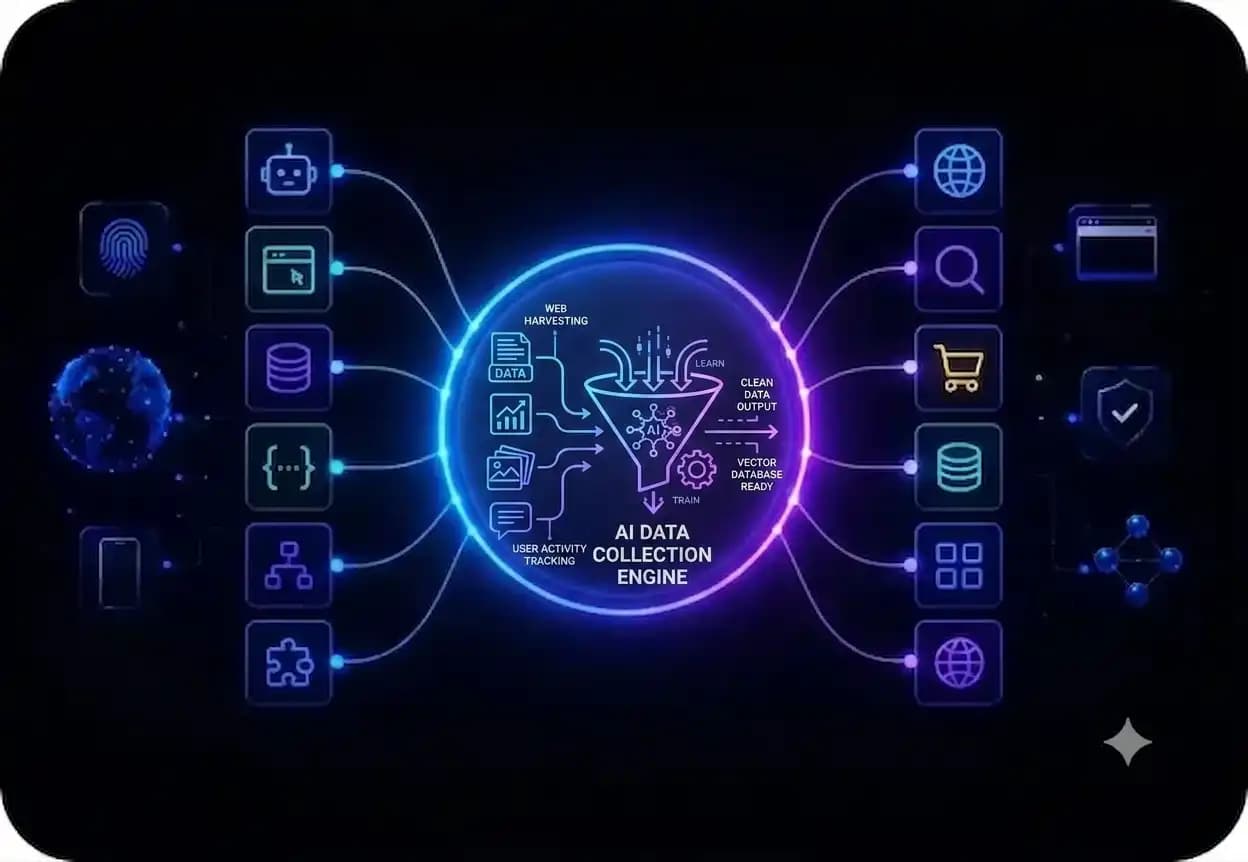
Proxy adalah infrastruktur kritis yang memastikan AI Anda menerima aliran data yang segar, beragam, dan tanpa gangguan untuk tugas Anda. Baik Anda sedang mengembangkan aplikasi AI, melatih model machine learning, atau memantau harga kompetitor dan peringkat pencarian, inilah yang dapat dicapai.
Lebih sedikit pemblokiran IP dan rate limit: Website secara agresif memblokir IP yang mengirim terlalu banyak permintaan. Dengan rotating IP, Anda dapat menjalankan scraping volume tinggi tanpa gangguan tanpa memicu pertahanan anti-bot.
Akses konten lokal: Proxy dengan geo-targeting memungkinkan Anda mengumpulkan hasil pencarian lokal, social feed, dan harga regional, memberikan model Anda perspektif global yang sesungguhnya.
Kalahkan langkah anti-bot: Situs modern menggunakan fingerprinting canggih dan CAPTCHA. Proxy premium terlihat seperti pengguna asli bagi platform, memastikan Anda lolos pemeriksaan ini dan menangkap data yang Anda butuhkan.
Stabilitas dan skala: Pengumpulan data tidak boleh mengalami downtime. Jaringan proxy yang kuat dengan load balancing menjaga pipeline Anda tetap berjalan bahkan selama permintaan puncak.
Lindungi infrastruktur Anda: Server proxy bertindak sebagai buffer, melindungi IP asal dan sistem internal Anda dari aktor jahat dan paparan hukum.
Bagaimana proxy mengatasi masalah workflow pengumpulan data AI yang umum
Workflow pengumpulan data AI yang berbeda menciptakan tuntutan infrastruktur yang berbeda, dari pengumpulan SERP lokal hingga data harga real-time dan AI agent berbasis browser.
Web scraping untuk pelatihan model AI
Sebuah tim yang melakukan scraping jutaan halaman web untuk korpus pelatihan LLM mencapai rate limit dalam hitungan jam pada satu IP. Pipeline terhenti dengan batch yang tidak lengkap, dan engineer menghabiskan waktu berhari-hari membuka blokir alamat alih-alih membangun model. Mereka beralih ke datacenter proxy data pelatihan AI, menyebarkan permintaan ke ribuan IP untuk tetap di bawah ambang deteksi.
⚡ Hasil: scraping throughput penuh yang berkelanjutan, target harian terpenuhi, dan waktu engineering kembali pada pengembangan model.
➡️
Lewati pembangunan infrastruktur scraping dari awal
Yozh Scraper — gratis, open-source, berbasis Playwright — menggabungkan ekstraksi otomatis dengan jaringan proxy CyberYozh, sehingga Anda mengontrol jenis proxy, GEO, rotasi, dan sesi dalam satu workflow.
→ Coba Yozh Scraper untuk pengumpulan data AI
Pengumpulan data SERP tanpa CAPTCHA
Sebuah tim analitik SEO yang melacak peringkat keyword di puluhan negara menghadapi CAPTCHA instan dan hasil geo yang tidak konsisten dari Google dan Bing. Ini menyebabkan data klien yang tidak dapat diandalkan dan keputusan yang buruk. Mereka beralih ke rotating residential proxy untuk pengumpulan data SERP yang mendistribusikan volume query ke pool IP yang besar.
⚡ Hasil: data SERP spesifik negara yang akurat dalam skala besar dengan gangguan CAPTCHA minimal dan peringkat yang dapat dipercaya klien.
📕
Didukung oleh API: API CyberYozh memberikan kontrol programatik langsung atas rotasi dan penargetan negara/wilayah, terintegrasi langsung ke dalam stack scraping yang ada seperti Scrapy, Playwright, atau Postman — tanpa perlu manajemen daftar proxy secara manual.
Pemantauan harga dengan lebih sedikit distorsi
Sebuah mesin penetapan harga dinamis perlu memantau harga kompetitor secara langsung dari Amazon dan Walmart, tetapi platform mendeteksi otomasi dalam hitungan menit, menampilkan harga yang terdistorsi atau memblokir IP. AI membuat keputusan berdasarkan data yang sudah usang. Mereka beralih ke proxy residential rotating, membuat permintaan terlihat seperti pembeli lokal yang nyata.
⚡Hasil: penetapan harga kompetitif yang real-time dan akurat untuk AI, memungkinkan penyesuaian bid dan promosi secara instan alih-alih bereaksi terhadap angka kemarin.
Otomasi agen tanpa pemblokiran di tengah tugas
Sebuah tim yang menerapkan agen AI berbasis browser untuk tugas multi-langkah (login, formulir, pemesanan penerbangan) terus diblokir di tengah proses. Situs melakukan fingerprinting terhadap framework otomasi dan menandai pola permintaan yang berubah; rotasi IP dasar tidak cukup untuk menyelesaikan workflow penuh. Mereka menggunakan proxy mobile untuk agen AI dengan tingkat kepercayaan tinggi dan opsi fingerprint OS, memberikan setiap agen satu identitas stabil per tugas.
⚡Hasil: penyelesaian multi-langkah yang andal dan tingkat keberhasilan yang menggantikan percobaan ulang dan kegagalan yang konstan.
Pengambilan RAG tanpa jawaban yang usang
Sebuah tim yang menjalankan sistem RAG untuk riset keuangan terus memunculkan jawaban lama atau yang di-cache alih-alih halaman langsung. Mereka memindahkan lalu lintas pengambilan ke proxy residential rotating dengan sesi sticky pendek, sehingga setiap kueri menarik tampilan sumber halaman yang segar dan tidak di-cache.
⚡ Hasil: respons pengambilan yang mencerminkan konten web saat ini alih-alih cache, dengan lebih sedikit pemblokiran yang mengganggu pipeline.
⭐ Baca lebih lanjut tentang jaringan proxy RAG
Agregasi konten skala besar tanpa pemblokiran per situs
Sebuah tim yang membangun agregator konten bertenaga AI perlu menarik artikel, listing, dan spesifikasi produk dari ratusan situs. Satu jenis proxy berhasil di beberapa situs dan langsung diblokir di situs lain, memaksa engineer untuk memelihara solusi terpisah. Mereka beralih ke pengaturan proxy campuran (datacenter untuk situs yang permisif, residential rotating untuk yang terlindungi) yang dirutekan melalui satu API sehingga scraper dapat beralih jenis proxy per target.
⚡ Hasil: satu pipeline scraping untuk semua sumber, dengan lebih sedikit perbaikan pemeliharaan per-situs dan pengiriman data yang konsisten.
⭐ Pelajari lebih lanjut tentang proxy web scraping AI
Jenis proxy apa yang harus dipilih untuk tugas pengumpulan data AI
Tidak semua proxy dibuat sama. Setiap jenis memiliki tujuan yang berbeda dalam pipeline data AI:
Proxy residential untuk AI
Terbaik untuk: Berfungsi sebagai proxy data pelatihan AI dan juga untuk riset web, pelacakan SERP, dan pemantauan e-commerce. Proxy residential untuk machine learning juga merupakan pilihan populer.
Mengapa: IP yang ditetapkan ISP asli dengan pola browsing organik memberikan skor kepercayaan yang lebih tinggi, membuatnya efektif melawan sistem anti-bot canggih seperti Cloudflare dan DataDome.
Proxy mobile untuk alur kerja AI
Terbaik untuk: Data aplikasi mobile, scraping platform sosial (Instagram, TikTok, X), dan verifikasi iklan.
Mengapa: IP yang ditetapkan operator seluler memiliki reputasi jaringan terkuat. IP mobile jarang masuk daftar hitam karena mewakili perangkat konsumen aktual dengan sel jaringan yang berputar.
Proxy datacenter untuk AI
Terbaik untuk: Kecepatan tinggi pengumpulan data publik, crawling massal untuk pelatihan LLM, dan agregasi harga.
Mengapa: Server memberikan throughput cepat dengan biaya terendah per permintaan. Ideal ketika volume lebih penting daripada menghindari pemblokir yang agresif.
💡
Kesimpulan operator: Proxy residential yang berputar adalah default untuk sebagian besar tugas pengumpulan AI — bukan hanya untuk menghindari pemblokiran, tetapi untuk menyuntikkan keragaman geografis dan perilaku ke dalam data pelatihan Anda, meningkatkan generalisasi model. Namun, jika Anda memerlukan sesi yang sudah login, gunakan residential statis atau mobile.
Apakah pengumpulan data AI dengan proxy legal
Ya. Mengumpulkan data web yang tersedia untuk umum untuk pelatihan AI, riset pasar, atau pemantauan harga adalah praktik standar, dan infrastruktur CyberYozh dibangun untuk mendukungnya secara bertanggung jawab.
Sebelum mengumpulkan:
Periksa Ketentuan Layanan sumber dan aturan crawling
Identifikasi apakah data pribadi terlibat
Kumpulkan hanya apa yang diperlukan kasus penggunaan Anda
Lacak di mana dan kapan data dikumpulkan.
Cara membangun alur kerja pengumpulan data AI
Tentukan sumber Anda. Buat daftar situs, API, atau platform yang Anda perlukan datanya, dan catat mana yang dibatasi secara geografis, dibatasi laju permintaan, atau dilindungi anti-bot.
Pilih jenis proxy Anda. Datacenter untuk kecepatan dan volume, residential untuk situs dengan deteksi anti-bot yang kuat, mobile untuk target dengan tingkat kepercayaan tertinggi.
Pilih GEO Anda. Sesuaikan lokasi proxy dengan wilayah yang dilayani sumber Anda, hingga tingkat kota di mana hasil lokal penting.
Konfigurasi rotasi dan sesi. Rotasi per permintaan untuk scraping volume tinggi, atau pertahankan sticky session (hingga 24 jam) ketika tugas memerlukan satu identitas yang konsisten.
Hubungkan melalui API. Integrasikan akses proxy ke Scrapy, Playwright, Puppeteer, atau Selenium dengan rotasi terprogram dan penargetan GEO, tanpa manajemen daftar proxy manual.
Kumpulkan. Jalankan pipeline terhadap sumber yang telah Anda tentukan menggunakan pengaturan proxy yang dikonfigurasi.
Masukkan dataset. Arahkan data yang telah divalidasi ke pipeline pelatihan AI atau aplikasi Anda.
Bagaimana infrastruktur CyberYozh menskalakan pengumpulan data AI
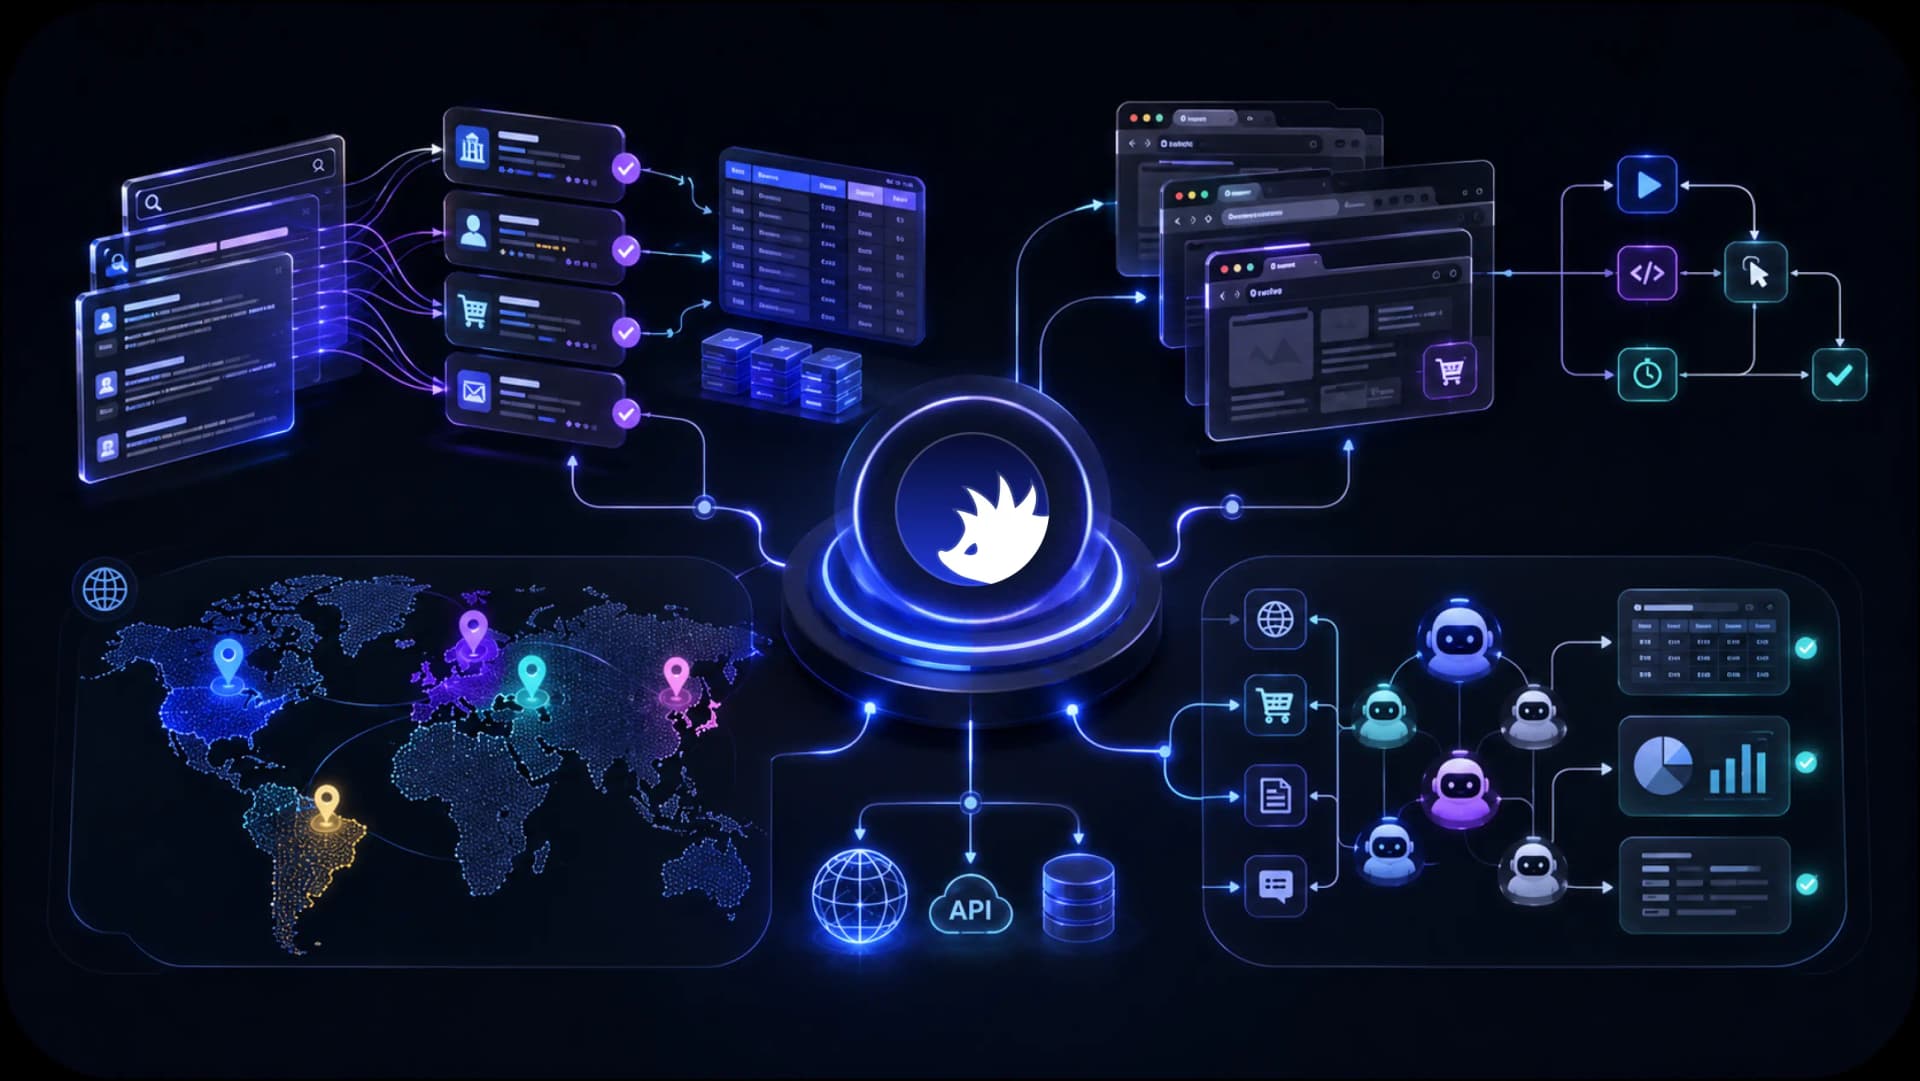
CyberYozh menggabungkan berbagai jenis proxy, cakupan global, dan kontrol siap-otomasi sehingga tim AI dapat menyesuaikan infrastruktur pengumpulan mereka dengan ukuran dataset, geografi, dan kebutuhan alur kerja.
Residential rotating proxies: 100 juta+ IP residential di 195+ negara. Rotasi fleksibel, sticky session 24 jam, dan geo-targeting gratis untuk pengumpulan data yang konsisten tanpa distorsi.
Proxy mobile LTE/5G asli (bandwidth unlimited): Kumpulkan data khusus mobile atau bergantung lokasi melalui jaringan operator asli tanpa membayar berlebihan per GB.
Dukungan API dan otomasi: Integrasikan dengan pipeline data AI, skrip kustom, dan alat seperti Playwright, Puppeteer, Selenium, Postman, dan Scrapy.
Rotasi fleksibel: pilih antara rotasi per-permintaan dan sticky session untuk menyesuaikan perilaku pengumpulan dengan dataset dan sumber yang berbeda.
Platform all-in-one dengan proxy, verifikasi SMS, kartu pembayaran virtual, dan pengecekan kualitas IP untuk skalabilitas yang nyaman.
Dukungan klien responsif 24/7 dalam 7 bahasa melalui e-mail dan Telegram.