Redes móveis LTE / 5G reais
Execute agentes de IA em redes reais de operadoras com tráfego móvel ilimitado e canais dedicados.
- Redes reais de operadoras LTE / 5G
- Rotação de IP manual e via API
- Ambientes de alta confiança
- Sessões de IA estáveis
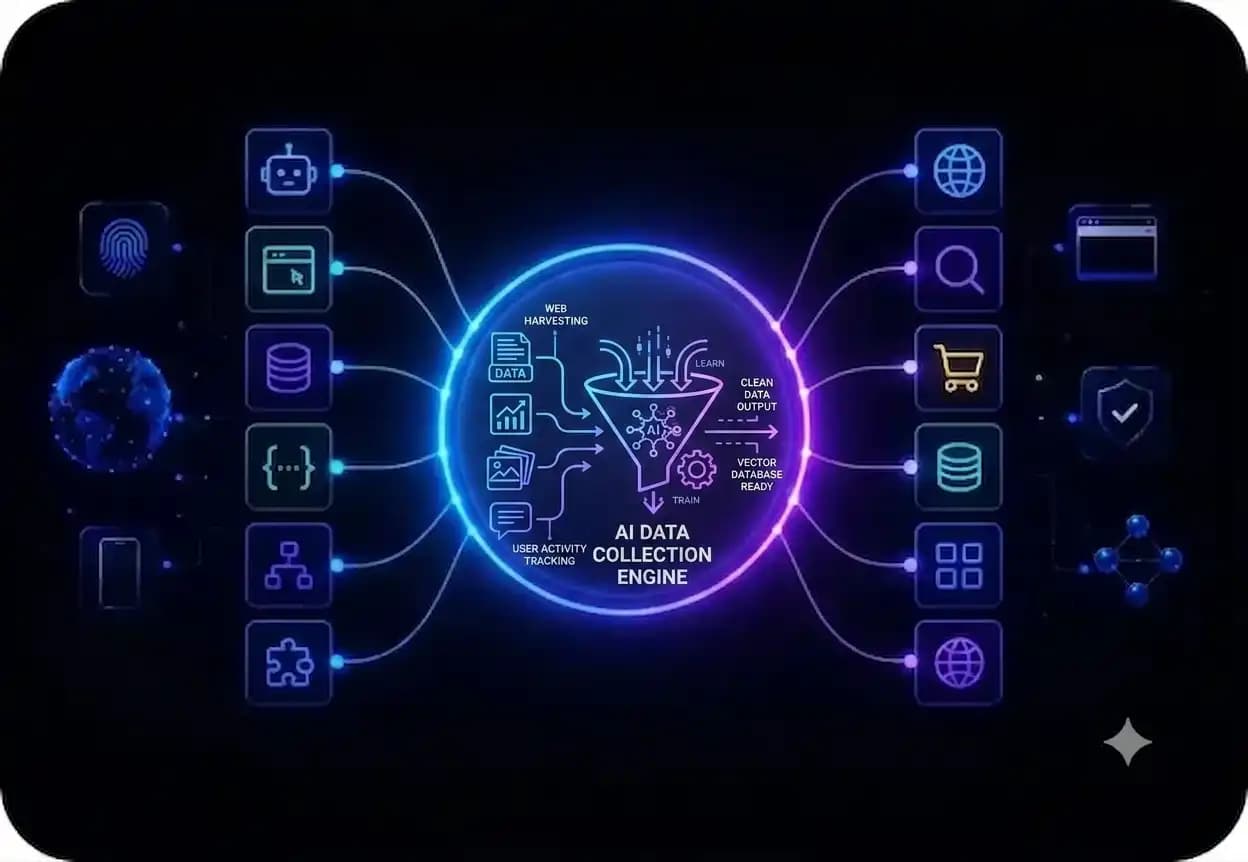
Potencialize treinamento de IA, pipelines RAG e pesquisa de mercado com mais de 100 milhões de IPs residenciais, móveis LTE/5G e de datacenter em mais de 195 países. Segmentação em nível de cidade, rotação flexível e sessões sticky de 24 horas para menos limites de taxa e solicitações bloqueadas — para que seus pipelines entreguem dados utilizáveis sem supervisão constante.

Conecte proxies ao seu stack de coleta de dados de IA por meio de acesso à API para manter os pipelines de dados em execução. Compatível com Playwright, Puppeteer, Selenium, Scrapy e scripts personalizados.

Configure um proxy e comece a coletar dados da web sem gerenciar infraestrutura complexa. Ajuste o comportamento da coleta de dados com rotação de IP flexível e sessões persistentes à medida que seus conjuntos de dados e cargas de trabalho crescem.

Proxies com segmentação granular em nível de cidade e código postal permitem coletar dados localizados sem distorções. Obtenha dados web precisos para treinamento de IA, pesquisa de mercado e monitoramento de preços.

Mantenha a coleta de dados estável com opções de impressão digital do sistema operacional juntamente com a infraestrutura de proxy para manter sinais de dispositivo consistentes. Mantenha os parâmetros de rede alinhados com as configurações de impressão digital e verifique a qualidade do IP antes de executar a coleta de dados em grande escala.
Execute agentes de IA em redes reais de operadoras com tráfego móvel ilimitado e canais dedicados.

Reduza as interrupções no fluxo de trabalho com suporte à resolução de CAPTCHA e ferramentas de validação desenvolvidas para automação.

Gerencie proxies, ativação de SMS, impressão digital, verificações de fraude e integrações a partir de um único ambiente.
A infraestrutura de proxies da CyberYozh permite a coleta de dados em larga escala para treinamento de IA, pesquisa de mercado e fluxos de trabalho de aprendizado de máquina. A rede combina mais de 100 milhões de IPs residenciais, proxies móveis LTE/5G e proxies de datacenters com segmentação precisa, rotação flexível, sessões persistentes de até 24 horas e ferramentas de verificação de IP. Com qualidade de IP monitorada, opções de fingerprinting e números virtuais, a CyberYozh fornece uma infraestrutura confiável para coletar dados sem distorções, reduzir interrupções e escalar pipelines de IA em mercados globais.
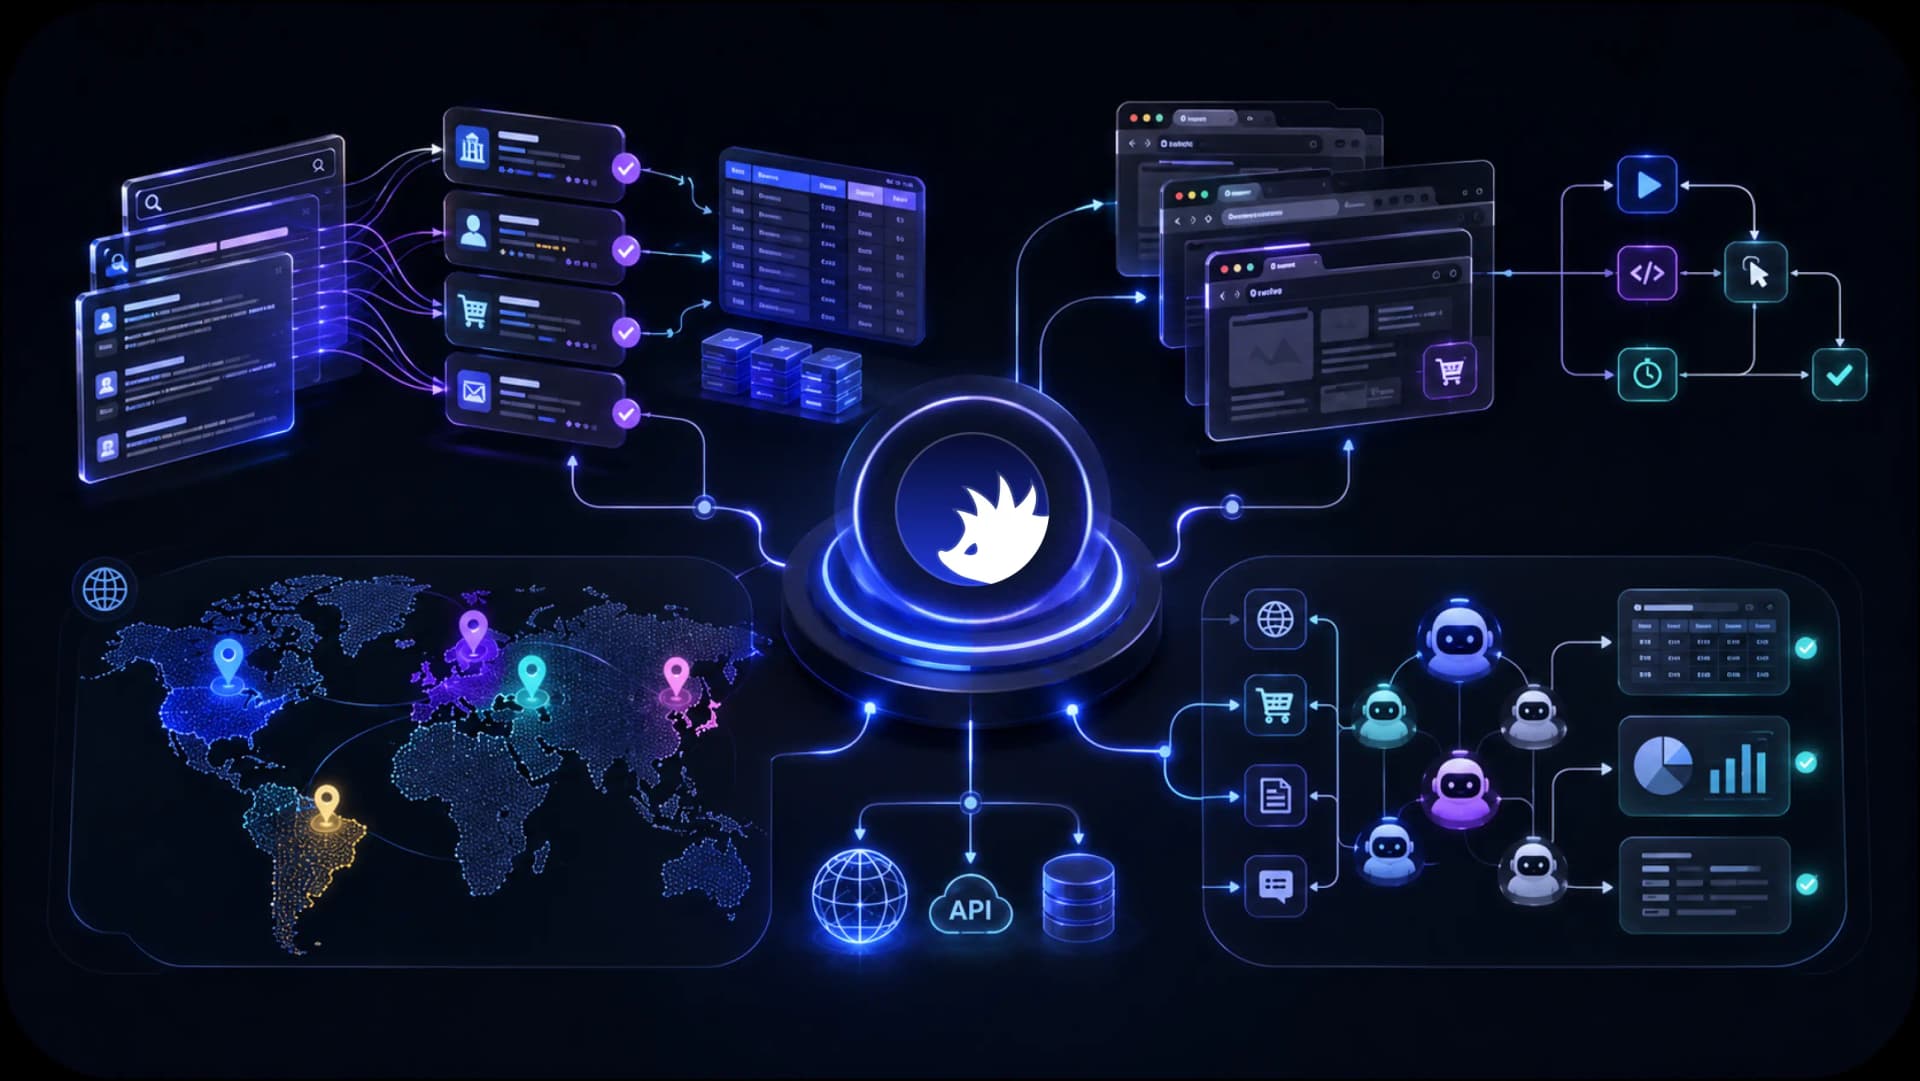
Acesse resultados de busca localizados, marketplaces, dados públicos da web e conteúdo regional em mais de 195 países para agentes de IA, sistemas de scraping e fluxos de trabalho autônomos.
A CyberYozh combina a infraestrutura que equipes de IA precisam para coletar dados, automatizar fluxos de trabalho, acessar conteúdo regional e escalar ambientes de execução. Desde proxies móveis LTE / 5G e residenciais até suporte à automação de navegadores, fingerprinting, verificações antifraude e celulares Android na nuvem, tudo é projetado para apoiar fluxos de trabalho de IA a partir de uma única plataforma.
Raspagem de dados na web com IA
Automação de navegador com IA
Coleta de dados de IA
Execução de agente de IA
Fluxos de trabalho de IA móvel
Acesso regional à IA
Veja como o CyberYozh funciona na prática por meio de fluxos de trabalho reais, recursos da plataforma e exemplos de infraestrutura. Explore o painel, integrações, ambientes de execução e ferramentas disponíveis para equipes de IA e projetos de automação.
Proxies são a infraestrutura crítica que garante que sua IA receba fluxos de dados atualizados, diversificados e ininterruptos para sua tarefa. Seja você desenvolvendo aplicações de IA, treinando modelos de machine learning ou monitorando preços de concorrentes e rankings de busca, aqui está o que isso ajuda você a alcançar.
Menos banimentos de IP e limites de taxa: Sites bloqueiam agressivamente IPs que enviam muitas requisições. Com IPs rotativos, você pode executar scraping de alto volume ininterrupto sem acionar defesas anti-bot.
Acesse conteúdo localizado: Proxies com geo-targeting permitem que você colete resultados de busca localizados, feeds sociais e preços regionais, dando ao seu modelo uma verdadeira perspectiva mundial.
Derrote medidas anti-bot: Sites modernos usam fingerprinting avançado e CAPTCHAs. Proxies premium parecem usuários reais para as plataformas, garantindo que você passe por essas verificações e capture os dados necessários.
Estabilidade e escala: A coleta de dados não pode ter tempo de inatividade. Uma rede de proxy robusta com balanceamento de carga mantém seus pipelines funcionando mesmo durante picos de demanda.
Proteja sua infraestrutura: Servidores proxy agem como um buffer, protegendo seu IP de origem e sistemas internos de agentes maliciosos e exposição legal.
Diferentes workflows de coleta de dados de IA criam diferentes demandas de infraestrutura, desde coleta de SERP localizada até dados de preços em tempo real e agentes de IA baseados em navegador.
Uma equipe fazendo scraping de milhões de páginas web para um corpus de treinamento de LLM atingiu limites de taxa em poucas horas em um único IP. Pipelines pararam com lotes incompletos, e engenheiros desperdiçaram dias desbloqueando endereços em vez de construir modelos. Eles mudaram para proxies de datacenter para dados de treinamento de IA, distribuindo requisições por milhares de IPs para ficar abaixo dos limites de detecção.
⚡ Resultado: scraping contínuo em capacidade total, metas diárias cumpridas e tempo de engenharia de volta ao desenvolvimento de modelos.
Yozh Scraper — gratuito, open-source, baseado em Playwright — combina extração automatizada com a rede de proxies da CyberYozh, para que você controle tipo de proxy, GEO, rotação e sessões em um único workflow.
Uma equipe de análise de SEO rastreando rankings de palavras-chave em dezenas de países enfrentou CAPTCHAs instantâneos e resultados geográficos inconsistentes do Google e Bing. Isso levou a dados de clientes não confiáveis e decisões ruins. Eles mudaram para proxies residenciais rotativos para coleta de dados SERP distribuindo volume de consultas por um grande pool de IPs.
⚡ Resultado: dados SERP precisos e específicos por país em escala com interrupções mínimas de CAPTCHA e rankings nos quais os clientes podiam confiar.
Baseado em API: a API do CyberYozh oferece controle programático direto sobre rotação e segmentação por país/região, integrando-se diretamente a stacks de scraping existentes como Scrapy, Playwright ou Postman — sem necessidade de gerenciamento manual de listas de proxies.
Um mecanismo de precificação dinâmica precisava monitorar preços de concorrentes em tempo real da Amazon e Walmart, mas as plataformas detectavam automação em minutos, exibindo preços distorcidos ou bloqueando IPs. A IA tomava decisões com base em dados desatualizados. Eles mudaram para proxies residenciais rotativos, fazendo com que as requisições parecessem de compradores locais reais.
⚡Resultado: precificação competitiva precisa e em tempo real para a IA, permitindo ajustes instantâneos de lances e promoções em vez de reagir aos números de ontem.
Uma equipe implantando agentes de IA baseados em navegador para tarefas de múltiplas etapas (logins, formulários, reservas de voos) continuava sendo bloqueada no meio do processo. Os sites identificavam frameworks de automação por fingerprinting e sinalizavam padrões de requisição variáveis; a rotação básica de IP não era suficiente para concluir um fluxo completo. Eles usaram um proxy móvel de alta confiança para agentes de IA com opções de fingerprint de SO, dando a cada agente uma identidade estável por tarefa.
⚡Resultado: conclusão confiável de múltiplas etapas e uma taxa de sucesso que substituiu tentativas e falhas constantes.
Uma equipe executando um sistema RAG para pesquisa financeira continuava obtendo respostas antigas ou em cache em vez de páginas ao vivo. Eles moveram o tráfego de recuperação para proxies residenciais rotativos com sessões sticky curtas, para que cada consulta obtivesse uma visualização atualizada e sem cache da página de origem.
⚡ Resultado: respostas de recuperação refletindo conteúdo web atual em vez de caches, com menos bloqueios interrompendo o pipeline.
⭐ Leia mais sobre a rede de proxies RAG
Uma equipe construindo um agregador de conteúdo com IA precisava extrair artigos, listagens e especificações de produtos de centenas de sites. Um único tipo de proxy funcionava em alguns sites e era bloqueado instantaneamente em outros, forçando engenheiros a manter soluções alternativas separadas. Eles mudaram para uma configuração mista de proxies (datacenter para sites permissivos, residenciais rotativos para sites protegidos) roteada através de uma única API para que o scraper pudesse alternar o tipo de proxy por alvo.
⚡ Resultado: um pipeline de scraping para todas as fontes, com menos correções de manutenção por site e entrega consistente de dados.
⭐ Saiba mais sobre proxies de web scraping para IA
Nem todos os proxies são construídos da mesma forma. Cada tipo serve um propósito distinto no pipeline de dados de IA:
Melhor para: Funciona como proxy de dados de treinamento de IA e também para pesquisa web, rastreamento de SERPe monitoramento de e-commerce. Proxies residenciais para machine learning também são uma escolha popular.
Por quê: IPs reais atribuídos por ISP com padrões de navegação orgânicos fornecem pontuações de confiança mais altas, tornando-os eficazes contra sistemas anti-bot sofisticados como Cloudflare e DataDome.
Melhor para: Dados de aplicativos móveis, scraping de plataformas sociais (Instagram, TikTok, X) e verificação de anúncios.
Por quê: IPs atribuídos por operadoras carregam a reputação de rede mais forte. IPs móveis raramente são colocados em listas negras porque representam dispositivos de consumidores reais com células de rede rotativas.
Melhor para: Alta velocidade coleta de dados públicos, crawling em massa para treinamento de LLM e agregação de preços.
Por quê: Servidores entregam throughput rápido ao menor custo por requisição. Ideal quando o volume importa mais do que evitar bloqueadores agressivos.
Conclusão para operadores: Proxies residenciais rotativos são o padrão para a maioria das tarefas de coleta de IA — não apenas para evitar bloqueios, mas para injetar diversidade geográfica e comportamental em seus dados de treinamento, melhorando a generalização do modelo. No entanto, se você precisar de sessões com login, opte por residenciais estáticos ou móveis.
Sim. Coletar dados web publicamente disponíveis para treinamento de IA, pesquisa de mercado ou monitoramento de preços é uma prática padrão, e a infraestrutura da CyberYozh é construída para apoiá-la de forma responsável.
Antes de coletar:
Verifique os Termos de Serviço da fonte e as regras de crawling
Identifique se dados pessoais estão envolvidos
Colete apenas o que seu caso de uso requer
Mantenha registro de onde e quando os dados foram coletados.
Defina suas fontes. Liste os sites, APIs ou plataformas dos quais você precisa de dados e observe quais têm restrição geográfica, limite de taxa ou proteção contra bots.
Escolha seu tipo de proxy. Datacenter para velocidade e volume, residencial para sites com forte detecção anti-bot, móvel para alvos de maior confiança.
Selecione sua GEO. Combine localizações de proxy com as regiões que suas fontes atendem, até o nível de cidade onde os resultados localizados são importantes.
Configure rotação e sessões. Faça rotação por solicitação para scraping de alto volume ou mantenha uma sessão persistente (até 24 horas) quando uma tarefa precisar de uma identidade consistente.
Conecte via API. Integre o acesso proxy em Scrapy, Playwright, Puppeteer ou Selenium com rotação programática e segmentação GEO, sem gerenciamento manual de listas de proxy.
Colete. Execute o pipeline em suas fontes definidas usando a configuração de proxy estabelecida.
Alimente o conjunto de dados. Direcione os dados validados para seu pipeline de treinamento de IA ou aplicação.
A CyberYozh combina múltiplos tipos de proxy, cobertura global e controles prontos para automação para que equipes de IA possam adequar sua infraestrutura de coleta ao tamanho do conjunto de dados, geografia e requisitos de fluxo de trabalho.
Proxies residenciais rotativos: Mais de 100 milhões de IPs residenciais em mais de 195 países. Rotação flexível, sessões persistentes de 24 horas e segmentação geográfica gratuita para coleta consistente de dados não distorcidos.
Proxies móveis LTE/5G reais (largura de banda ilimitada): Colete dados específicos de dispositivos móveis ou dependentes de localização através de redes de operadoras reais sem pagar a mais por GB.
Suporte a API e automação: Integre com pipelines de dados de IA, scripts personalizados e ferramentas como Playwright, Puppeteer, Selenium, Postmane Scrapy.
Rotação flexível: escolha entre rotação por solicitação e sessões persistentes para adaptar o comportamento de coleta a diferentes conjuntos de dados e fontes.
Plataforma tudo-em-um com proxies, verificação por SMS, cartões de pagamento virtuais e verificação de qualidade de IP para escalonamento confortável.
Suporte ao cliente responsivo 24/7 em 7 idiomas via e-mail e Telegram.