Redes móveis LTE / 5G reais
Execute agentes de IA em redes reais de operadoras com tráfego móvel ilimitado e canais dedicados.
- Redes reais de operadoras LTE / 5G
- Rotação de IP manual e via API
- Ambientes de alta confiança
- Sessões de IA estáveis

Tenha acesso a mais de 100M de proxies residenciais, móveis LTE/5G e de datacenter limpos para coleta de datasets de IA, treinamento de LLMs e pipelines de RAG. Defina um direcionamento preciso por cidade e CEP em mais de 195 países para obter resultados exatos, com taxa de sucesso de 99,9%. A rotação de IP controlada ou as sticky sessions permitem coletar dados de treinamento de IA com menos CAPTCHAs e limites de requisições.
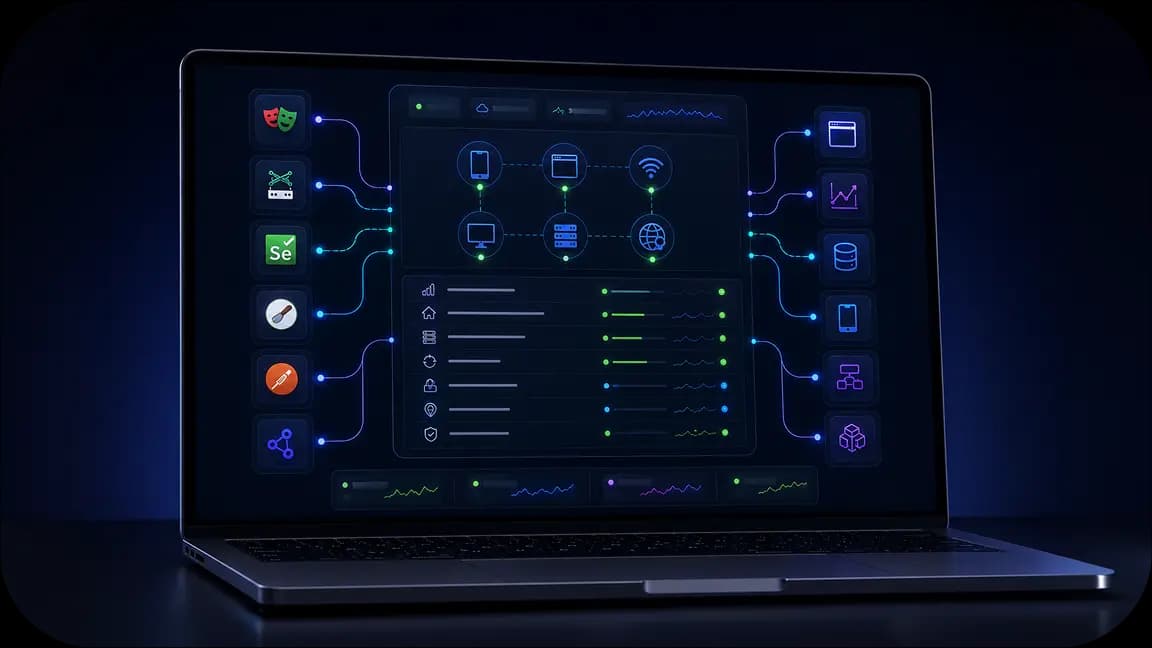
Conecte proxies diretamente ao seu stack de coleta de dados para construir corpus de treinamento em grande escala. Integração API com Playwright, Puppeteer, Selenium, Scrapy e scripts de scraping personalizados.
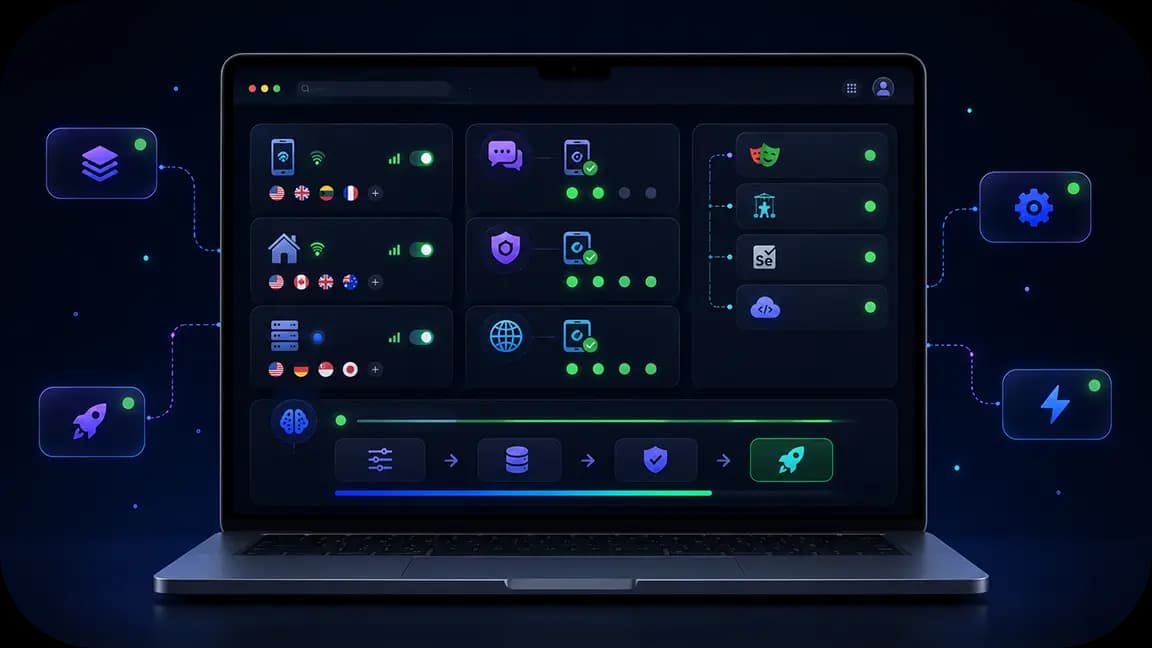
Configure um proxy para web scraping de RAG ou coleta de datasets de IA em poucos passos. Controle a rotação de IP e as sticky sessions em um único painel de controle, fácil para iniciantes, e gere credenciais em massa conforme o tamanho do seu dataset e a diversidade de fontes aumentam.
Faça web scraping para treinamento de LLMs e colete dados multilíngues em mais de 195 países com proxies residenciais, com segmentação granular por cidade e CEP. Monte conjuntos de treinamento precisos, que reflitam a diversidade global real.
Os proxies da CyberYozh incluem opções de alternância de impressão digital do sistema operacional para alinhar o perfil do seu dispositivo com cada IP. Verifique seu IP quanto à pontuação de fraude antes de executar fluxos de trabalho para reduzir CAPTCHAs e solicitações bloqueadas.
Execute agentes de IA em redes reais de operadoras com tráfego móvel ilimitado e canais dedicados.

Reduza as interrupções no fluxo de trabalho com suporte à resolução de CAPTCHA e ferramentas de validação desenvolvidas para automação.

Gerencie proxies, ativação de SMS, impressão digital, verificações de fraude e integrações a partir de um único ambiente.
O CyberYozh App oferece uma infraestrutura de proxies confiável para a coleta em larga escala de dados para treinamento de IA. A plataforma reúne mais de 100 milhões de IPs residenciais, redes móveis LTE/5G reais e proxies de datacenter, com segmentação granular, sticky sessions, troca de fingerprint do sistema operacional, verificação antifraude de IPs e números virtuais. Colete corpus de pré-treinamento, monte um conjunto de fine-tuning específico para um domínio ou reúna dados de várias regiões com menos CAPTCHAs e menos pipelines travados.
Acesse resultados de busca localizados, marketplaces, dados públicos da web e conteúdo regional em mais de 195 países para agentes de IA, sistemas de scraping e fluxos de trabalho autônomos.
A CyberYozh combina a infraestrutura que equipes de IA precisam para coletar dados, automatizar fluxos de trabalho, acessar conteúdo regional e escalar ambientes de execução. Desde proxies móveis LTE / 5G e residenciais até suporte à automação de navegadores, fingerprinting, verificações antifraude e celulares Android na nuvem, tudo é projetado para apoiar fluxos de trabalho de IA a partir de uma única plataforma.
Raspagem de dados na web com IA
Automação de navegador com IA
Coleta de dados de IA
Execução de agente de IA
Fluxos de trabalho de IA móvel
Acesso regional à IA
Veja como o CyberYozh funciona na prática por meio de fluxos de trabalho reais, recursos da plataforma e exemplos de infraestrutura. Explore o painel, integrações, ambientes de execução e ferramentas disponíveis para equipes de IA e projetos de automação.
Montar um corpus de treinamento em escala esbarra quase sempre no mesmo obstáculo: a fonte não quer ser raspada com tanta intensidade, tão rápido e a partir de um único endereço.
Sites limitam ou bloqueiam IPs que enviam um grande volume de requisições – a coleta de dados para muito antes de atingir o tamanho desejado, e a equipe de engenharia perde tempo com desbloqueios.
Cloudflare e DataDome identificam padrões de requisição não humanos e fingerprints de dispositivo, exibindo barreiras de CAPTCHA.
Coleta a partir de uma única região – sem IPs locais, não é possível coletar de forma confiável fontes, idiomas e perspectivas específicos de outros mercados
Reddit, fóruns de nicho e outras fontes de treinamento de alto valor exigem cadastro e verificação por telefone para dar acesso ao conteúdo completo, o que cria uma segunda barreira além do bloqueio por IP.
Os proxies da CyberYozh App resolvem os quatro problemas ao distribuir as requisições por IPs que parecem usuários reais, nas localizações certas e no volume que os corpora de treinamento exigem.
Abra o catálogo de proxies da CyberYozh App para coleta de dados de IA
Verifique a qualidade do IP antes de executar os fluxos de trabalho
Reddit, Hacker News, Stack Exchange e comunidades de nicho estão entre as fontes mais ricas de dados conversacionais e específicos de domínio para treinamento, mas também são as mais rígidas com limites de requisições. Proxies móveis para datasets de IA funcionam melhor aqui, pois IPs reais de operadoras móveis como Vodafone ou T-Mobile passam por verificações que barram tráfego de datacenter de imediato.
Dica: Telas de login e threads com carregamento lazy geralmente exigem Playwright ou Puppeteer para renderizar e paginar o conteúdo antes que ele possa ser capturado.
GitHub, GitLab e registros de pacotes são em sua maioria abertos e compatíveis com API, por isso os proxies de datacenter funcionam bem aqui: rápidos, baratos e com confiança suficiente para coletas de grande volume.
Publicações, periódicos e arquivos licenciados exigem uma abordagem mais discreta. Proxies residenciais ou móveis ajudam nesse caso, junto com um registro do que foi acessado e de que forma, já que essas fontes são as que mais sofrem escrutínio jurídico na coleta de dados para treinamento de IA.
Listagens de produtos e avaliações de E-commerce mudam o tempo todo e são monitoradas de perto contra scraping. Proxies residenciais rotativos mantêm o volume alto sem causar preços distorcidos ou bloqueios que sinalizam tráfego automatizado.
Montar um corpus que generalize entre idiomas e regiões significa coletar diretamente de fontes locais, e não apenas da versão que o seu servidor por acaso recebe. Proxies residenciais com geotargeting em mais de 195 países trazem conteúdo autêntico, nativo de cada região, em vez de enviesar os dados para o local de onde o crawl parte.
Em vez de montar uma camada de scraping separada para cada tipo de fonte, o Yozh Scraper executa jobs baseados em Playwright via proxies móveis, residenciais ou de datacenter de forma nativa. Uma única ferramenta cuida da coleta de dados de IA em plataformas sociais, sites de e-commerce e fontes de notícias.
💡 Conclusão prática: a maioria dos corpora de treinamento mistura várias dessas categorias. Combinar tipos de proxy conforme a fonte, em vez de usar um único tipo para tudo, reduz custos nos alvos fáceis e mantém a taxa de sucesso alta nos difíceis.
Escolha o proxy de acordo com a resistência da fonte.
IPs de operadoras móveis têm mais confiança do que IPs residenciais. São a melhor opção para coletar dados de treinamento de IA em plataformas mobile-first: Instagram, TikTok, Reddit ou contas do Facebook que exigem verificação por SMS antes de liberar o acesso completo.
Dica: conclua o cadastro da conta sem problemas operacionais usando o número virtual da CyberYozh App para verificação por SMS em mais de 195 países.
IPs residenciais estão vinculados a provedores de internet reais e parecem usuários reais para as plataformas. São mais confiáveis para plataformas de redes sociais, fóruns, e-commerce e sites de notícias, incluindo threads do Reddit e avaliações de produtos.
IPs de datacenter dão conta de coletas de grande volume em que uma identidade residencial não é necessária. São ideais para repositórios de código, datasets governamentais e arquivos públicos, como GitHub, registros de pacotes e portais de dados abertos.
Na coleta de dados de IA em larga escala, o custo dos proxies sobe rapidamente conforme cresce o volume de scraping. Os proxies residenciais cobram pelo tráfego consumido, enquanto os proxies móveis dedicados da CyberYozh App oferecem tráfego ilimitado por um preço diário fixo. Compare os custos em diferentes volumes de coleta.
Tráfego por dia | Residencial ($2.5/GB, a partir de 100 GB) | Móvel dedicado ($3.5/dia) |
|---|---|---|
3 GB | $7.5 | $3.50 |
10 GB | $25 | $3.50 |
25 GB | $62.50 | $3.50 |
50 GB | $125 | $3.50 |
100 GB | $250 | $3.50 |
Móvel dedicado: $105/mês, independentemente do volume de tráfego, sujeito aos termos de uso ilimitado do plano.
Residencial: $62.5/mês com 25 GB, $250 com 100 GB.
Com 500 GB/mês: o residencial custa $1,100/mês (plano business), contra $105 do móvel dedicado.
A coleta de dados para treinamento de IA está sob escrutínio jurídico crescente, e a responsabilidade alcança cada vez mais toda a cadeia, não apenas a empresa que treina o modelo. Uma origem dos dados limpa e documentada é o que separa um processo de coleta defensável de um que não resiste a questionamentos.
Algumas práticas reduzem essa exposição e tornam a sua origem dos dados defensável caso seja questionada:
Respeite o robots.txt e os limites de requisições publicados em vez de contorná-los.
Mantenha logs de scraping – com timestamps, URLs de origem e métodos de acesso, para poder demonstrar o que foi coletado e como.
Rastreie a procedência de IPs e dados de ponta a ponta, em vez de confiar na palavra de um intermediário sobre como os dados foram obtidos.
Separe a coleta de dados de IA da redistribuição e documente qualquer uso posterior, restrição de licença ou direito de terceiros sobre os dados antes de compartilhar datasets de treinamento.
A CyberYozh App reúne em uma única plataforma todas as camadas necessárias para a coleta de dados de treinamento de IA – proxies, verificação e prevenção de fraudes. Assim, as equipes não precisam juntar fornecedores diferentes para cada etapa do pipeline.
Mais de 100M de proxies residenciais com sessões rotativas e sticky de até 24 h, filtragem de IP, geotargeting gratuito e rotação controlada por API
Proxies móveis 5G/LTE reais com tráfego ilimitado para coleta em grande volume, sem que limites de dados atrasem a montagem do corpus
Geotargeting por cidade e CEP em mais de 195 países para dados regionais e multilíngues autênticos
Verificação de fraud score do IP para pré-filtrar saídas e manter a coleta limpa
Troca de fingerprint do SO para reduzir CAPTCHAs e requisições bloqueadas
Números SMS virtuais e cartões de pagamento para superar barreiras de cadastro e verificação sem expor contas pessoais
Compatibilidade de API com Playwright, Puppeteer, Selenium, Postman, Scrapy e ferramentas personalizadas.
Escolha o tipo de proxy. Datacenter para repositórios abertos e coletas em massa via API, residencial para fontes com limite de requisições ou restritas por região, móvel LTE/5G para fóruns, plataformas sociais e barreiras de cadastro.
Configure a localização. Selecione o direcionamento por país, cidade ou CEP para que cada fonte de dados seja acessada a partir da região correspondente — caso contrário, o corpus herda um viés geográfico.
Obtenha as credenciais. Copie o endpoint, o usuário e a senha na panel de controle, ou gere uma chave de API para uso programático no pipeline.
Conecte. Adicione as credenciais ao Playwright, Puppeteer, Selenium, Scrapy ou ao seu script personalizado — ou execute o Yozh Scraper para dispensar a configuração manual. Defina rotação ou sticky por requisição ou por sessão na mesma configuração.
Teste a conexão. Verifique o IP de saída e o fraud score do IP, depois execute uma requisição de teste para confirmar que a rotação, a duração das sessões sticky e o geotargeting funcionam como esperado antes de escalar a montagem do corpus.
Conheça proxies para tarefas semelhantes: proxies para agentes de busca com IA, infraestrutura de proxies para ChatGPT e proxy para coleta de dados de SERP.