AI proxy: Como os proxies suportam agentes de IA
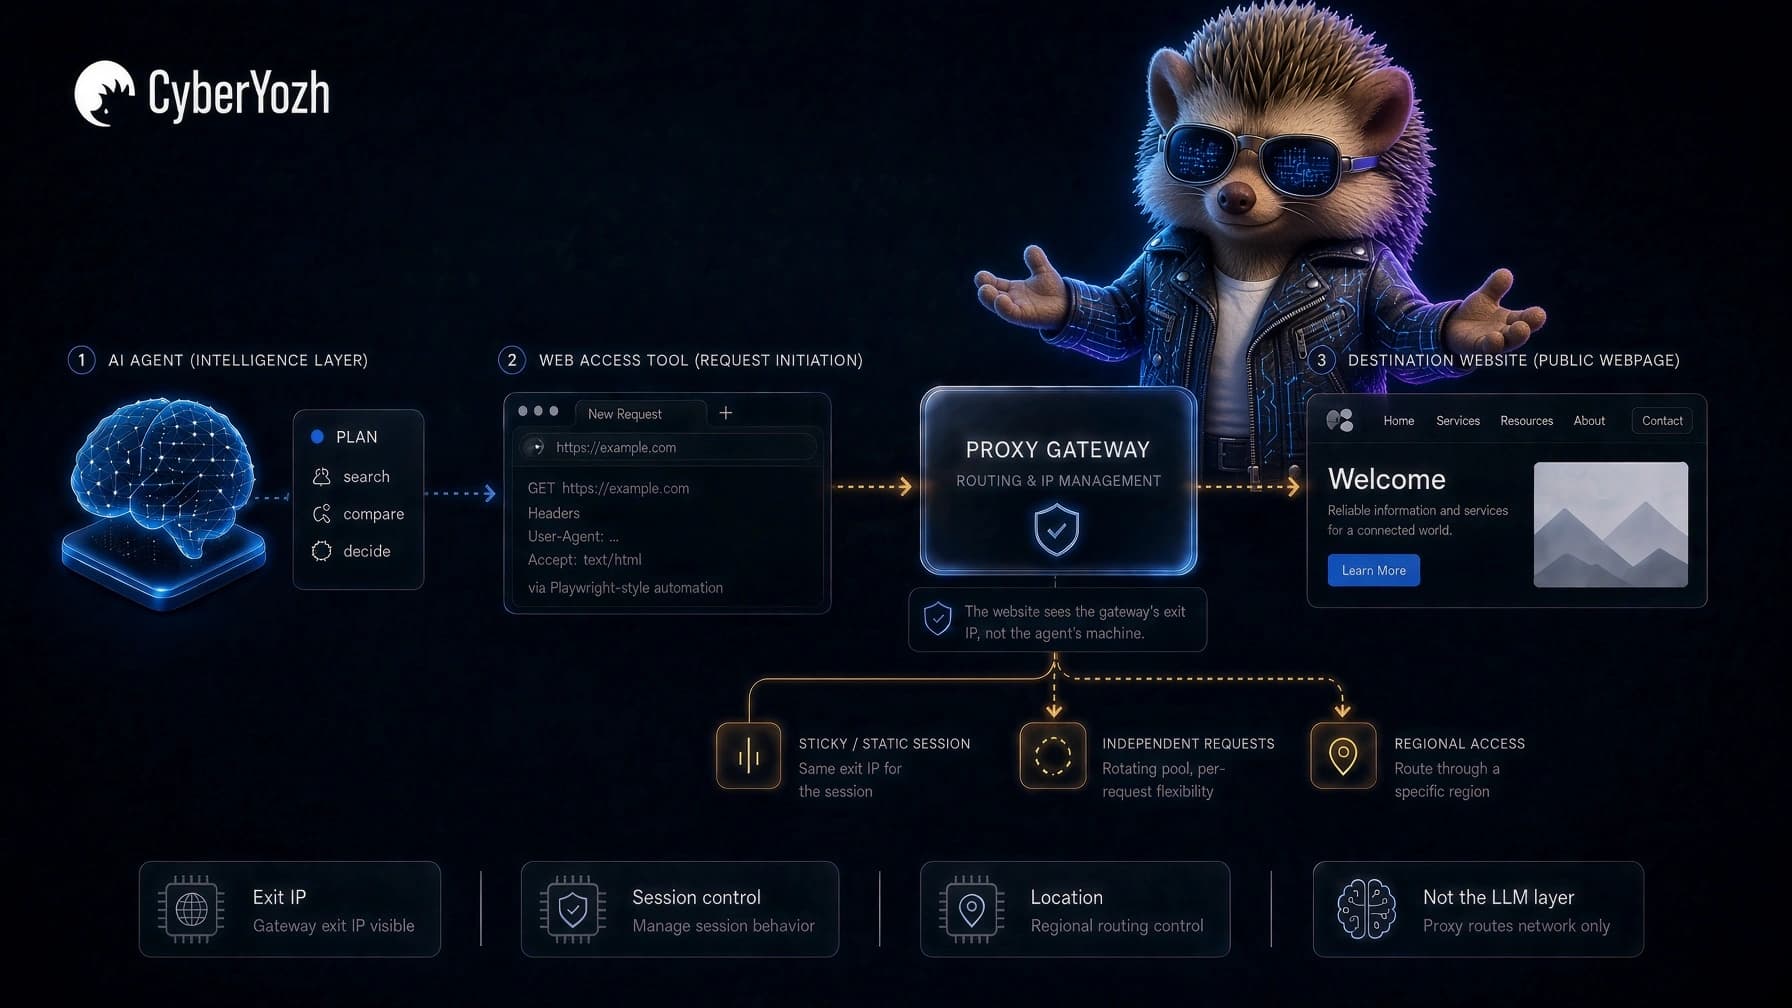
Um agente de IA pode planejar uma tarefa, escolher uma ferramenta, abrir um navegador, pesquisar um site, comparar resultados e decidir o que fazer a seguir. Mas no momento em que ele alcança a web, algo muito comum acontece: ele faz uma requisição de rede.
Essa requisição ainda vem de um endereço IP e tem uma localização, uma rota de rede e uma sessão por trás dela. Dependendo da tarefa, o agente pode precisar manter esse IP durante toda uma jornada no navegador, acessar a web de uma localização específica ou distribuir milhares de requisições independentes através de um pool de IPs rotativos.
É aí que um proxy de IA entra em cena.
Para agentes de navegador, agentes de scraping, ferramentas de pesquisa e outras automações conectadas à web, um proxy de IA controla a rota de rede entre a ferramenta de acesso à web do agente e seu destino. Ele pode determinar o tipo e a localização do IP, por quanto tempo um IP permanece com uma sessão e quando o tráfego se move através de um pool maior.
O CyberYozh App fornece essa camada de rede através de proxies de agentes de IA, infraestrutura de agentes de navegador, proxies residenciais, rotas móveis, IPs de datacenter e integrações com ferramentas de automação comuns.
A IA ainda faz o raciocínio. O proxy gerencia como essa IA alcança a web.
Resumo
Um proxy de IA pode significar duas coisas diferentes: um proxy de rede que controla como um agente de IA alcança a web, ou um gateway de IA/proxy LLM que gerencia requisições entre uma aplicação e provedores de modelos.
Para agentes conectados à web, o proxy fica entre o navegador ou cliente HTTP e o destino, controlando o IP de saída, localização, tipo de rede, comportamento da sessão e rotação.
Proxies de IA podem suportar agentes de navegador, web scraping de IA, RAG e recuperação web, pesquisa, localização e QA, e monitoramento quando a rota de rede importa para a tarefa.
Escolha o proxy de acordo com a carga de trabalho: ISP estático para sessões estáveis mais longas, residencial sticky para continuidade temporária, residencial rotativo para requisições independentes, móvel quando o roteamento de operadora importa, e datacenter quando uma infraestrutura mais simples é suficiente.
Configure o proxy na ferramenta que realmente acessa a web, como Playwright, Puppeteer, Selenium, Scrapy ou Postman, em vez de no próprio modelo de linguagem.
Rotação não é automaticamente melhor. Mantenha a rota estável quando as requisições pertencem à mesma sessão e faça rotação quando a carga de trabalho consiste em requisições independentes.
Um proxy gerencia apenas a camada de rede. Ele não protege prompts, gerencia o estado do navegador, corrige a lógica de extração, controla permissões do agente ou torna as decisões do modelo mais seguras.
Com o CyberYozh App, a configuração prática consiste em escolher a localização e o comportamento de sessão corretos, configurar a conexão na ferramenta de acesso à web, verificar o IP de saída e adicionar controle baseado em API apenas quando o fluxo de trabalho precisar.
O que é um proxy de IA?
Um proxy de IA é um intermediário usado dentro de um fluxo de trabalho de IA para rotear conexões entre diferentes partes do sistema. O que ele realmente conecta depende de qual tipo de proxy de IA você quer dizer: um proxy de rede para agentes de IA que controla como um agente de IA alcança a web, ou um gateway de IA ou proxy LLM que gerencia como uma aplicação se comunica com provedores de modelos.
Eles ficam em diferentes camadas da pilha de IA e resolvem problemas diferentes.
Um proxy de rede para agentes de IA
Isso é sobre o que estamos falando principalmente neste artigo.
O fluxo se parece com algo assim:
Agente de IA → navegador ou cliente HTTP → proxy → site
O proxy de IA controla a conexão de rede entre a ferramenta do agente e o destino.
Isso pode alterar:
O endereço IP visível
A localização geográfica da conexão
O tipo de rede, como residencial, móvel, ISP ou datacenter
Por quanto tempo o mesmo IP permanece vinculado a uma sessão
Como as solicitações são distribuídas em um pool de IPs
Obtenha o CyberYozh App proxy de agente de IA.
Um gateway de IA ou proxy LLM
Um gateway de IA fica em outro lugar.
Seu fluxo se parece mais com:
Aplicação → gateway de IA → provedor de modelo
Ele pode centralizar o roteamento de modelos, registro, tentativas, controles de taxa, seleção de provedores e funções semelhantes no nível da API. A Cloudflare, por exemplo, descreve seu AI Gateway como uma camada para observar e controlar solicitações de modelos com recursos incluindo registro, cache, limitação de taxa, tentativas e fallback. Documentação do Cloudflare AI Gateway
Essa é uma infraestrutura útil, mas não é a mesma coisa que dar a um agente de navegador um IP residencial.
Dica profissional: Um gateway de IA controla como sua aplicação alcança o modelo. Um proxy de IA de rede controla como o agente alcança a web. Ambos podem existir no mesmo sistema.
Proxy de rede para agentes de IA | |
Fica entre | Navegador/cliente do agente e site |
Controla | IP, localização, tipo de rede, sessões fixas, rotação |
Uso típico | Agentes de navegador, web scraping, pesquisa, testes regionais |
Fluxo de exemplo | Agente → proxy → site |
CyberYozh App fornece isso? | Sim |
Como funciona um proxy de IA?
Um proxy de IA de rede funciona entre a ferramenta que um agente de IA usa para acessar a web e o site ou serviço que ele precisa alcançar. Em vez de se conectar diretamente a partir da máquina que executa o agente, a solicitação primeiro passa por um servidor proxy.
A rota básica é assim:
Agente de IA → navegador ou cliente HTTP → servidor proxy → site
Quando o navegador, scraper ou cliente HTTP envia uma solicitação, o proxy a recebe e a encaminha para o destino usando um IP de saída de sua rede. O site vê esse IP de saída em vez do IP da máquina que executa o agente. A resposta então retorna através do proxy para a ferramenta de acesso à web do agente.
O que acontece com o IP ao longo do caminho depende da configuração do proxy. O agente pode manter o mesmo IP durante toda uma sessão de navegador de várias etapas, usar um IP fixo por um período definido ou obter diferentes IPs de saída de um pool rotativo para solicitações independentes. A localização também pode ser selecionada quando o fluxo de trabalho precisa de acesso à web de um país ou região específica.
Por que os agentes de IA usam proxies ao acessar a web
Se um agente de IA permanece dentro do seu banco de dados ou software interno, ele pode não precisar de um proxy.
O proxy se torna relevante quando o agente começa a interagir com sites e serviços externos.
Pense em um agente de pesquisa que precisa abrir centenas de páginas públicas de produtos. Ou um agente de QA testando um site de vários países. Ou um agente de navegador que precisa permanecer na mesma sessão enquanto percorre um fluxo de trabalho de cinco etapas.
Esses trabalhos têm requisitos de rede muito diferentes.
Agentes de navegador de IA precisam de uma rota consistente
Um agente de navegador pode pesquisar, clicar, navegar, comparar informações, fazer capturas de tela, preencher formulários aprovados ou interagir com aplicações web.
Se o fluxo de trabalho durar vários minutos, mudar o IP no meio do caminho pode ser desnecessário ou ativamente prejudicial.
Para esse tipo de trabalho, a rota de rede geralmente deve ser previsível.
O ambiente do navegador ainda é uma camada separada. Cookies, armazenamento, cabeçalhos, sessões e segurança do navegador não desaparecem simplesmente porque o IP muda.
Um proxy gerencia a identidade de rede. Ele não substitui um bom design de agente de navegador.
Agentes de pesquisa de IA podem precisar de controle de localização
Imagine um agente de IA comparando resultados de pesquisa públicos, preços, disponibilidade ou páginas localizadas em vários países.
Executar todas as solicitações de uma única localização na nuvem pode dar ao agente uma visão muito incompleta.
Um proxy permite que o agente faça solicitações através de uma rota na região que está sendo testada.
Isso não muda a identidade ou elegibilidade do usuário para um serviço. Simplesmente muda a localização de rede usada para a solicitação.
Agentes de scraping de IA podem precisar de vários IPs
A coleta de dados públicos em larga escala tem uma forma diferente.
O agente pode não se importar em manter uma identidade de navegador por uma hora. Ele pode estar buscando muitas páginas independentes, validando respostas, extraindo informações estruturadas e seguindo em frente.
É aí que o web scraping de IA e a infraestrutura de proxy rotativo se tornam mais úteis.
O scraper ainda precisa de lógica de retry, parsing, deduplicação, validação e ritmo sensato de requisições. O proxy resolve apenas a parte de roteamento de rede desse sistema.
O proxy é infraestrutura, não inteligência. Ele pode melhorar como um agente alcança um recurso, mas não pode corrigir uma lógica de extração ruim ou uma decisão ruim tomada pelo modelo.
Casos de uso de proxy de IA
Proxies de IA se tornam úteis quando um sistema de IA precisa interagir com a web pública e a rota de rede importa para a tarefa. O papel exato do proxy depende do que o agente está tentando recuperar, testar, monitorar ou automatizar.
Caso de uso | O que a IA está fazendo | O que o proxy adiciona |
Agentes de navegador | Navegando em sites e completando tarefas de múltiplas etapas | Sessões estáveis e controle sobre a localização de rede |
Web scraping de IA | Coletando dados públicos de muitas páginas | Acesso a pools de IP rotativos para requisições independentes |
RAG e recuperação web | Buscando conteúdo web atual antes de passá-lo para um LLM | Acesso distribuído e com reconhecimento de localização a páginas de origem |
Agentes de pesquisa | Comparando informações públicas entre sites ou mercados | Roteamento de IP regional para resultados localizados |
Localização e QA | Testando como um site ou aplicação se comporta em diferentes regiões | Acesso a partir de IPs nas localizações sendo testadas |
Agentes de monitoramento | Verificando páginas públicas repetidamente em busca de mudanças | Rotas consistentes ou distribuídas dependendo do trabalho de monitoramento |
RAG e recuperação web
A geração aumentada por recuperação se torna particularmente relevante quando a informação que um sistema de IA precisa não está disponível em seu modelo ou base de conhecimento interna.
Um fluxo de trabalho RAG pode recuperar informações de bancos de dados, APIs, documentos ou da web antes de fornecer material relevante ao modelo. Quando a fonte de recuperação é um site público, o componente de acesso à web ainda precisa fazer requisições de rede comuns.
Um proxy pode controlar o IP e a localização usados para essas solicitações. Isso se torna útil quando o sistema de recuperação coleta informações públicas em diferentes regiões ou distribui uma carga de trabalho de recuperação maior em várias rotas.
O proxy não realiza a recuperação nem melhora o raciocínio do modelo. Ele fornece a camada de rede usada para alcançar as fontes das quais o sistema RAG recupera informações.
Segmentação geográfica e QA com IA
Agentes de IA também podem automatizar partes de testes regionais de sites e aplicações. Um agente pode verificar páginas localizadas, resultados de pesquisa, disponibilidade de produtos, variações de idioma ou outros conteúdos que podem diferir dependendo de onde uma solicitação se origina.
Rotear o agente através de um proxy na localização sendo testada permite que o fluxo de trabalho de QA observe a web daquela localização de rede em vez de depender inteiramente do servidor onde a automação está sendo executada.
Obtenha os proxies de geotargeting do CyberYozh App para aparecer como um usuário local genuíno em qualquer país, cidade ou rede de operadora.
Agentes de monitoramento
Agentes de monitoramento verificam repetidamente recursos públicos em busca de alterações, como informações de produtos, disponibilidade, resultados de pesquisa, dados de mercado ou atualizações de sites.
Um agente que verifica repetidamente o mesmo recurso pode funcionar perfeitamente bem com uma rota consistente, enquanto um sistema de monitoramento maior cobrindo muitas fontes independentes pode se beneficiar da distribuição de solicitações em um pool de IPs.
Assim como em outros casos de uso de proxy de IA, a estratégia de rede deve seguir a carga de trabalho em vez de aplicar rotação simplesmente porque está disponível.
Qual tipo de proxy de IA você deve usar?
Não existe um único melhor proxy para cada agente de IA.
A melhor escolha depende do que o agente está fazendo assim que sai da sua infraestrutura e alcança a web pública.
Carga de trabalho de IA | Proxy a considerar | Por quê |
Tarefa de navegador em várias etapas | ISP estático | Mantém um IP consistente |
Sessão de navegador residencial | Residencial sticky | Mantém uma rota residencial durante a sessão |
Grande carga de trabalho de dados públicos | Residencial rotativo | Distribui solicitações independentes |
Gateway rotativo automatizado | Proxy backconnect | Fornece ao cliente um gateway enquanto as saídas rotacionam |
Teste de rede móvel | Móvel | Usa infraestrutura LTE/5G |
Automação direta | Datacenter | Simples e econômico onde o roteamento residencial é desnecessário |
Proxies ISP estáticos para sessões longas de agentes de IA
Um agente de longa duração geralmente se beneficia de uma rota estável.
Por exemplo, se um agente abre um site, navega por várias páginas, escolhe opções e então retorna um resultado, manter um IP durante toda a jornada é mais fácil de raciocinar.
Os proxies ISP estáticos do CyberYozh App fornecem a esse fluxo de trabalho um endereço persistente com suporte de ISP.
Isso geralmente é mais apropriado do que rotacionar o IP simplesmente porque a rotação está disponível.
Proxies residenciais sticky para continuidade temporária
Às vezes você deseja roteamento residencial sem manter o mesmo IP indefinidamente.
Uma sessão sticky permite que várias solicitações relacionadas compartilhem uma saída por um período definido.
Isso pode funcionar bem quando o agente precisa de continuidade de sessão, mas o sistema maior ainda usa um pool residencial.
Proxies residenciais rotativos para solicitações independentes
Se o agente está coletando muitas páginas públicas não relacionadas, a rotação se torna mais útil.
CyberYozh App proxies residenciais rotativos podem suportar cargas de trabalho onde diferentes solicitações não precisam compartilhar uma identidade de rede de longa duração.
Proxies backconnect para rotação automatizada
Um proxy backconnect fornece à sua automação um gateway de proxy único enquanto a infraestrutura gerencia a mudança de IPs de saída por trás dele.
Isso pode simplificar algumas arquiteturas de agentes porque o cliente não precisa manter uma lista enorme de endereços de proxy individuais.
Para automação de alto volume, isso geralmente é mais fácil de gerenciar do que alimentar novos IPs na aplicação manualmente.
Proxies mobile para fluxos de trabalho de rede de operadora
Proxies mobile usam infraestrutura de rede móvel.
Eles fazem sentido para fluxos de trabalho onde o roteamento LTE ou 5G é realmente parte do que você está testando.
Isso pode incluir QA mobile, experiências mobile regionais ou um agente cuja tarefa depende especificamente de uma rota de rede de operadora.
Não escolha mobile automaticamente porque parece mais avançado. Se a tarefa não precisa de uma rede móvel, outro tipo de proxy pode ser mais simples.
Proxies de datacenter para automação de IA mais simples
Muitas tarefas de automação não precisam de características residenciais ou mobile.
Um proxy de datacenter pode ser uma escolha direta para verificações técnicas, desenvolvimento, monitoramento, trabalho com dados abertos e outros trabalhos onde um IP de infraestrutura normal é suficiente.
O proxy certo é a rede menos complicada que atende à tarefa.
Como configurar um proxy de IA com CyberYozh App
Uma vez que você sabe qual rota de rede seu agente de IA precisa, a configuração se resume a configurar a ferramenta que ele usa para acessar a web. Você já escolheu o tipo de proxy apropriado; agora você precisa decidir como a conexão deve se comportar e conectá-la à camada de acesso à web do agente.
Passo 1. Escolha a localização
Se a geografia importa para a tarefa, selecione o país, região ou outra opção de segmentação disponível que o agente precisa.
Isso pode importar para pesquisa de IA, recuperação web localizada, QA regional, monitoramento e outros fluxos de trabalho onde o conteúdo retornado por um site pode variar dependendo da localização da solicitação.
Se a geografia não importa, não há razão para adicionar um requisito de localização simplesmente porque a opção existe.
Passo 2. Decida como o IP deve se comportar
Em seguida, decida se o agente deve manter seu IP ou mudá-lo.
Uma jornada de navegador com várias etapas geralmente se beneficia da continuidade. Para grandes conjuntos de solicitações independentes, a rotação pode ser mais apropriada. Uma sessão sticky fica em algum lugar entre as duas, mantendo o mesmo IP de saída por um período definido.
A parte importante é fazer o comportamento do IP seguir a tarefa do agente em vez de um temporizador arbitrário. Nosso guia de rotação de proxy explica as diferentes abordagens em mais detalhes.
Passo 3. Escolha o protocolo compatível com seu cliente
O protocolo precisa ser compatível com o navegador, framework de automação, scraper ou cliente HTTP que faz a solicitação.
Escolha de acordo com o que o cliente e o fluxo de trabalho realmente exigem, em vez de tratar um protocolo como universalmente melhor. Se precisar de ajuda para decidir entre as opções comuns.
Veja nossa comparação entre proxies SOCKS5 e HTTPS.
Passo 4. Obtenha suas credenciais de proxy
Quando a configuração de rede estiver pronta, use os detalhes de conexão fornecidos no seu painel do CyberYozh App. Uma conexão de proxy típica inclui:
Host
Porta
Nome de usuário
Senha
Protocolo
A configuração exata pode variar dependendo do produto de proxy e das configurações de localização, sessão ou IP que você selecionou.
Mantenha essas credenciais no ambiente de execução em vez de expô-las ao próprio modelo de linguagem.
Passo 5. Conecte o proxy à ferramenta que faz a solicitação
Configure o proxy onde o agente realmente acessa a web.
Por exemplo:
LLM → lógica do agente → Playwright → proxy CyberYozh App → site
Se o Playwright controla o navegador, configure o proxy no Playwright. O mesmo princípio se aplica ao Puppeteer, Selenium, Scrapy, Postman, um cliente HTTP ou outro ambiente de automação.
O guia de configuração do Playwright do CyberYozh App mostra um exemplo prático de conexão.
Regra de configuração: Siga a solicitação. O componente que a envia para a web é geralmente onde o proxy deve estar.
Passo 6. Verifique a conexão antes de executar o agente
Não presuma que o proxy está funcionando apenas porque as credenciais foram adicionadas com sucesso.
Use o verificador de IP do CyberYozh App para confirmar o IP de saída e a localização esperada. Para um fluxo de trabalho estático ou sticky, verifique se a rota permanece consistente conforme o esperado. Se a rotação faz parte da configuração, verifique se o comportamento do IP corresponde à sua configuração.
Só então entregue o fluxo de trabalho ao agente.
Passo 7. Adicione controle de API quando o fluxo de trabalho precisar
Para fluxos de trabalho de IA maiores, o gerenciamento de proxy pode eventualmente precisar se tornar parte da própria automação, em vez de algo configurado manualmente antes de cada execução.
Quando compatível com o produto de proxy, controles baseados em API podem ser incorporados ao pipeline de automação mais amplo. Para um agente mais simples, no entanto, não há razão para adicionar outra camada de lógica se uma conexão de proxy padrão já faz o trabalho.
Pronto para conectar seu fluxo de trabalho de IA? Escolha um proxy do CyberYozh App com base na localização, comportamento de sessão, protocolo e requisitos de rede do seu agente.
Proxies de IA para web scraping e coleta de dados
A IA tornou os fluxos de trabalho de scraping mais flexíveis, mas não removeu os problemas normais de engenharia relacionados à coleta de dados.
O agente ainda precisa buscar a página antes que um LLM possa classificar, extrair, resumir ou raciocinar sobre seu conteúdo.
Essa etapa de rede é importante.
Um proxy de web scraping pode ajudar a distribuir solicitações de dados públicos e separar a infraestrutura de scraping da máquina que executa o agente.
Mas o proxy deve estar dentro de um sistema mais amplo que lida com:
Ritmo de solicitações
Novas tentativas
Validação
Detecção de duplicatas
Falhas de parser
Gerenciamento de sessão
Tratamento de erros
Conformidade com regras e permissões aplicáveis
O proxy não substitui esses componentes.
Para fluxos de trabalho maiores, o CyberYozh App stack de web scraping fornece a camada de rede junto com integrações existentes de scraping e automação.
Erros comuns com proxies de IA
A maioria das configurações ruins de proxy de IA são surpreendentemente comuns. Geralmente são erros de arquitetura ou configuração, e não algum problema misterioso de IA.
Rotacionar todas as solicitações
A rotação não é automaticamente melhor.
Se um agente está fazendo milhares de solicitações independentes, a rotação pode se adequar à carga de trabalho. Se ele precisa de continuidade em uma jornada de navegador de várias etapas, mudar o IP no meio do caminho pode dificultar a manutenção da sessão.
Combine a rotação com a estrutura da tarefa em vez de habilitá-la por padrão.
Usar proxies residenciais para tudo
O roteamento residencial é útil quando a carga de trabalho realmente precisa dele.
Alguns trabalhos de desenvolvimento, tarefas de monitoramento, verificações técnicas e fluxos de automação funcionam perfeitamente bem através de infraestrutura de datacenter. Da mesma forma, proxies móveis só fazem sentido quando uma rota de rede de operadora é relevante.
O fato de um fluxo de trabalho usar IA não significa automaticamente que ele precisa do tipo de proxy mais complexo disponível.
Fornecer credenciais de proxy ao modelo
O modelo geralmente não precisa ver seu nome de usuário, senha ou credenciais de API do proxy.
Mantenha os segredos no ambiente de execução e deixe o Playwright, Puppeteer, Selenium, Scrapy ou Postman usar a conexão de proxy configurada. O modelo pode direcionar o fluxo de trabalho sem ter acesso às credenciais por trás dele.
Configurar o proxy no lugar errado
Um proxy precisa ser configurado no componente que realmente faz a solicitação web de saída.
Se o Playwright controla o navegador, por exemplo, adicionar informações de proxy em algum lugar na configuração do LLM não roteia automaticamente o tráfego do Playwright através dele.
Siga a solicitação através da arquitetura e configure o proxy onde essa solicitação sai do sistema.
Esquecer de verificar o IP de saída
Uma configuração de proxy que existe no seu código não é necessariamente uma configuração de proxy que funciona.
Verifique o IP de saída e a localização esperada antes de a tarefa começar. Caso contrário, você pode acabar depurando prompts, lógica do agente ou comportamento do navegador quando o problema é simplesmente uma conexão mal configurada.
Repetir ações com falha cegamente
Uma solicitação de rede com falha não deve automaticamente fazer com que um agente autônomo repita todas as ações.
Primeiro identifique se a falha veio da autenticação, da rota do proxy, do destino, da sessão ou da ferramenta. A referência de erros de proxy do CyberYozh App pode ajudar a distinguir falhas comuns de rede e proxy.
Para sistemas de longa duração, também faz mais sentido pensar sobre o ciclo de vida do proxy completo em vez de substituir IPs aleatoriamente sempre que algo falha.