Como configurar proxies no Playwright para web scraping
Playwright é um framework moderno de web scraping e automação que suporta múltiplas linguagens de programação e se integra bem com proxies CyberYozh para segurança adicional e estabilidade de sessão. Aqui, aprenda como configurar o Playwright e garantir que seu trabalho seja bem executado.
Preparação: Selecionando um proxy para usar com Playwright
Antes de configurar uma integração de proxy Playwright, você deve construir a infraestrutura de scraping/automação adequada. Seu tipo de proxy determina o nível de confiança, estabilidade de sessão, velocidade e como as plataformas percebem seu tráfego.
Proxy móvel: Dados sociais, geotargeting preciso e Google SERP
Proxies móveis possuem a taxa de confiança absolutamente mais alta entre todos os tipos de proxy. Eles são a escolha obrigatória para extração de dados de redes sociais como Instagram, TikToke Snapchat. Você também pode implantar infraestrutura móvel LTE/5G para scraping de Google SERP multi-thread e ininterrupto. As operadoras móveis utilizam tecnologia CGNAT, ocultando milhares de usuários reais de smartphones por trás de um único endereço IP. O Google não pode bloquear esses nós sem desconectar bairros inteiros. Essa arquitetura concede tráfego ilimitado para escalar seus parsers infinitamente sem pagar por gigabyte.
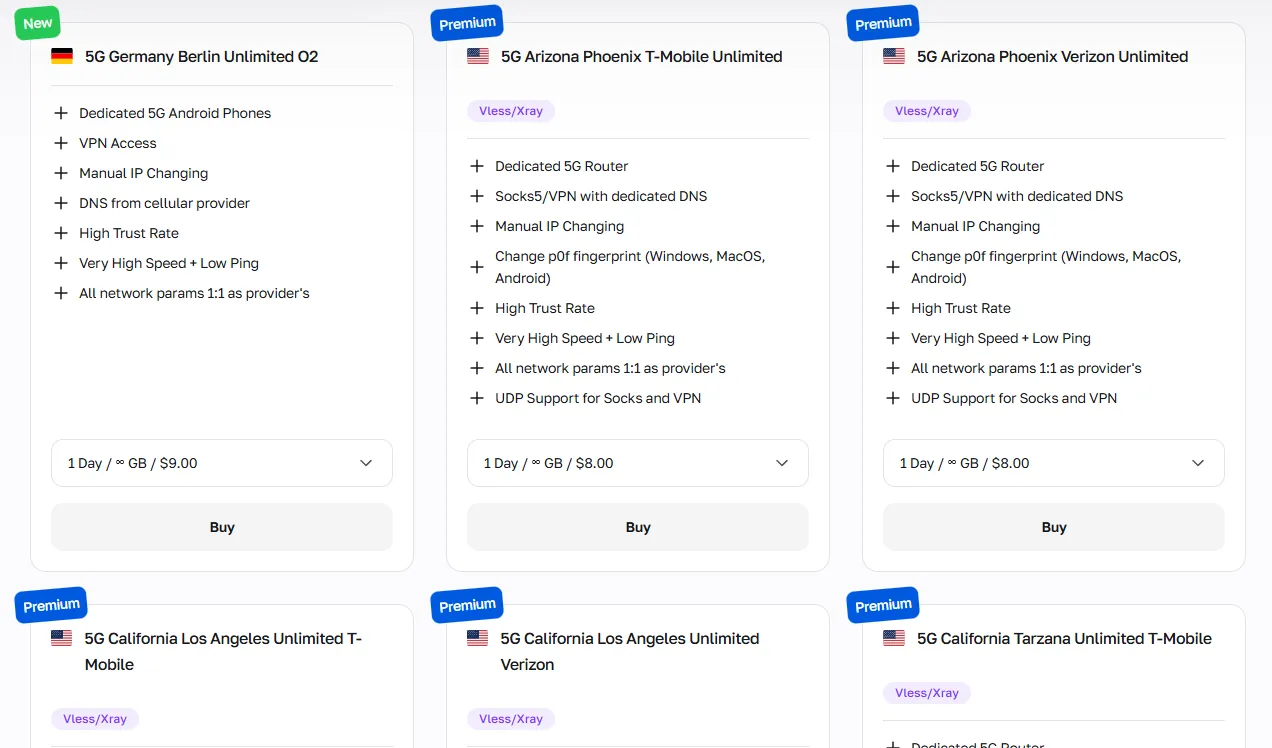
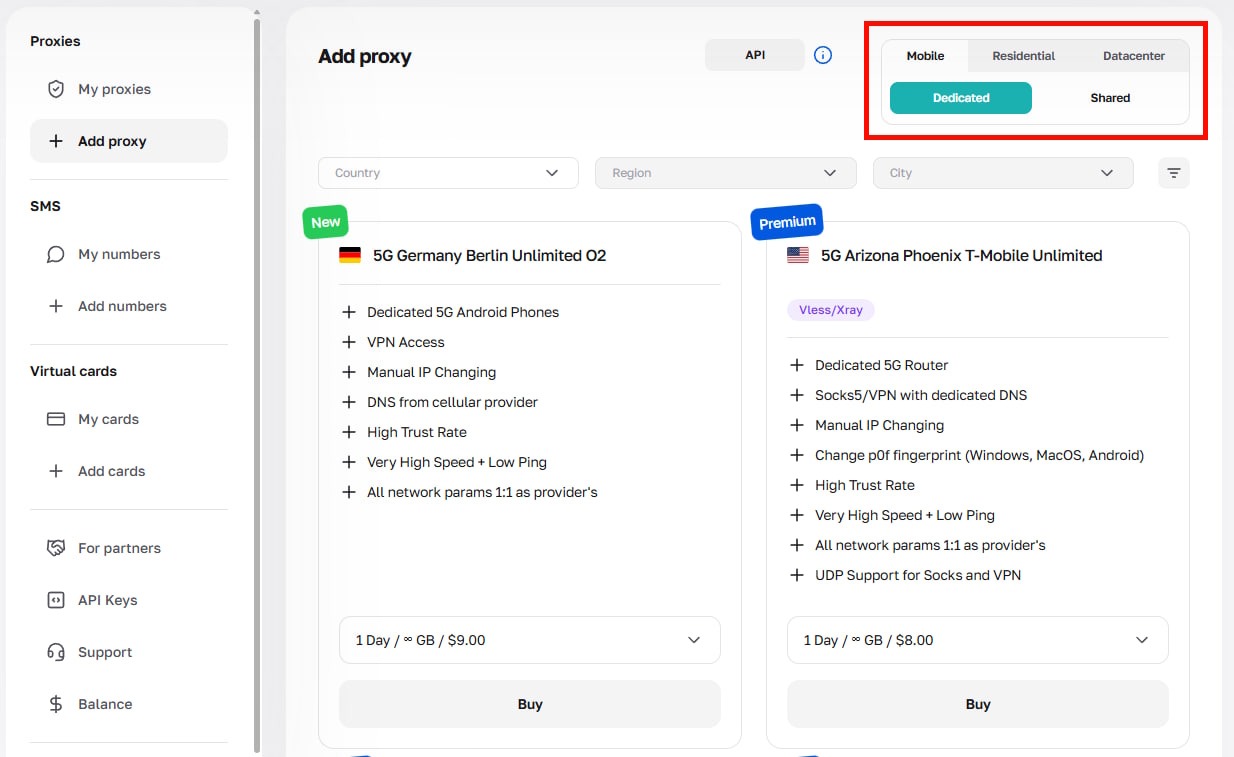
Os proxies móveis CyberYozh oferecem alta personalização para geotargeting preciso, configurações de fingerprint e tráfego ilimitado; ideal quando você precisa que o Playwright emule um usuário móvel real.
Proxy residencial: Scraping geral de dados e automação
Proxies residenciais são divididos em dois tipos com base no seu caso de uso:
Proxies residenciais estáticos fornecem um IP residencial fixo de um país específico, percebido pelas plataformas como um usuário comum de Internet doméstica. Eles são ideais para fluxos de trabalho vinculados a contas.
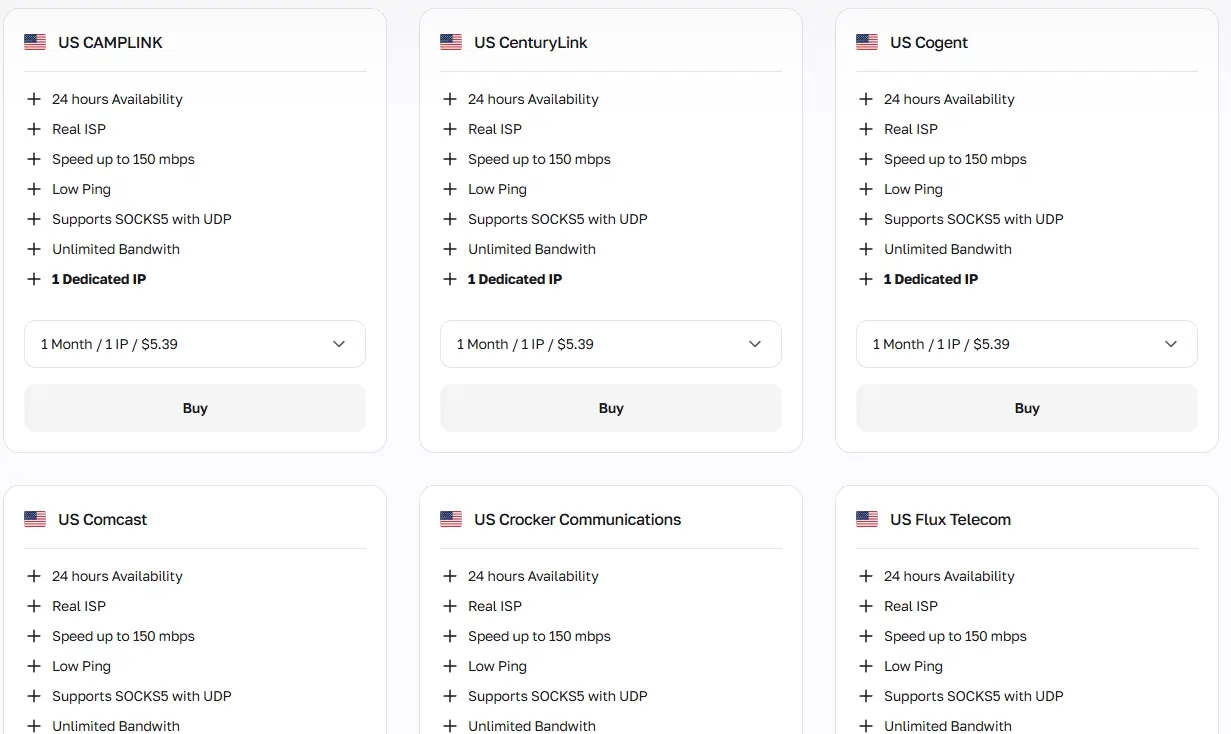
Proxies residenciais rotativos aproveitam uma infraestrutura de mais de 100 milhões de IPs em mais de 195 países. Você pode rotacionar endereços a cada requisição ou manter sessões fixas por até 24 horas. Eles formam a base necessária para automação em massa, web scraping em larga escala e fornecimento de contexto de rede estável para agentes de IA modernos como Crawl4AI e Open Scraper.
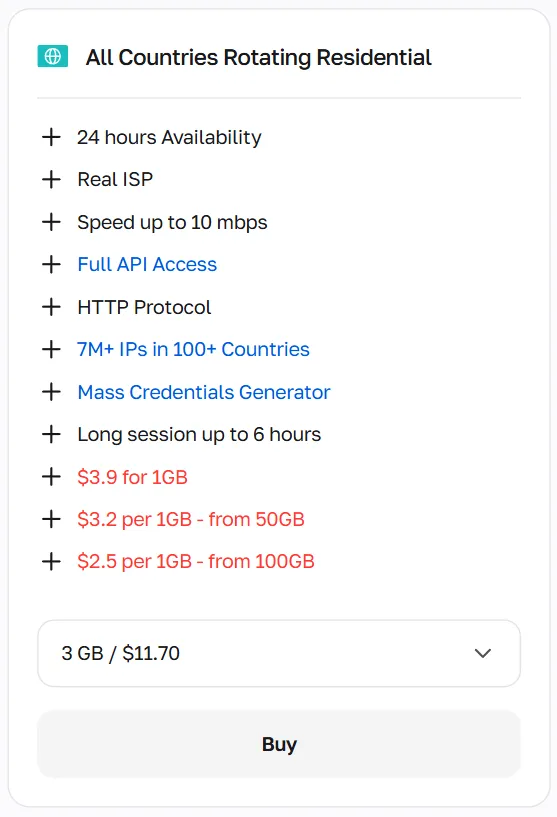
Selecione IPs residenciais estáticos para gerenciamento de contas de longo prazo, com o esquema de 1 IP = 1 conta, enquanto IPs rotativos são necessários para todas as atividades web em massa, com uma estratégia de rotação de IP adequada baseada em cada caso de uso específico.
Proxies de datacenter: Bancos de dados abertos e testes de aplicativos
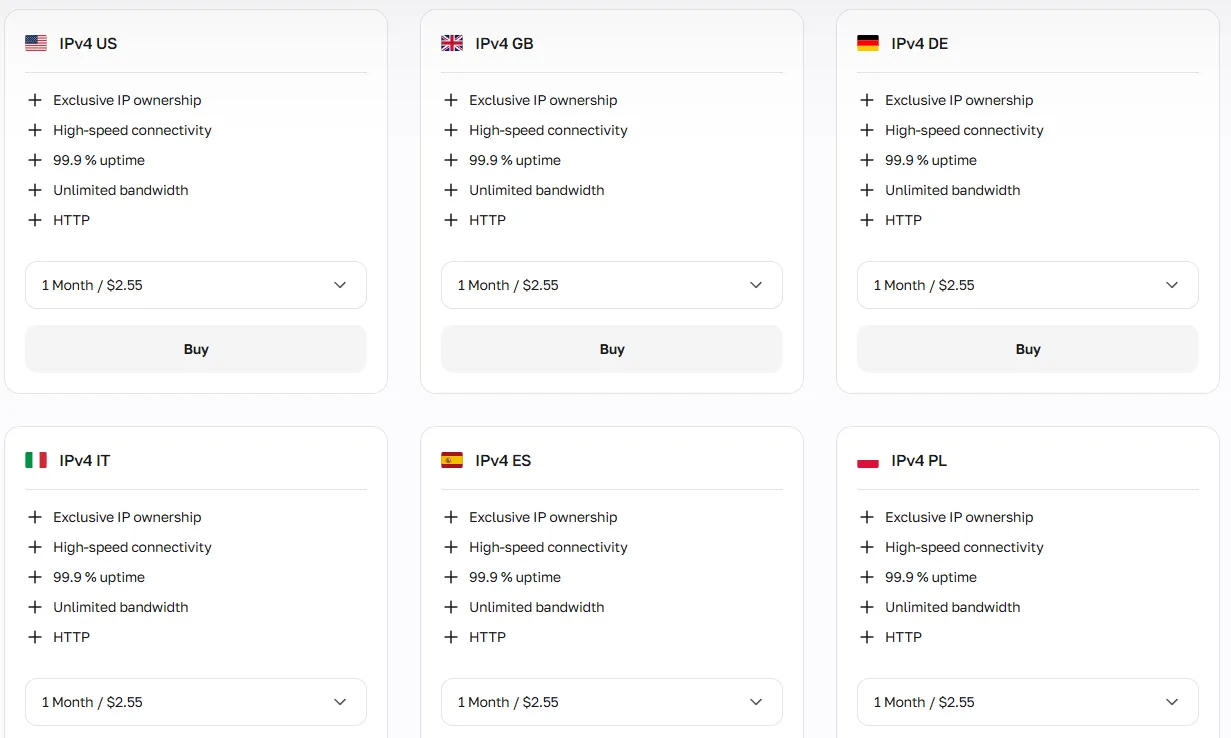
Proxies de datacenter fornecem a velocidade de conexão mais rápida, mas são associados a tráfego não residencial, semelhante a bots. Eles funcionam bem para scraping de bancos de dados abertos, testes de APIs e tarefas de alta velocidade onde as plataformas aplicam detecção mínima de bots, mas podem ser rapidamente restritos em plataformas sociais como Reddit ou LinkedIn.
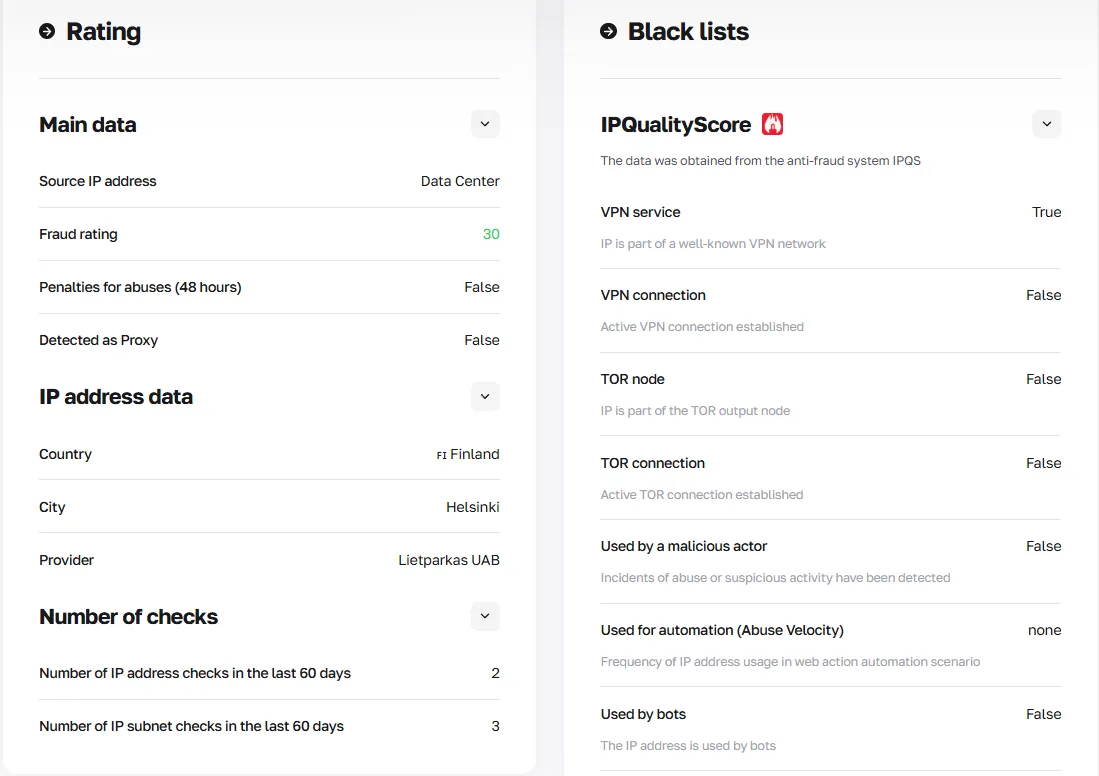
Ferramenta adicional: Avaliação de Risco Antes da Execução
A CyberYozh oferece um IP Checker que verifica cada endereço IP em relação aos principais bancos de dados de fraude para retornar um Fraud Score rigoroso e histórico completo. Implemente um pipeline de "Avaliação de Risco Antes da Execução". Execute seu IP através do verificador antes de iniciar a instância do navegador. Isso avalia seu nível de risco real e ajuda a manter uma alta taxa de sucesso operacional, substituindo completamente falsas garantias de "à prova de banimento".
Obtenha acesso à CyberYozh API para automatizar a rotação de IP e verificar cada endereço IP recebido antes de rotacionar, garantindo sua qualidade.
Começando com a instalação do Playwright: Selecionando uma linguagem
O Playwright suporta quatro linguagens. Antes de começar sua instalação do Playwright e configuração de proxy, escolha a linguagem que se adequa à sua stack. Este guia usa Python, como a escolha mais comumente usada para fluxos de trabalho com proxy, mas todas as quatro opções são cobertas na tabela e instruções curtas abaixo.
Linguagem | Principais Diferenças | Casos de Uso Principais | Quando Escolher |
Node.js (JS/TS) | Linguagem padrão do Playwright; suporte TypeScript nativo; maior comunidade e documentação | Testes end-to-end, automação de navegador, CI/CD frontend | Sua equipe trabalha com JS/TS, ou você precisa das ferramentas mais maduras |
Python | Mais amplamente usado em scraping/ML; async via asyncio; integra com Requests, Scrapy | Web scraping, pipelines de dados, automação de proxy, coleta de dados ML | Você precisa de scraping intensivo com proxy ou integração com ciência de dados |
.NET (C#) | Distribuição NuGet; tipagem forte, bom para QA empresarial | Automação de testes empresariais, aplicações .NET | Sua organização usa stack .NET |
Java | Distribuição Maven/Gradle; integração JUnit | Aplicações empresariais Java, testes relacionados a Android | Seu projeto é baseado em Java ou requer ecossistema JVM |
Node.js
A linguagem padrão e mais completamente documentada do Playwright. TypeScript é suportado nativamente: o Playwright é instalado usando npm, sem necessidade de configuração extra.
npm init playwright@latestPython
A linguagem preferida para tarefas de proxy Playwright, scraping e automação de dados. Requer Python 3.8+ e geralmente é instalado via PyPI (pip).
pip install playwright

playwright install
.NET (C#)
Distribuído como pacote NuGet. Requer PowerShell (pwsh) para executar a etapa de instalação do navegador.
dotnet new console -n PlaywrightDemo

cd PlaywrightDemo

dotnet add package Microsoft.Playwright

dotnet build

pwsh bin/Debug/netX/playwright.ps1 install
Java
Distribuído como módulo Maven (mvn). Adicione a dependência ao seu pom.xml no Maven, e os navegadores serão baixados automaticamente na primeira compilação.
<dependency>

  <groupId>com.microsoft.playwright</groupId>

  <artifactId>playwright</artifactId>

  <version>1.59.0</version>

</dependency>
E então execute um comando:
mvn compile exec:java -D exec.mainClass="org.example.App"Configurando um proxy Playwright com Python
Aqui, vamos explorar a implantação generalizada de sessão de scraping Playwright com proxies CyberYozh. Embora a linguagem padrão do Playwright seja Node.js/TypeScript, usaremos Python em nosso exemplo, já que Playwright com Python é amplamente usado para automação web, scraping e outras tarefas relacionadas a proxy. Se você precisar usar TypeScript ou tiver um caso de uso específico que exija C# ou Java, basta explorar a versão correspondente da documentação do Playwright; é bastante fácil ajustar o código.
Um servidor proxy Playwright é um intermediário de rede que retransmite as solicitações do seu navegador através de um endereço IP diferente. O Playwright passa a configuração do proxy diretamente no lançamento do navegador ou no nível de contexto, roteando todo o tráfego através do servidor especificado.
1. Obtenha um proxy para sua tarefa
Faça login na sua conta CyberYozh, navegue até Meus Proxiese selecione o tipo de proxy adequado para sua tarefa (móvel, residencial estático, residencial rotativo, datacenter).
Após a compra, abra o cartão do proxy, clique em Gerar Credenciais, escolha seu modo de rotação (IP Aleatório, Sessão Curta ou Sessão Longa) e navegue até o host, porta, nome de usuário e senha.
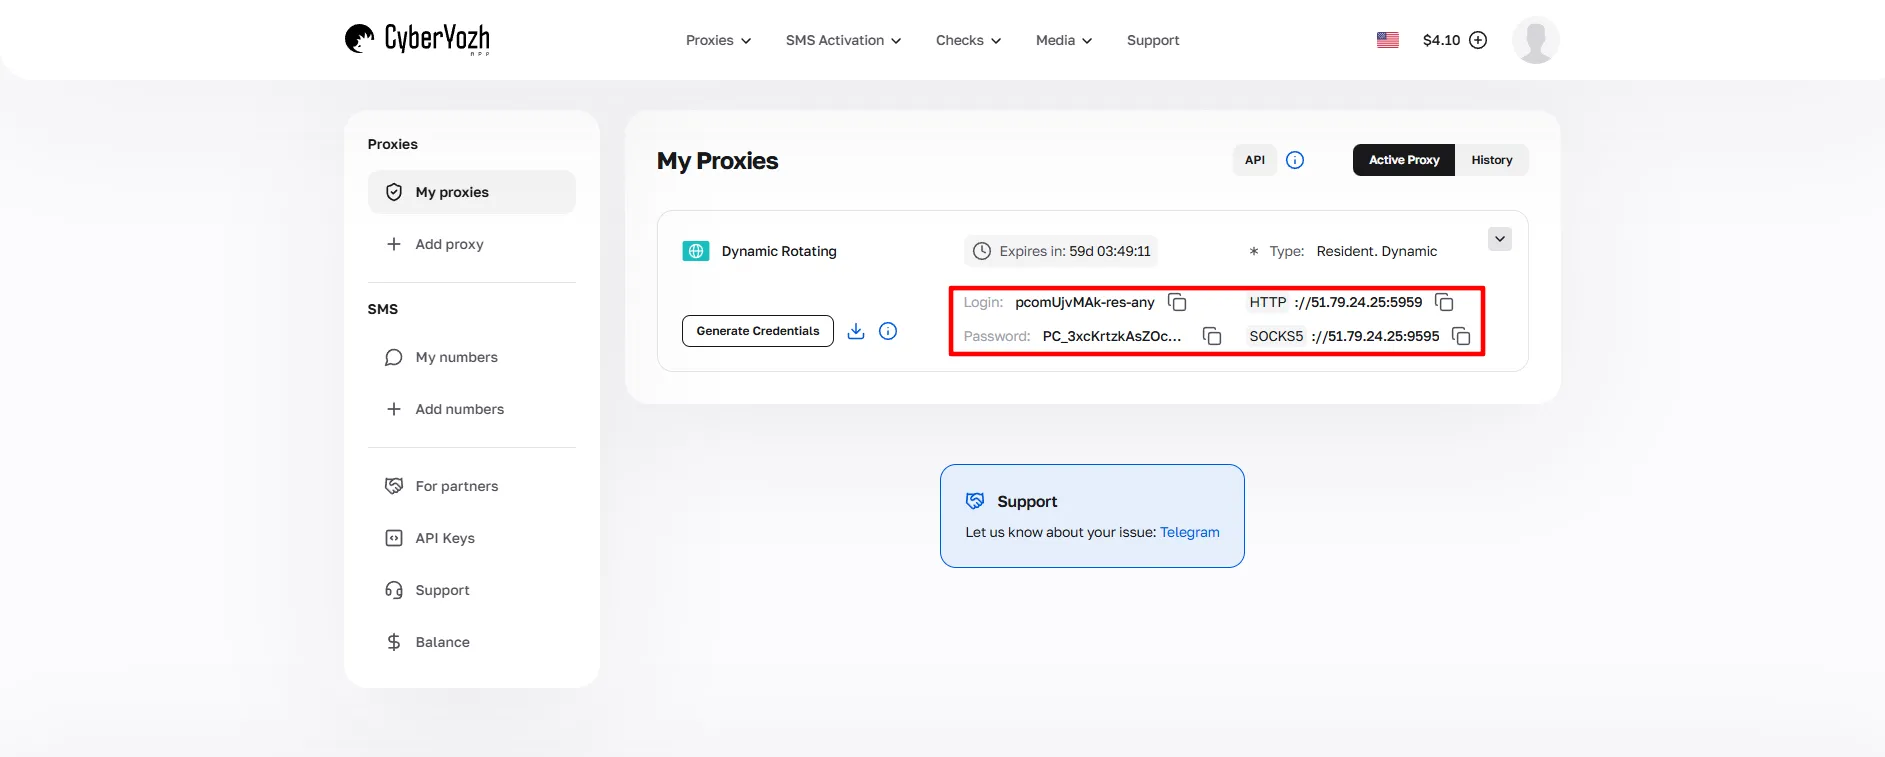
Essas credenciais serão usadas durante toda a configuração.
2. Baixe e instale o Playwright
Instale a biblioteca Playwright e seus binários de navegador via PyPI:
pip install playwright

playwright install
Isso baixa os binários Chromium, Firefox e WebKit. Para scraping, Chromium é a escolha padrão.
3. Organize uma estrutura de projeto
Crie uma pasta de projeto dedicada (por exemplo, scraper/). Mantenha as credenciais separadas do seu código e defina um caminho de saída claro para os dados coletados:
-documento .env para credenciais de proxy (sempre adicione ao .gitignore)
-scraper.py como o script principal do Playwright
-requirements.txt para dependências
output/ pasta para dados coletados (CSV/JSON)
4. Adicione a configuração de proxy no arquivo .env
Abra seu arquivo .env no VS Code ou em qualquer editor e copie e cole suas credenciais CyberYozh. Sempre adicione .env ao seu .gitignore para evitar vazamento de credenciais para repositórios de controle de versão.
HTTP_PROXY=http://username:password@proxy-server-ip:host
SOCKS5_PROXY=socks5://username:password@proxy-server-ip:host
Para uma configuração de proxy SOCKS5 Playwright, use o esquema socks5://. Para uso padrão de proxy HTTP Playwright, use o esquema http://. Certifique-se de incluir as portas corretas do painel CyberYozh. Se você usar a API CyberYozh, sua chave de API também deve ser especificada aqui.
CYBERYOZH_API_KEY=Your_API_URL_Key5. Criar um script de scraping/automação
Crie o arquivo de teste Python usando Playwright. Ele deve ter aproximadamente a seguinte estrutura:
Criação de entidades de navegador e contexto com configurações de proxy
Configuração de rotação automatizada e verificação de IP via API do CyberYozh
Acessar o site de destino e realizar scraping via biblioteca Requests
Configurar tratamento de erros
Especificar a pasta de saída para dados extraídos
O script abaixo implementa a configuração completa de proxy do Playwright em Python: uma entidade de navegador, uma entidade de contexto com autenticação de proxy do Playwright, rotação automatizada de IP via API do CyberYozh, execução de requisições, tratamento de erros e saída de arquivo.
Visite a documentação da API do CyberYozh para explorar exatamente como você pode implementar os comandos da API para uso automatizado do serviço CyberYozh
import asyncio
import os
import json
import requests
from dotenv import load_dotenv
from playwright.async_api import async_playwright

load_dotenv()

PROXY_URL = os.getenv("HTTP_PROXY")  # or SOCKS5, from the .env document
CYBERYOZH_API_KEY = os.getenv("CYBERYOZH_API_KEY") # API key from the .env document
TARGET_URL = "https://httpbin.org/ip" # the website to scrape; here is the test one
OUTPUT_FILE = "output/results.json" # output folder


def check_ip_quality(ip: str) -> bool:

    """Use CyberYozh IP Checker API to verify trust score before rotating."""

    try:

        response = requests.get(
            f"https://app.cyberyozh.com/api/v1/checkers/socks/",
            headers={"Authorization": f"Bearer {CYBERYOZH_API_KEY}"},
            timeout=5
        )

        score = response.json().get("fraud_score", 100)
        return score < 50  # Accept IPs with fraud score below 50

    except Exception:

        return True  # Allow on API error


async def scrape(proxy_url: str) -> dict:

    """Run a single Playwright scraping session with proxy."""

    # Parse proxy credentials for Playwright proxy authentication

    from urllib.parse import urlparse

    parsed = urlparse(proxy_url)

    proxy_config = {
        "server": f"{parsed.scheme}://{parsed.hostname}:{parsed.port}",
        "username": parsed.username,
        "password": parsed.password,
    }


    async with async_playwright() as p:

        # Browser entity (headless to save traffic): launch with proxy server

        browser = await p.chromium.launch(headless=True)
        # Context entity: proxy settings applied per context

        context = await browser.new_context(proxy=proxy_config)
        page = await context.new_page()


        try:

            await page.goto(TARGET_URL, timeout=30000)
            content = await page.inner_text("body")
            result = json.loads(content)
            return {"status": "ok", "ip": result.get("origin")}

        except Exception as e:

            return {"status": "error", "error": str(e)}

        finally:

            await context.close()
            await browser.close()


async def main():

    results = []

    for i in range(5):

        print(f"Request {i+1}: using proxy {PROXY_URL}")
        data = await scrape(PROXY_URL)
        print(f"  → IP: {data.get('ip')} | Status: {data.get('status')}")
        results.append(data)

    os.makedirs("output", exist_ok=True)

    with open(OUTPUT_FILE, "w") as f:

        json.dump(results, f, indent=2)

    print(f"Results saved to {OUTPUT_FILE}")


asyncio.run(main())Veja também o guia relacionado: Configurando Rotação de Proxy em Python.
6. Executar o teste e rotacionar o proxy
Inicie o scraper a partir da raiz do seu projeto:
python scraper.pyVerifique se cada requisição registra um endereço IP diferente (confirmando que a rotação está ativa) e se o arquivo output/results.json está preenchido. Use a API do CyberYozh para rotação automatizada e verificações de qualidade automatizadas via IP Checker: proxies com uma pontuação de fraude alta serão rejeitados antes do próximo ciclo de rotação.
Veja também: Guia de Automação de Web Scraping
Resumo: Usando Playwright com infraestrutura CyberYozh
Com os proxies do Playwright configurados e as credenciais do CyberYozh ativas, você pode executar scraping multi-alvo, automação com geotargeting e fluxos de trabalho de gerenciamento de contas em escala, roteando cada sessão do navegador através de IPs residenciais ou móveis limpos com validação de pontuação de fraude, enquanto gera dados estruturados no formato de sua escolha.