
Proxy para web scraping
Extraia dados de produtos, SERPs, preços e outros dados da web em grande escala com 99,95% de sucesso operacional, sem deixar que bloqueios de IP ou restrições geográficas atrasem seu fluxo de trabalho. Mais de 100 milhões de IPs residenciais, proxies móveis LTE/5G reais e proxies de datacenter em mais de 195 países para as tarefas mais exigentes.
Melhor proxy para web scraping
Escolha os melhores proxies para fazer scraping de qualquer plataforma e volume com mais de 100 milhões de IPs de proxies residenciais, móveis 4G/5G reais e de datacenter. Verifique a qualidade do IP e o fraud score antes de começar para que nenhum IP ruim interrompa o seu scraper no meio da tarefa.
Colete dados locais em qualquer país
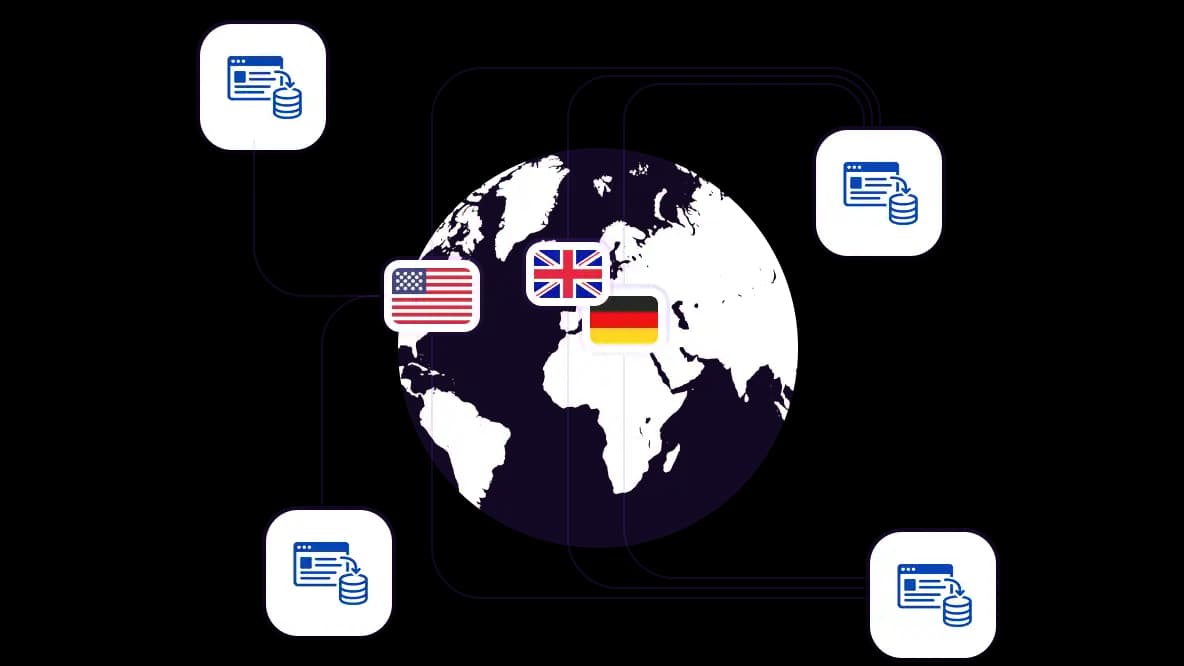
Colete preços, SERPs, listagens de produtos e outros dados dependentes de localização com cobertura de proxy em mais de 195 países e segmentação granular no nível de cidade e código postal. Obtenha resultados precisos sem incompatibilidades de localização.
Automatize e execute scraping com menos interrupções
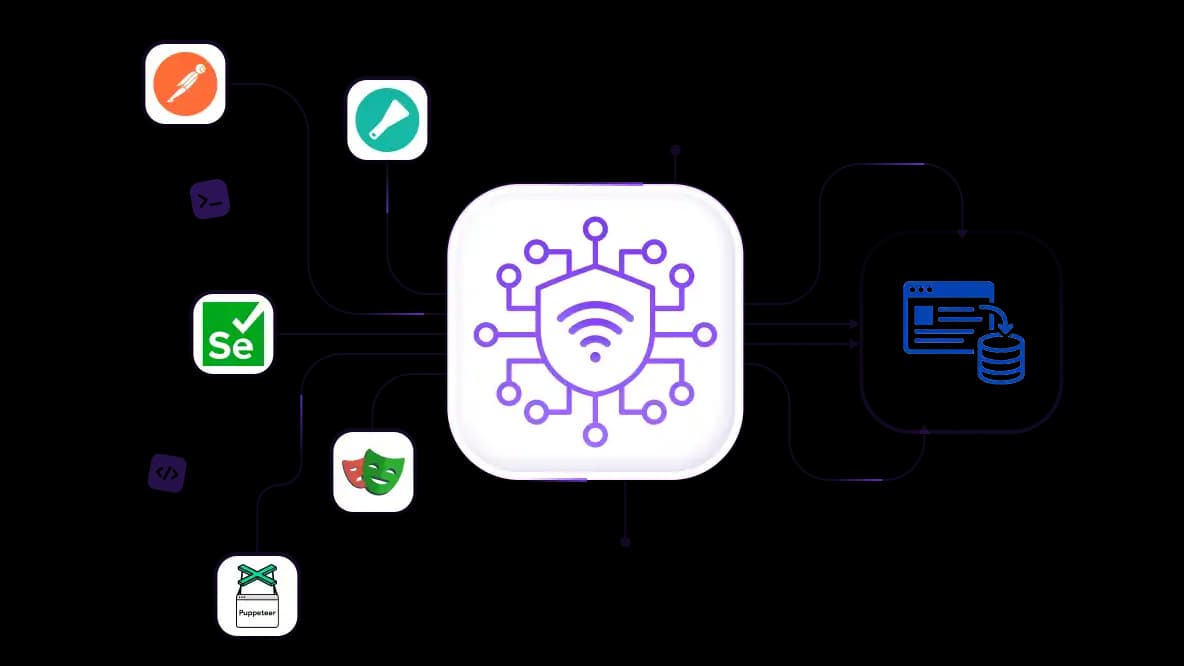
Conecte proxies ao Playwright, Scrapy, Selenium, Puppeteer, Postman ou ferramentas personalizadas através da API do CyberYozh App. A rotação flexível de IP e o controle de sessões ajudam a reduzir interrupções de CAPTCHA, limites de taxa e bloqueios à medida que você escala a coleta.
Dimensione a coleta de dados com tráfego ilimitado
A CyberYozh oferece largura de banda ilimitada em proxies móveis e de data centers, para que você possa rastrear catálogos extensos, monitorar preços continuamente ou coletar páginas com muitas imagens sem se preocupar com cada gigabyte adicionando outra cobrança.
Combine seu proxy com a impressão digital do seu navegador
A troca de impressão digital do sistema operacional ajuda a alinhar os ambientes do navegador e do proxy, reduzindo sinais conflitantes de sistema operacional e IP que podem acionar verificações. Combine os proxies da CyberYozh com qualquer navegador antidetecção para manter o local do proxy, o fuso horário e o perfil do navegador alinhados em todas as sessões de scraping.
Especialmente para você
Melhores proxies por países

Web scraping - móvel dedicado ilimitado
-
Roteador 5G dedicado
-
Socks5/VPN com DNS dedicado
-
Troca manual de IP
-
Alteração da impressão digital p0f (Windows, macOS, Android)
-
Alto nível de confiança
-
Velocidade muito alta + baixa latência
-
Todos os parâmetros de rede 1:1 como os do provedor
Web scraping - móvel compartilhado
-
Roteador 5G compartilhado
-
Suporte a SOCKS5 com UDP
-
Até 5 usuários por porta
-
Socks5 / HTTP
-
Rotação de IP: a cada 30 minutos
-
Impressão digital p0f do Windows
-
Alto nível de confiança
-
Velocidade muito alta + baixa latência
-
Todos os parâmetros de rede 1:1 como os do provedor
Web scraping - residenciais rotativos
-
Disponibilidade 24 horas
-
ISP real
-
Velocidade de até 10 Mbps
-
Acesso completo à API
-
Protocolo HTTP
-
Mais de 100M de IPs em mais de 100 países
-
Gerador massivo de credenciais
-
Sessão longa de até 6 horas
Web scraping - residenciais privados
-
Largura de banda ilimitada
-
ISP real
-
Velocidade de até 150 Mbps
-
Baixa latência
-
Suporte a SOCKS5 com UDP
-
Disponibilidade 24 horas
-
1 IP dedicado
Web scraping - datacenter dedicados
-
Largura de banda ilimitada
-
Propriedade exclusiva de IP
-
Conectividade de alta velocidade
-
Uptime de 99.9 %
-
HTTP
Web scraping - datacenter compartilhados
-
Velocidades ultrarrápidas
-
Cobertura global de IP
-
Uptime de 99.9 %
-
Planos econômicos
-
1 GB de largura de banda
-
HTTP
Por que eles compram de nós?
Vantagens
Pagamento com cartão privado
Não importa como você recarregou seu saldo, vincular o pagamento ao aluguel de um proxy específico é impossível.
Não armazenamos dados em servidores.
Como regra, os serviços que alugam proxies retêm todos os dados sobre o tráfego que passa por seus servidores.
Dispositivo dedicado
Nós NÃO disfarçamos proxies compartilhados como individuais. Um modem ou roteador é transferido para APENAS uma pessoa.
Suporte técnico online
Estamos sempre prontos para resolver seus problemas e dúvidas. Mesmo tarde da noite e cedo pela manhã.
Garantia de devolução do dinheiro
Temos tanto devoluções quanto trocas. A prioridade é um serviço de qualidade e clientes satisfeitos.
API para Negócios
Para clientes empresariais, nosso serviço está pronto para fornecer uma API conveniente que permite comprar proxies, trocar endereços IP e muito mais.
Por que você precisa de um proxy para scraping
O scraping em larga escala falha rapidamente quando você envia milhares de requisições do mesmo IP. As plataformas respondem com throttling, CAPTCHAs, bloqueios ou servindo discretamente conteúdo diferente do que um visitante em outro país veria. Sem proxies:
Banimentos de IP: um endereço fazendo requisições repetidas é facilmente restringido.
Limites de taxa: crawls de alto volume sofrem throttling antes que o conjunto de dados esteja completo.
Restrições geográficas: preços, listagens e resultados de busca mudam por país e cidade, então uma única localização fornece dados incompletos ou enganosos.
Pontos únicos de falha: um IP sinalizado paralisa todo o trabalho.
Sinais incompatíveis: mesmo um IP limpo dispara CAPTCHAs e erros 403 se a impressão digital do seu navegador, fuso horário ou idioma não corresponder à conexão.
Os proxies residenciais da CyberYozh são projetados para suportar scraping de alto volume. Com mais de 100 milhões de IPs residenciais em mais de 195 países, além de IPs móveis ilimitados e de datacenter. A alternância de impressão digital do SO ajuda a alinhar os sinais do seu navegador com o IP que você está usando para que você não escale até bloqueios.
Escolha o melhor proxy para scraping no catálogo da CyberYozh
Como os proxies de web scraping beneficiam seus fluxos de trabalho profissionais
Extração de dados de ecommerce e monitoramento de preços
Amazon, eBay e AliExpress variam preços e estoque por região, e aplicam throttling em IPs que solicitam milhares de páginas de produtos. Proxies de datacenter cobrem páginas de catálogo menos restritivas, enquanto proxies residenciais rotativos com segmentação em nível de cidade lidam com páginas de produtos e avaliações protegidas.
Resultado: Você obtém catálogos completos e preços precisos por localização em vez de lacunas de requisições bloqueadas.
Scraping de SERP
O Google e o Bing fornecem resultados diferentes por localização e sinalizam consultas repetidas do mesmo IP ou servem CAPTCHAs. Use proxies residenciais rotativos para rankings de desktop e proxies de operadoras móveis para resultados móveis, que frequentemente diferem do desktop.
Resultado: Seus dados de ranking agora correspondem ao que os pesquisadores em cada mercado veem em cada dispositivo.
Saiba mais sobre os casos de uso de proxy para web scraping
Coleta de dados de redes sociais
Instagram, TikToke Facebook sinalizam rapidamente faixas de datacenter e vinculam sessões estreitamente ao IP. Proxies móveis em redes de operadoras reais carregam a maior confiança, e proxies residenciais estáticos mantêm uma identidade consistente para coleta com login.
Resultado: Você coleta perfis públicos, postagens e dados de engajamento com menos desafios ou sessões interrompidas.
Coleta de dados para treinamento de IA
Conjuntos de dados construídos a partir de portais de notícias, Reddit, sites de documentação e páginas de produtos exigem milhões de requisições, e bloqueios deixam lacunas e viés regional no corpus. Proxies se encaixam em monitoramento de preços com IA e coleta de dados para treinamento de IAtambém. Proxies de datacenter cobrem fontes abertas de forma econômica, enquanto proxies residenciais rotativos lidam com as protegidas.
Resultado: Você obtém cobertura mais ampla e uniforme entre fontes e países, faturada por GB, então você paga apenas pelo tráfego que usa.
Experimente o Yozh Scraper hoje
Yozh Scraper é o scraper Playwright gratuito e de código aberto da CyberYozh. Ele se conecta aos proxies residenciais rotativos da CyberYozh, então você obtém a ferramenta de extração e os IPs de uma única fonte.
Gratuito e de código aberto — scraper + crawler completo, auto-hospedável, sem cobrança por requisição
10 presets prontos — Amazon, eBay, Walmart, Google e mais
Integração MCP — conecte diretamente ao Claude, Cursor ou qualquer cliente MCP
Qual é o melhor tipo de proxy para cada tarefa de web scraping
O proxy certo para web scraping depende da plataforma, volume de requisições, localização e requisitos de sessão. Proxies de datacenter funcionam bem para coleta rápida de fontes menos restritivas, enquanto proxies residenciais e móveis se adequam a alvos onde reputação de IP, localização ou estabilidade de sessão importam.
Tipo de proxy | Melhor para | Por que usar |
Proxies de datacenter | Catálogos públicos, documentação, APIs abertas | Rápido e econômico para alvos com restrições de IP mais leves |
Proxies residenciais rotativos | Amazon, eBay, Google, SERPs, monitoramento de preços | Rotacione IPs e segmente localizações específicas quando o volume de scraping ou a reputação do IP são importantes |
Painéis de vendedores, contas logadas, sessões de longa duração | Mantenha um IP residencial estável durante fluxos de scraping de múltiplas etapas | |
Proxies móveis | Instagram, TikTok, SERPs móveis, dados específicos de operadoras | Roteie requisições através de redes de operadoras móveis reais quando os alvos tratam o tráfego móvel de forma diferente |
Sessões rotativas vs fixas para web scraping: quando escolher cada uma
Sessões rotativas fornecem um novo IP a cada requisição. São a opção padrão ideal para tarefas independentes — verificações de preços, consultas de SERP, listagens de produtos — onde o volume importa e não há nada a perder ao trocar endereços entre requisições.
Sessões fixas mantêm o mesmo IP por uma janela definida, de 5 minutos a algumas horas. Recorra a elas quando a continuidade importa: logins, carrinhos, fluxos de múltiplas etapas, qualquer situação em que mudar de endereço no meio da tarefa quebraria a sessão.
A regra prática: rotacione para volume, fixe para estado. A maioria das operações reais usa ambos — rotativo na web aberta, fixo dentro de qualquer coisa que se comporte como uma sessão de usuário.
CyberYozh suporta ambos os modos, com sessões fixas disponíveis por até 24 horas e rotação manual e baseada em API. Ajuste a rotação de proxy para sua tarefa em vez de comprometer em todos os lugares.
Leia nosso guia para automação de web scraping
Como configurar um proxy de scraping
1. Escolha seu tipo de proxy. Residencial ou móvel para alvos protegidos; datacenter para sites rápidos e menos restritivos.
2. Obtenha suas credenciais. Host, porta, nome de usuário, senha e seu modo de rotação escolhido — por requisição ou fixo.
3. Configure seu scraper. Direcione as requisições através do endpoint do proxy antes de fazer uma única chamada.
4. Verifique o IP de saída. Verifique o IP e a localização retornados para confirmar que o tráfego está sendo roteado através do proxy.
5. Configure a rotação para corresponder ao alvo. Rotacione requisições independentes; use sessões fixas quando o fluxo de trabalho depende do mesmo IP. Ajuste se o alvo começar a retornar 403s ou CAPTCHAs.
Como configurar no Playwright:
PROXY = {

    "server": "http://gate.cyberyozh.net:10000",

    "username": "user123-us-s-session1",

    "password": "your_password"

}

with sync_playwright() as p:

    browser = p.chromium.launch(proxy=PROXY)

    page = browser.new_page()

    page.goto("https://api.ipify.org")

    print(page.inner_text("body"))

browser.close()Alternando navegadores no Playwright
O Playwright suporta múltiplos motores de navegador. Alterne do Chromium para Firefox ou WebKit alterando exatamente uma linha de código. Combine o motor aos requisitos do seu site-alvo.
# For Firefox

browser = p.firefox.launch(proxy=PROXY)

# For WebKit (Safari engine)

browser = p.webkit.launch(proxy=PROXY)
Configure, verifique a conexão e deixe a infraestrutura de proxy gerenciar o roteamento.
Por que usar o CyberYozh para web scraping
O CyberYozh fornece a infraestrutura de proxy para executar trabalhos de scraping em diferentes alvos, localizações e volumes de requisições sem criar configurações de proxy separadas para cada fluxo de trabalho. Escolha o tipo de IP, localização e comportamento de sessão que se adequa ao alvo.
100M+ IPs residenciais em 195+ países
Proxies móveis LTE/5G reais com largura de banda ilimitada
Proxies de datacenter para scraping rápido e econômico
Números virtuais para SMS e cartões virtuais em uma única plataforma
Sessões fixas + rotativas para diferentes requisitos de fluxo de trabalho
Verificações de pontuação de IP/fraude para avaliar a qualidade do IP antes do uso
Integrações de API com Scrapy, Selenium, Playwright, Postman e scripts personalizados.
O que nossos clientes dizem no Trustpilot
Comece a fazer scraping com os proxies do CyberYozh
Construa seu scraper em torno de uma infraestrutura de proxy que pode lidar com o alvo, volume e localizações que seu fluxo de trabalho exige. Escolha entre proxies residenciais, móveis e de datacenter e conecte-se através das ferramentas que você já usa.
Com 100M+ IPs residenciais em 195+ países, o CyberYozh oferece a cobertura de IP e controle de sessão para escalar a coleta de dados sem reconstruir sua configuração de scraping.
Escolha seu proxy e comece a fazer scraping
Recarregue seu saldo de qualquer forma conveniente!
Cartões bancários


Criptomoeda


