AI proxy: Cómo los proxies respaldan a los agentes de IA
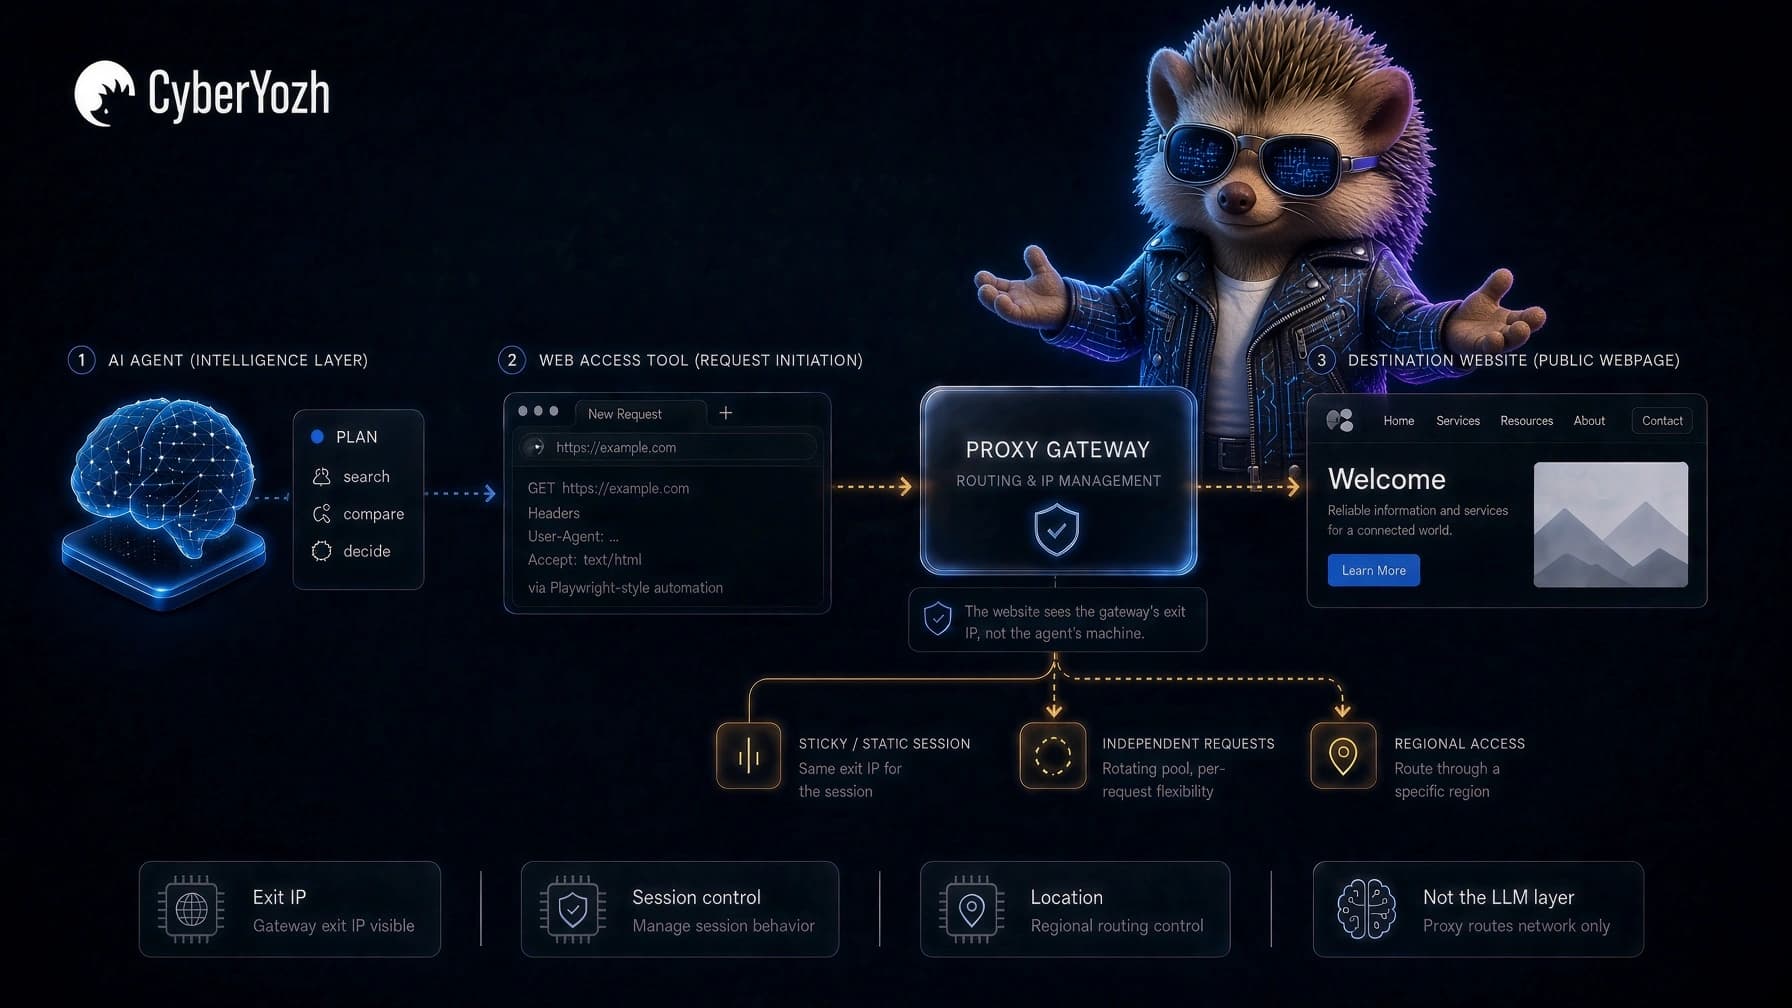
Un agente de IA puede planificar una tarea, elegir una herramienta, abrir un navegador, buscar en un sitio web, comparar resultados y decidir qué hacer a continuación. Pero en el momento en que llega a la web, algo muy ordinario sucede: realiza una solicitud de red.
Esa solicitud todavía proviene de una dirección IP y tiene una ubicación, una ruta de red y una sesión detrás de ella. Dependiendo de la tarea, el agente puede necesitar mantener esa IP durante todo un recorrido de navegador, acceder a la web desde una ubicación particular o distribuir miles de solicitudes independientes a través de un pool de IPs rotativas.
Ahí es donde entra un proxy de IA.
Para agentes de navegador, agentes de scraping, herramientas de investigación y otras automatizaciones conectadas a la web, un proxy de IA controla la ruta de red entre la herramienta de acceso web del agente y su destino. Puede determinar el tipo y ubicación de IP, cuánto tiempo permanece una IP con una sesión y cuándo el tráfico se mueve a través de un pool más grande.
CyberYozh App proporciona esa capa de red a través de proxies para agentes de IA, infraestructura de agentes de navegador, proxies residenciales, rutas móviles, IPs de datacenter e integraciones con herramientas de automatización comunes.
La IA sigue haciendo el razonamiento. El proxy maneja cómo esa IA llega a la web.
Resumen
Un proxy de IA puede significar dos cosas diferentes: un proxy de red que controla cómo un agente de IA llega a la web, o un gateway de IA/proxy LLM que gestiona solicitudes entre una aplicación y proveedores de modelos.
Para agentes conectados a la web, el proxy se sitúa entre el navegador o cliente HTTP y el destino, controlando la IP de salida, ubicación, tipo de red, comportamiento de sesión y rotación.
Los proxies de IA pueden soportar agentes de navegador, web scraping de IA, RAG y recuperación web, investigación, localización y QA, y monitoreo cuando la ruta de red importa para la tarea.
Elige el proxy según la carga de trabajo: ISP estático para sesiones estables más largas, residencial sticky para continuidad temporal, residencial rotativo para solicitudes independientes, móvil cuando importa el enrutamiento de operador, y datacenter cuando una infraestructura más simple es suficiente.
Configura el proxy en la herramienta que realmente accede a la web, como Playwright, Puppeteer, Selenium, Scrapy o Postman, en lugar de en el modelo de lenguaje en sí.
La rotación no es automáticamente mejor. Mantén la ruta estable cuando las solicitudes pertenecen a la misma sesión y rota cuando la carga de trabajo consiste en solicitudes independientes.
Un proxy maneja la capa de red solamente. No asegura prompts, gestiona el estado del navegador, corrige la lógica de extracción, controla permisos de agentes ni hace más seguras las decisiones del modelo.
Con CyberYozh App, la configuración práctica consiste en elegir la ubicación y el comportamiento de sesión correctos, configurar la conexión en la herramienta de acceso web, verificar la IP de salida y añadir control basado en API solo cuando el flujo de trabajo lo necesite.
¿Qué es un proxy de IA?
Un proxy de IA es un intermediario utilizado dentro de un flujo de trabajo de IA para enrutar conexiones entre diferentes partes del sistema. Lo que realmente conecta depende de qué tipo de proxy de IA te refieras: un proxy de red para agentes de IA que controla cómo un agente de IA accede a la web, o un gateway de IA o proxy LLM que gestiona cómo una aplicación se comunica con los proveedores de modelos.
Se sitúan en diferentes capas del stack de IA y resuelven problemas diferentes.
Un proxy de red para agentes de IA
Esto es de lo que hablamos principalmente en este artículo.
El flujo se ve algo así:
Agente de IA → navegador o cliente HTTP → proxy → sitio web
El proxy de IA controla la conexión de red entre la herramienta del agente y el destino.
Esto puede cambiar:
La dirección IP visible
La ubicación geográfica de la conexión
El tipo de red, como residencial, móvil, ISP o datacenter
Cuánto tiempo permanece la misma IP vinculada a una sesión
Cómo se distribuyen las solicitudes a través de un pool de IP
Obtén el CyberYozh App proxy para agentes de IA.
Un gateway de IA o proxy LLM
Un gateway de IA se sitúa en otro lugar.
Su flujo se ve más así:
Aplicación → gateway de IA → proveedor de modelo
Puede centralizar el enrutamiento de modelos, registro, reintentos, controles de tasa, selección de proveedores y funciones similares a nivel de API. Cloudflare, por ejemplo, describe su AI Gateway como una capa para observar y controlar solicitudes de modelos con características que incluyen registro, almacenamiento en caché, limitación de tasa, reintentos y respaldo. Documentación de Cloudflare AI Gateway
Esa es una infraestructura útil, pero no es lo mismo que darle a un agente de navegador una IP residencial.
Consejo profesional: Un gateway de IA controla cómo tu aplicación accede al modelo. Un proxy de IA de red controla cómo el agente accede a la web. Ambos pueden existir en el mismo sistema.
Proxy de red para agentes de IA | |
Se sitúa entre | El navegador/cliente del agente y el sitio web |
Controla | IP, ubicación, tipo de red, sesiones persistentes, rotación |
Uso típico | Agentes de navegador, web scraping, investigación, pruebas regionales |
Flujo de ejemplo | Agente → proxy → sitio web |
¿CyberYozh App proporciona esto? | Sí |
¿Cómo funciona un proxy de IA?
Un proxy de IA de red funciona entre la herramienta que un agente de IA utiliza para acceder a la web y el sitio web o servicio al que necesita llegar. En lugar de conectarse directamente desde la máquina que ejecuta el agente, la solicitud pasa primero por un servidor proxy.
La ruta básica se ve así:
Agente de IA → navegador o cliente HTTP → servidor proxy → sitio web
Cuando el navegador, scraper o cliente HTTP envía una solicitud, el proxy la recibe y la reenvía al destino utilizando una IP de salida de su red. El sitio web ve esa IP de salida en lugar de la IP de la máquina que ejecuta el agente. La respuesta luego regresa a través del proxy a la herramienta de acceso web del agente.
Lo que sucede con la IP en el camino depende de la configuración del proxy. El agente podría mantener la misma IP durante toda una sesión de navegador de varios pasos, usar una IP persistente durante un período determinado o extraer diferentes IPs de salida de un pool rotativo para solicitudes independientes. La ubicación también se puede seleccionar cuando el flujo de trabajo necesita acceso web desde un país o región en particular.
Por qué los agentes de IA usan proxies cuando acceden a la web
Si un agente de IA permanece dentro de tu base de datos o software interno, es posible que no necesite un proxy en absoluto.
El proxy se vuelve relevante cuando el agente comienza a interactuar con sitios web y servicios externos.
Piensa en un agente de investigación que tiene que abrir cientos de páginas públicas de productos. O un agente de QA que prueba un sitio web desde varios países. O un agente de navegador que necesita permanecer dentro de la misma sesión mientras se mueve a través de un flujo de trabajo de cinco pasos.
Esos trabajos tienen requisitos de red muy diferentes.
Los agentes de navegador de IA necesitan una ruta consistente
Un agente de navegador podría buscar, hacer clic, navegar, comparar información, tomar capturas de pantalla, completar formularios aprobados o interactuar con aplicaciones web.
Si el flujo de trabajo dura varios minutos, cambiar la IP a mitad de camino puede ser innecesario o activamente contraproducente.
Para este tipo de trabajo, la ruta de red generalmente debería ser predecible.
El entorno del navegador sigue siendo una capa separada. Las cookies, el almacenamiento, los encabezados, las sesiones y la seguridad del navegador no desaparecen simplemente porque la IP cambie.
Un proxy maneja la identidad de red. No reemplaza un buen diseño de agente de navegador.
Los agentes de investigación de IA pueden necesitar control de ubicación
Imagina un agente de IA comparando resultados de búsqueda públicos, precios, disponibilidad o páginas localizadas en varios países.
Ejecutar cada solicitud desde una ubicación en la nube puede darle al agente una imagen muy incompleta.
Un proxy permite que el agente realice solicitudes a través de una ruta en la región que se está probando.
Eso no cambia la identidad del usuario ni la elegibilidad para un servicio. Simplemente cambia la ubicación de red utilizada para la solicitud.
Los agentes de scraping de IA pueden necesitar varias IPs
La recopilación de datos públicos a gran escala tiene una forma diferente.
Es posible que al agente no le importe mantener una identidad de navegador durante una hora. Puede estar obteniendo muchas páginas independientes, validando respuestas, extrayendo información estructurada y avanzando.
Ahí es donde el web scraping de IA y la infraestructura de proxies rotativos se vuelven más útiles.
El scraper aún necesita lógica de reintentos, análisis sintáctico, deduplicación, validación y un ritmo de solicitudes sensato. El proxy solo resuelve la parte de enrutamiento de red de ese sistema.
El proxy es infraestructura, no inteligencia. Puede mejorar cómo un agente alcanza un recurso, pero no puede corregir una lógica de extracción deficiente o una mala decisión tomada por el modelo.
Casos de uso de proxies de IA
Los proxies de IA se vuelven útiles cuando un sistema de IA necesita interactuar con la web pública y la ruta de red importa para la tarea. El papel exacto del proxy depende de lo que el agente esté intentando recuperar, probar, monitorear o automatizar.
Caso de uso | Qué está haciendo la IA | Qué añade el proxy |
Agentes de navegador | Navegar sitios web y completar tareas de varios pasos | Sesiones estables y control sobre la ubicación de red |
Web scraping de IA | Recopilar datos públicos de muchas páginas | Acceso a pools de IPs rotativas para solicitudes independientes |
RAG y recuperación web | Obtener contenido web actual antes de pasarlo a un LLM | Acceso distribuido y consciente de la ubicación a páginas de origen |
Agentes de investigación | Comparar información pública entre sitios web o mercados | Enrutamiento de IP regional para resultados localizados |
Localización y QA | Probar cómo se comporta un sitio o aplicación desde diferentes regiones | Acceso desde IPs en las ubicaciones que se están probando |
Agentes de monitoreo | Verificar páginas públicas repetidamente en busca de cambios | Rutas consistentes o distribuidas según el trabajo de monitoreo |
RAG y recuperación web
La generación aumentada por recuperación se vuelve particularmente relevante cuando la información que un sistema de IA necesita no está ya disponible en su modelo o base de conocimiento interna.
Un flujo de trabajo RAG puede recuperar información de bases de datos, APIs, documentos o la web antes de suministrar material relevante al modelo. Cuando la fuente de recuperación es un sitio web público, el componente de acceso web aún tiene que realizar solicitudes de red ordinarias.
Un proxy puede controlar la IP y la ubicación utilizadas para esas solicitudes. Esto resulta útil cuando el sistema de recuperación recopila información pública de diferentes regiones o distribuye una carga de trabajo de recuperación mayor a través de múltiples rutas.
El proxy no realiza la recuperación ni mejora el razonamiento del modelo. Proporciona la capa de red utilizada para alcanzar las fuentes de las cuales el sistema RAG recupera información.
Segmentación geográfica y QA impulsado por IA
Los agentes de IA también pueden automatizar partes de las pruebas regionales de sitios web y aplicaciones. Un agente podría verificar páginas localizadas, resultados de búsqueda, disponibilidad de productos, variaciones de idioma u otro contenido que puede diferir según el lugar de origen de una solicitud.
Enrutar el agente a través de un proxy en la ubicación que se está probando permite que el flujo de trabajo de QA observe la web desde esa ubicación de red en lugar de depender completamente del servidor donde se ejecuta la automatización.
Obtén los proxies de geotargeting de CyberYozh App para aparecer como un usuario local genuino en cualquier país, ciudad o red de operador.
Agentes de monitoreo
Los agentes de monitoreo verifican repetidamente recursos públicos en busca de cambios, como información de productos, disponibilidad, resultados de búsqueda, datos de mercado o actualizaciones de sitios web.
Un agente que verifica repetidamente el mismo recurso puede funcionar perfectamente bien con una ruta consistente, mientras que un sistema de monitoreo más grande que cubre muchas fuentes independientes puede beneficiarse de distribuir solicitudes a través de un pool de IPs.
Al igual que con otros casos de uso de proxies de IA, la estrategia de red debe seguir la carga de trabajo en lugar de aplicar rotación simplemente porque está disponible.
¿Qué tipo de proxy de IA deberías usar?
No existe un único proxy mejor para cada agente de IA.
La mejor opción depende de lo que el agente esté haciendo una vez que abandona tu infraestructura y alcanza la web pública.
Carga de trabajo de IA | Proxy a considerar | Por qué |
Tarea de navegador de múltiples pasos | ISP estático | Mantiene una IP consistente |
Sesión de navegador residencial | Residencial sticky | Mantiene una ruta residencial durante la sesión |
Carga de trabajo de datos públicos grande | Residencial rotativo | Distribuye solicitudes independientes |
Gateway rotativo automatizado | Proxy backconnect | Proporciona al cliente un gateway mientras las salidas rotan |
Pruebas de red móvil | Móvil | Utiliza infraestructura LTE/5G |
Automatización directa | Datacenter | Simple y rentable donde el enrutamiento residencial es innecesario |
Proxies ISP estáticos para sesiones largas de agentes de IA
Un agente de larga duración a menudo se beneficia de una ruta estable.
Por ejemplo, si un agente abre un sitio web, navega por varias páginas, elige opciones y luego devuelve un resultado, mantener una IP durante todo el recorrido es más fácil de razonar.
Los proxies ISP estáticos de CyberYozh App proporcionan a ese flujo de trabajo una dirección persistente respaldada por ISP.
Esto suele ser más apropiado que rotar la IP simplemente porque la rotación está disponible.
Proxies residenciales sticky para continuidad temporal
A veces quieres enrutamiento residencial sin mantener la misma IP indefinidamente.
Una sesión sticky permite que varias solicitudes relacionadas compartan una salida durante un período definido.
Esto puede funcionar bien cuando el agente necesita continuidad de sesión pero el sistema más amplio aún utiliza un pool residencial.
Proxies residenciales rotativos para solicitudes independientes
Si el agente está recopilando muchas páginas públicas no relacionadas, la rotación se vuelve más útil.
CyberYozh App proxies residenciales rotativos puede soportar cargas de trabajo donde diferentes solicitudes no necesitan compartir una identidad de red de larga duración.
Proxies backconnect para rotación automatizada
Un proxy backconnect proporciona a tu automatización una puerta de enlace proxy única mientras la infraestructura gestiona el cambio de IPs de salida detrás de ella.
Esto puede simplificar algunas arquitecturas de agentes porque el cliente no necesita mantener una enorme lista de direcciones proxy individuales.
Para automatización de alto volumen, esto suele ser más fácil de gestionar que alimentar nuevas IPs a la aplicación manualmente.
Proxies móviles para flujos de trabajo de red de operador
Los proxies móviles utilizan infraestructura de red móvil.
Tienen sentido para flujos de trabajo donde el enrutamiento LTE o 5G es realmente parte de lo que estás probando.
Esto podría incluir QA móvil, experiencias móviles regionales, o un agente cuya tarea depende específicamente de una ruta de red de operador.
No elijas móvil automáticamente porque suene más avanzado. Si la tarea no necesita una red móvil, otro tipo de proxy puede ser más simple.
Proxies de datacenter para automatización de IA más simple
Muchas tareas de automatización no necesitan características residenciales o móviles en absoluto.
Un proxy de datacenter puede ser una elección directa para comprobaciones técnicas, desarrollo, monitoreo, trabajo con datos abiertos y otros trabajos donde una IP de infraestructura normal es suficiente.
El proxy correcto es la red menos complicada que cumple con la tarea.
Cómo configurar un proxy de IA con CyberYozh App
Una vez que sabes qué ruta de red necesita tu agente de IA, la configuración se reduce a configurar la herramienta que utiliza para acceder a la web. Ya has elegido el tipo de proxy apropiado; ahora necesitas decidir cómo debe comportarse la conexión y conectarla a la capa de acceso web del agente.
Paso 1. Elige la ubicación
Si la geografía importa para la tarea, selecciona el país, región u otra opción de segmentación disponible que el agente necesite.
Esto puede importar para investigación de IA, recuperación web localizada, QA regional, monitoreo y otros flujos de trabajo donde el contenido devuelto por un sitio web puede variar dependiendo de la ubicación de la solicitud.
Si la geografía no importa, no hay razón para agregar un requisito de ubicación simplemente porque la opción existe.
Paso 2. Decide cómo debe comportarse la IP
A continuación, decide si el agente debe mantener su IP o cambiarla.
Un recorrido de navegador de múltiples pasos generalmente se beneficia de la continuidad. Para grandes conjuntos de solicitudes independientes, la rotación puede ser más apropiada. Una sesión sticky se sitúa entre ambas, manteniendo la misma IP de salida durante un período definido.
Lo importante es hacer que el comportamiento de la IP siga la tarea del agente en lugar de un temporizador arbitrario. Nuestra guía de rotación de proxies explica los diferentes enfoques con más detalle.
Paso 3. Elige el protocolo que admite tu cliente
El protocolo debe ser compatible con el navegador, framework de automatización, scraper o cliente HTTP que realiza la solicitud.
Elige según lo que el cliente y el flujo de trabajo realmente requieran, en lugar de tratar un protocolo como universalmente mejor. Si necesitas ayuda para decidir entre las opciones comunes.
Consulta nuestra comparación de proxies SOCKS5 vs HTTPS.
Paso 4. Obtén tus credenciales de proxy
Una vez que la configuración de red esté lista, utiliza los detalles de conexión proporcionados en tu panel de CyberYozh App. Una conexión de proxy típica incluye:
Host
Puerto
Nombre de usuario
Contraseña
Protocolo
La configuración exacta puede variar según el producto de proxy y la ubicación, sesión o configuración de IP que hayas seleccionado.
Mantén estas credenciales en el entorno de ejecución en lugar de exponerlas al modelo de lenguaje en sí.
Paso 5. Conecta el proxy a la herramienta que realiza la solicitud
Configura el proxy donde el agente realmente accede a la web.
Por ejemplo:
LLM → lógica del agente → Playwright → proxy de CyberYozh App → sitio web
Si Playwright controla el navegador, configura el proxy en Playwright. El mismo principio se aplica a Puppeteer, Selenium, Scrapy, Postman, un cliente HTTP o cualquier otro entorno de automatización.
La guía de configuración de Playwright de CyberYozh App muestra un ejemplo práctico de conexión.
Regla de configuración: Sigue la solicitud. El componente que la envía a la web es generalmente donde debe estar el proxy.
Paso 6. Verifica la conexión antes de ejecutar el agente
No asumas que el proxy está funcionando solo porque las credenciales se han agregado correctamente.
Utiliza el verificador de IP de CyberYozh App para confirmar la IP de salida y la ubicación esperada. Para un flujo de trabajo estático o sticky, verifica que la ruta permanezca consistente como se espera. Si la rotación es parte de la configuración, verifica que el comportamiento de la IP coincida con tu configuración.
Solo entonces entrega el flujo de trabajo al agente.
Paso 7. Agrega control de API cuando el flujo de trabajo lo necesite
Para flujos de trabajo de IA más grandes, la gestión de proxies puede eventualmente necesitar convertirse en parte de la automatización en sí, en lugar de algo configurado manualmente antes de cada ejecución.
Donde sea compatible con el producto de proxy, los controles basados en API pueden incorporarse al pipeline de automatización más amplio. Sin embargo, para un agente más simple, no hay razón para agregar otra capa de lógica si una conexión de proxy estándar ya hace el trabajo.
¿Listo para conectar tu flujo de trabajo de IA? Elige un proxy de CyberYozh App según la ubicación, el comportamiento de sesión, el protocolo y los requisitos de red de tu agente.
Proxies de IA para web scraping y recopilación de datos
La IA ha hecho que los flujos de trabajo de scraping sean más flexibles, pero no ha eliminado los problemas normales de ingeniería relacionados con la recopilación de datos.
El agente todavía tiene que obtener la página antes de que un LLM pueda clasificar, extraer, resumir o razonar sobre su contenido.
Ese paso de red es importante.
Un proxy de web scraping puede ayudar a distribuir solicitudes de datos públicos y separar la infraestructura de scraping de la máquina que ejecuta el agente.
Pero el proxy debe estar dentro de un sistema más amplio que gestione:
Ritmo de solicitudes
Reintentos
Validación
Detección de duplicados
Fallos del parser
Gestión de sesiones
Manejo de errores
Cumplimiento de las reglas y permisos aplicables
El proxy no reemplaza esas piezas.
Para flujos de trabajo más grandes, el stack de web scraping de CyberYozh App proporciona la capa de red junto con las integraciones existentes de scraping y automatización.
Errores comunes con proxies de IA
La mayoría de las configuraciones deficientes de proxies de IA son sorprendentemente ordinarias. Suelen ser errores de arquitectura o configuración en lugar de algún misterioso problema de IA.
Rotar cada solicitud
La rotación no es automáticamente mejor.
Si un agente está realizando miles de solicitudes independientes, la rotación puede ajustarse a la carga de trabajo. Si necesita continuidad a través de un recorrido de navegador de múltiples pasos, cambiar la IP a mitad de camino puede dificultar el mantenimiento de la sesión.
Ajusta la rotación a la estructura de la tarea en lugar de habilitarla por defecto.
Usar proxies residenciales para todo
El enrutamiento residencial es útil cuando la carga de trabajo realmente lo necesita.
Algunos trabajos de desarrollo, tareas de monitoreo, verificaciones técnicas y flujos de trabajo de automatización funcionan perfectamente bien a través de infraestructura de datacenter. Del mismo modo, los proxies móviles solo tienen sentido cuando una ruta de red de operador es relevante.
El hecho de que un flujo de trabajo use IA no significa automáticamente que necesite el tipo de proxy más complejo disponible.
Dar credenciales de proxy al modelo
El modelo generalmente no necesita ver tu nombre de usuario, contraseña o credenciales de API del proxy.
Mantén los secretos en el entorno de ejecución y deja que Playwright, Puppeteer, Selenium, Scrapy o Postman usen la conexión de proxy configurada. El modelo puede dirigir el flujo de trabajo sin tener acceso a las credenciales detrás de él.
Configurar el proxy en el lugar equivocado
Un proxy necesita configurarse en el componente que realmente realiza la solicitud web saliente.
Si Playwright controla el navegador, por ejemplo, agregar información de proxy en algún lugar de la configuración del LLM no enruta automáticamente el tráfico de Playwright a través de él.
Sigue la solicitud a través de la arquitectura y configura el proxy donde esa solicitud sale del sistema.
Olvidar verificar la IP de salida
Una configuración de proxy que existe en tu código no es necesariamente una configuración de proxy que funciona.
Verifica la IP de salida y la ubicación esperada antes de que comience la tarea. De lo contrario, puedes terminar depurando prompts, lógica del agente o comportamiento del navegador cuando el problema es simplemente una conexión mal configurada.
Reintentar acciones fallidas a ciegas
Una solicitud de red fallida no debería hacer que un agente autónomo repita automáticamente cada acción.
Primero identifica si el fallo provino de la autenticación, la ruta del proxy, el destino, la sesión o la herramienta. La referencia de errores de proxy de CyberYozh App puede ayudar a distinguir fallos comunes de red y proxy.
Para sistemas de larga duración, también tiene más sentido pensar en el ciclo de vida del proxy completo en lugar de reemplazar IPs aleatoriamente cada vez que algo falla.