Cómo configurar proxies en Playwright para web scraping
Playwright es un framework moderno de web scraping y automatización que soporta múltiples lenguajes de programación y se integra perfectamente con los proxies de CyberYozh para mayor seguridad y estabilidad de sesión. Aquí aprenderás cómo configurar Playwright y asegurarte de que tu trabajo se realice correctamente.
Preparación: Seleccionar un proxy para usar con Playwright
Antes de configurar la integración de un proxy con Playwright, debes construir la infraestructura de scraping/automatización adecuada. Tu tipo de proxy determina el nivel de confianza, la estabilidad de sesión, la velocidad y cómo las plataformas perciben tu tráfico.
Proxy móvil: Datos sociales, geotargeting preciso y Google SERP
Los proxies móviles tienen la tasa de confianza absolutamente más alta entre todos los tipos de proxy. Son la opción obligatoria para la extracción de datos de redes sociales como Instagram, TikToky Snapchat. También puedes implementar infraestructura móvil LTE/5G para scraping de Google SERP multihilo las 24 horas. Los operadores móviles utilizan tecnología CGNAT, ocultando miles de usuarios reales de smartphones detrás de una única dirección IP. Google no puede bloquear estos nodos sin desconectar barrios enteros. Esta arquitectura te otorga tráfico ilimitado para escalar tus parsers infinitamente sin pagar por gigabyte.
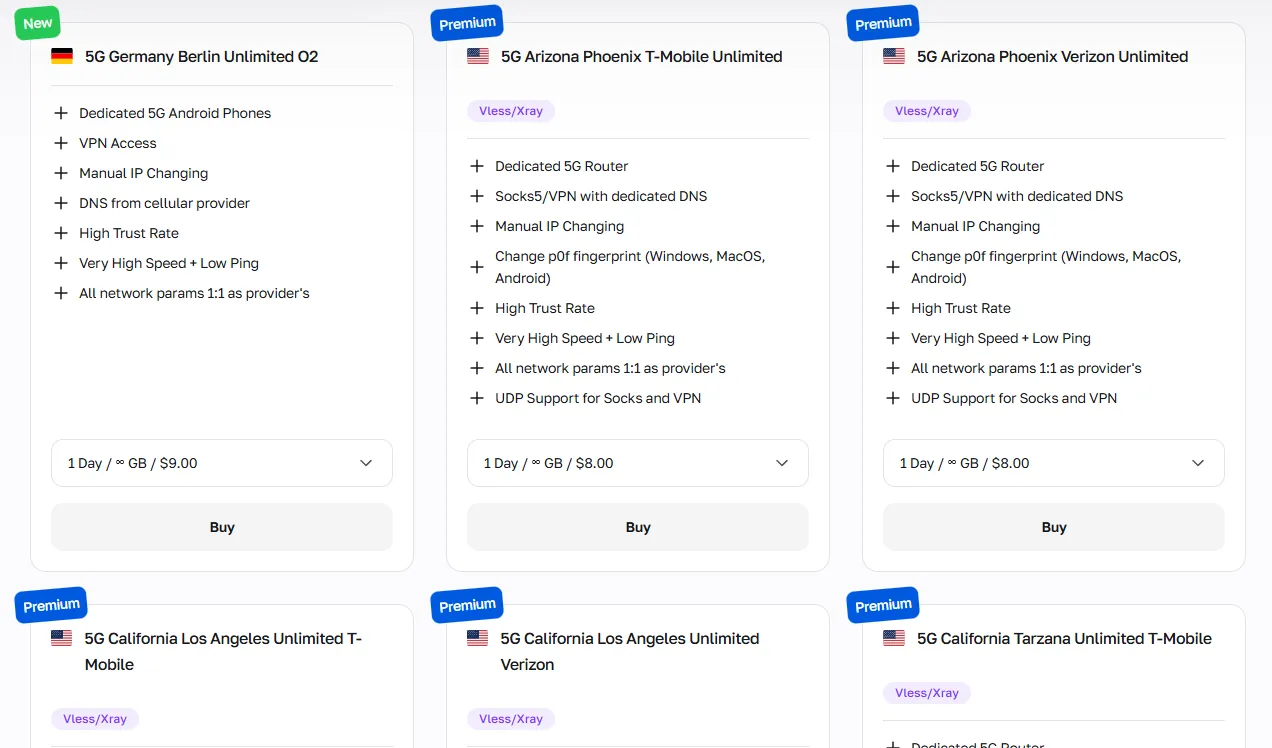
Los proxies móviles de CyberYozh ofrecen alta personalización para geotargeting preciso, configuración de fingerprints y tráfico ilimitado; ideales cuando necesitas que Playwright emule un usuario móvil real.
Proxy residencial: Scraping de datos general y automatización
Los proxies residenciales se dividen en dos tipos según tu caso de uso:
Los proxies residenciales estáticos proporcionan una IP residencial fija de un país específico, percibida por las plataformas como un usuario ordinario de Internet doméstico. Son ideales para flujos de trabajo vinculados a cuentas.
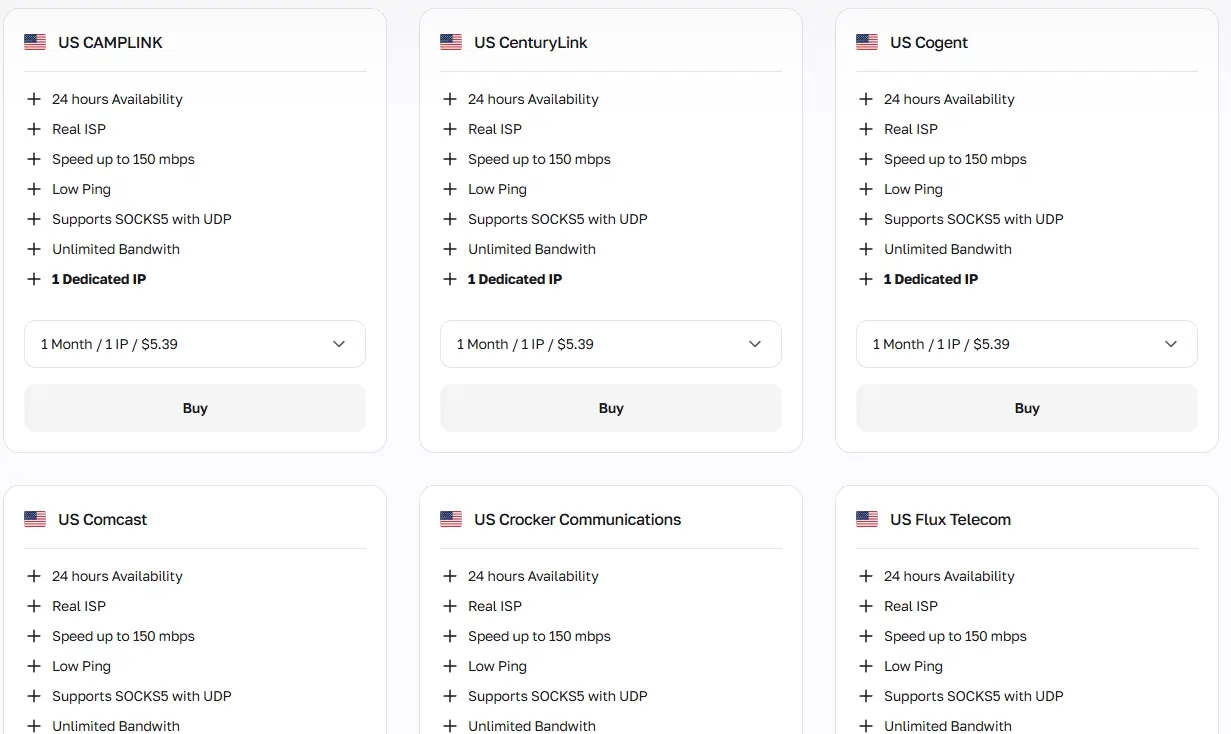
Los proxies residenciales rotativos aprovechan una infraestructura de más de 100M de IPs en más de 195 países. Puedes rotar direcciones en cada solicitud o mantener sesiones sticky hasta por 24 horas. Forman la base necesaria para automatización masiva, web scraping a gran escala y proporcionar contexto de red estable para agentes de IA modernos como Crawl4AI y Open Scraper.
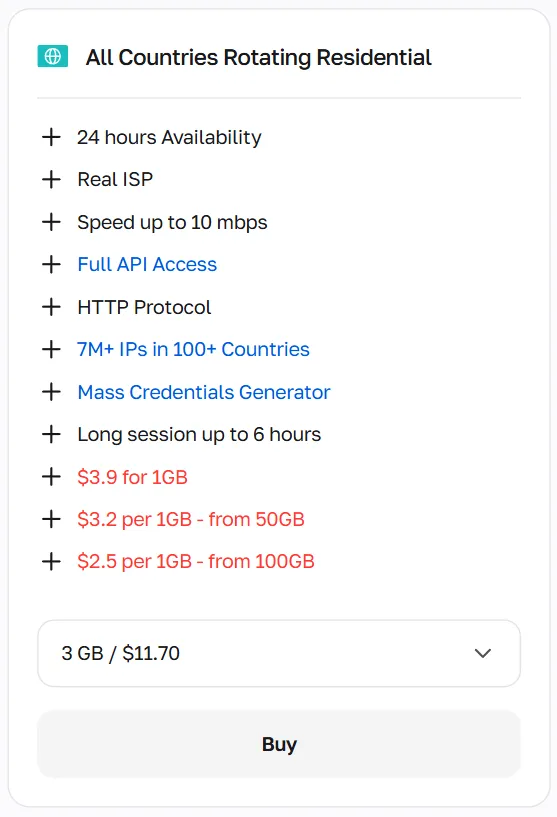
Selecciona IPs residenciales estáticas para gestión de cuentas a largo plazo, con el esquema de 1 IP = 1 cuenta, mientras que las IPs rotativas son necesarias para todas las actividades web masivas, con una estrategia de rotación de IP adecuada basada en cada caso de uso específico.
Proxies de datacenter: Bases de datos abiertas y pruebas de aplicaciones
Los proxies de datacenter proporcionan la velocidad de conexión más rápida, pero están asociados con tráfico no residencial, similar a bots. Funcionan bien para scraping de bases de datos abiertas, pruebas de APIs y tareas de alta velocidad donde las plataformas aplican detección mínima de bots, pero pueden ser restringidos rápidamente en plataformas sociales como Reddit o LinkedIn.
Herramienta adicional: Evaluación de riesgo antes de la ejecución
CyberYozh ofrece un IP Checker que escanea cada dirección IP contra las principales bases de datos de fraude para devolver un Fraud Score estricto e historial completo. Implementa un pipeline de «Evaluación de riesgo antes de la ejecución». Ejecuta tu IP a través del checker antes de lanzar la instancia del navegador. Esto evalúa tu nivel de riesgo real y ayuda a mantener una alta tasa de éxito operacional, reemplazando completamente las falsas garantías «a prueba de baneos».
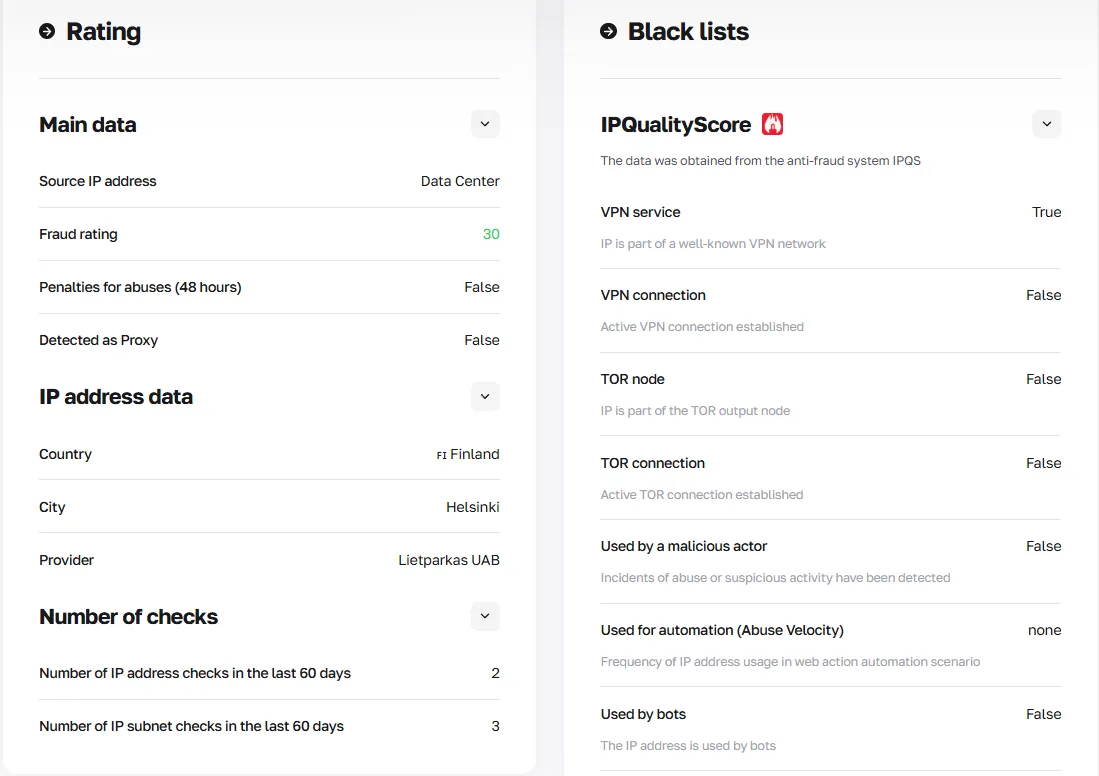
Obtén acceso a la CyberYozh API para automatizar la rotación de IP y verificar cada dirección IP entrante antes de rotar, asegurando su calidad.
Comenzando con la instalación de Playwright: Seleccionar un lenguaje
Playwright soporta cuatro lenguajes. Antes de comenzar tu instalación de Playwright y configuración de proxy, elige el lenguaje que se ajuste a tu stack. Esta guía usa Python, como la opción más comúnmente utilizada para flujos de trabajo con proxies, pero las cuatro opciones están cubiertas en la tabla e instrucciones breves a continuación.
Lenguaje | Diferencias clave | Casos de uso principales | Cuándo elegir |
Node.js (JS/TS) | Lenguaje predeterminado de Playwright; soporte de TypeScript listo para usar; comunidad y documentación más grandes | Pruebas de extremo a extremo, automatización de navegadores, CI/CD de frontend | Tu equipo trabaja en JS/TS, o necesitas las herramientas más maduras |
Python | Más ampliamente utilizado en scraping/ML; asíncrono vía asyncio; se integra con Requests, Scrapy | Web scraping, pipelines de datos, automatización de proxies, recopilación de datos de ML | Necesitas scraping intensivo de proxies o integración de ciencia de datos |
.NET (C#) | Distribución NuGet; tipado fuerte, bueno para QA empresarial | Automatización de pruebas empresariales, aplicaciones .NET | Tu organización utiliza un stack .NET |
Java | Distribución Maven/Gradle; integración JUnit | Aplicaciones empresariales Java, pruebas relacionadas con Android | Tu proyecto está basado en Java o requiere el ecosistema JVM |
Node.js
El lenguaje predeterminado y más completamente documentado de Playwright. TypeScript es compatible de forma nativa: Playwright se instala usando npm, sin necesidad de configuración adicional.
npm init playwright@latestPython
El lenguaje de referencia para tareas de proxy de Playwright, scraping y automatización de datos. Requiere Python 3.8+ y generalmente se instala vía PyPI (pip).
pip install playwright

playwright install
.NET (C#)
Distribuido como un paquete NuGet. Requiere PowerShell (pwsh) para ejecutar el paso de instalación del navegador.
dotnet new console -n PlaywrightDemo

cd PlaywrightDemo

dotnet add package Microsoft.Playwright

dotnet build

pwsh bin/Debug/netX/playwright.ps1 install
Java
Distribuido como un módulo Maven (mvn). Agrega la dependencia a tu pom.xml en Maven, y los navegadores se descargan automáticamente en la primera compilación.
<dependency>

  <groupId>com.microsoft.playwright</groupId>

  <artifactId>playwright</artifactId>

  <version>1.59.0</version>

</dependency>
Y luego ejecuta un comando:
mvn compile exec:java -D exec.mainClass="org.example.App"Configurar un proxy de Playwright con Python
Aquí exploraremos el despliegue generalizado de sesiones de scraping de Playwright con proxies de CyberYozh. Aunque el lenguaje predeterminado de Playwright es Node.js/TypeScript, usaremos Python en nuestro ejemplo, ya que Playwright con Python se usa ampliamente para automatización web, scraping y otras tareas relacionadas con proxies. Si necesitas usar TypeScript o tienes un caso de uso específico que requiera C# o Java, simplemente explora la versión correspondiente de la documentación de Playwright; es bastante fácil ajustar el código.
Un servidor proxy de Playwright es un intermediario de red que retransmite las solicitudes de tu navegador a través de una dirección IP diferente. Playwright pasa la configuración del proxy directamente al iniciar el navegador o a nivel de contexto, enrutando todo el tráfico a través del servidor especificado.
1. Obtén un proxy para tu tarea
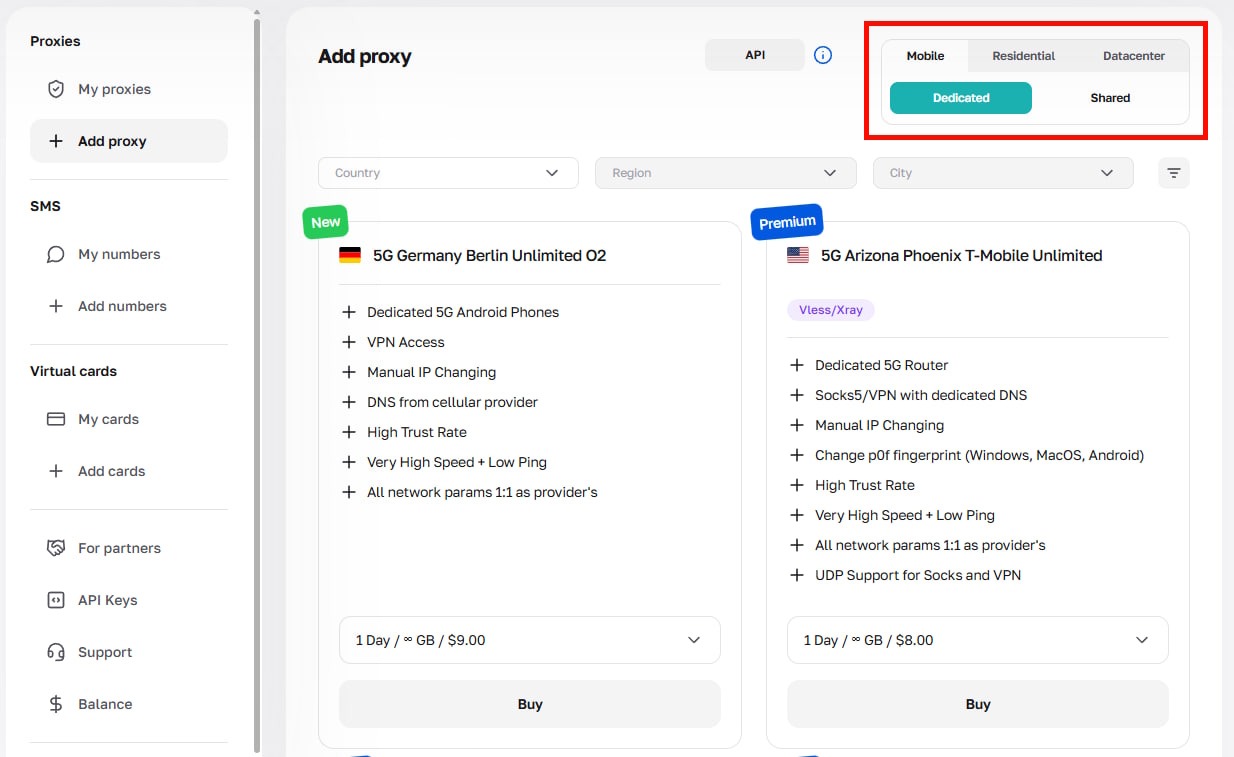
Inicia sesión en tu cuenta de CyberYozh, navega a Mis Proxiesy selecciona el tipo de proxy adecuado para tu tarea (móvil, residencial estático, residencial rotativo, datacenter).
Después de la compra, abre la tarjeta del proxy, haz clic en Generar Credenciales, elige tu modo de rotación (IP aleatoria, sesión corta o sesión larga) y navega al host, puerto, nombre de usuario y contraseña.
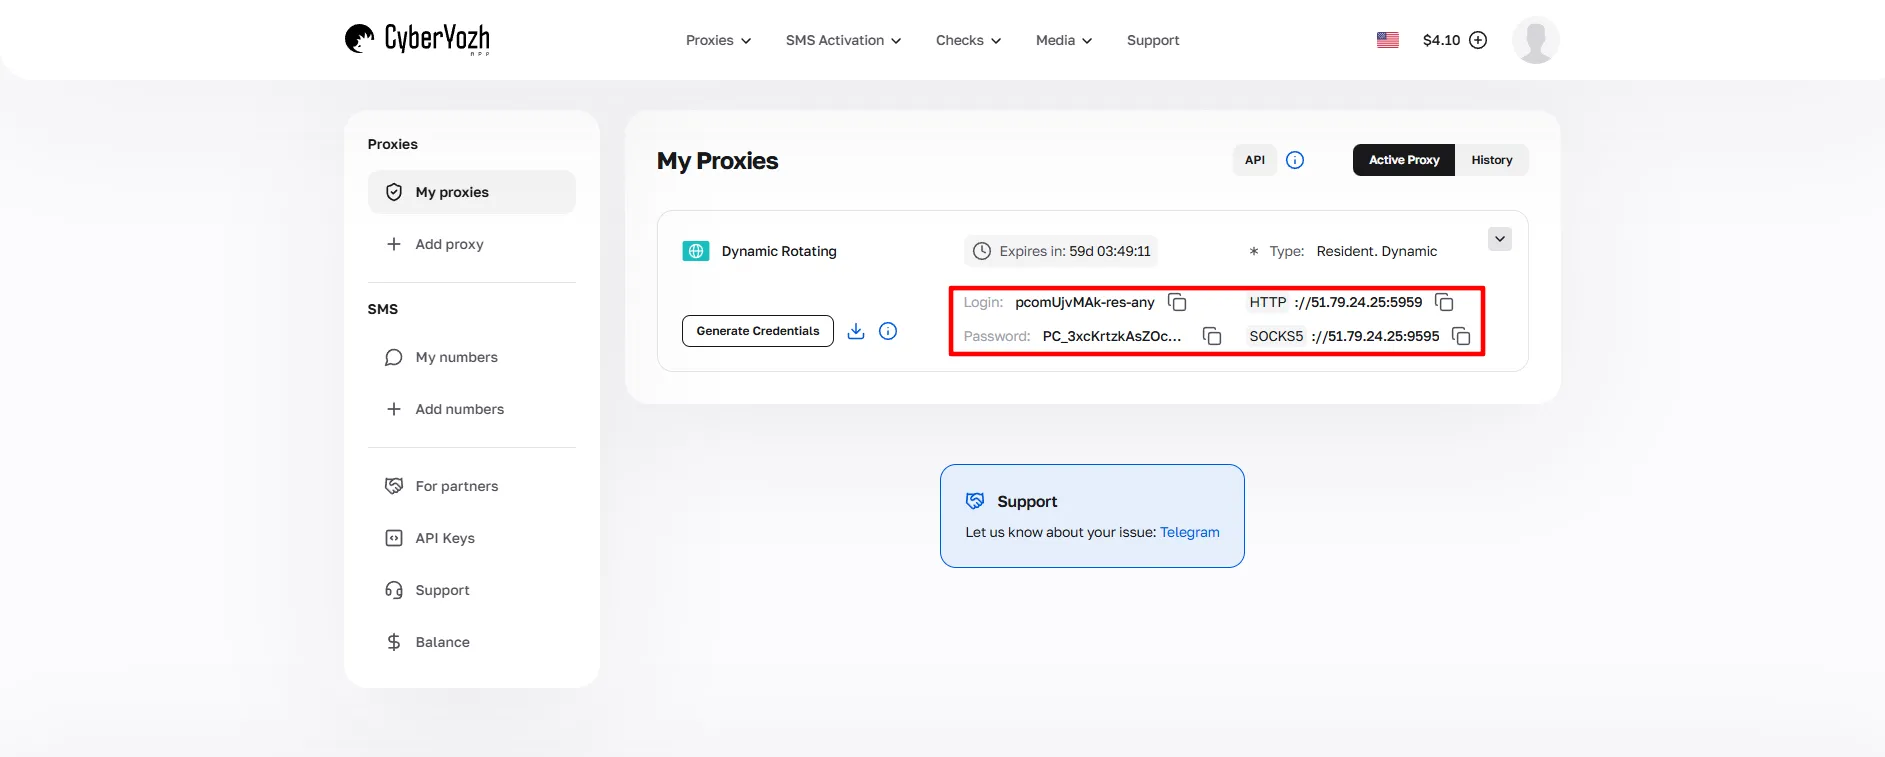
Estas credenciales se usarán durante toda la configuración.
2. Descarga e instala Playwright
Instala la biblioteca de Playwright y sus binarios de navegador a través de PyPI:
pip install playwright

playwright install
Esto descarga los binarios de Chromium, Firefox y WebKit. Para scraping, Chromium es la opción estándar.
3. Organiza una estructura de proyecto
Crea una carpeta de proyecto dedicada (por ejemplo, scraper/). Mantén las credenciales separadas de tu código y define una ruta de salida clara para los datos extraídos:
-Documento .env para credenciales de proxy (siempre agregar a .gitignore)
-scraper.py como el script principal de Playwright
-requirements.txt para dependencias
output/ carpeta para datos extraídos (CSV/JSON)
4. Agrega la configuración del proxy al archivo .env
Abre tu archivo .env en VS Code o cualquier editor y copia y pega tus credenciales de CyberYozh. Siempre agrega .env a tu .gitignore para evitar la filtración de credenciales a repositorios de control de versiones.
HTTP_PROXY=http://username:password@proxy-server-ip:host
SOCKS5_PROXY=socks5://username:password@proxy-server-ip:host
Para una configuración de proxy SOCKS5 de Playwright, usa el esquema socks5://. Para el uso estándar de proxy HTTP de Playwright, usa el esquema http://. Asegúrate de incluir los puertos correctos del panel de CyberYozh. Si usas la API de CyberYozh, tu clave de API también debe especificarse aquí.
CYBERYOZH_API_KEY=Your_API_URL_Key5. Crear un script de scraping/automatización
Cree el archivo de prueba de Python usando Playwright. Debe tener aproximadamente la siguiente estructura:
Creación de entidades de navegador y contexto con configuración de proxy
Configuración de rotación automatizada y verificación de IP mediante la API de CyberYozh
Ir al sitio web de destino y realizar scraping mediante la biblioteca Requests
Configurar el manejo de errores
Especificar la carpeta de salida para los datos extraídos
El script a continuación implementa la configuración completa de proxy de Playwright en Python: una entidad de navegador, una entidad de contexto con autenticación de proxy de Playwright, rotación de IP automatizada mediante la API de CyberYozh, ejecución de solicitudes, manejo de errores y salida de archivos.
Visite la documentación de la API de CyberYozh para explorar cómo exactamente puede implementar los comandos de la API para el uso automatizado del servicio CyberYozh
import asyncio
import os
import json
import requests
from dotenv import load_dotenv
from playwright.async_api import async_playwright

load_dotenv()

PROXY_URL = os.getenv("HTTP_PROXY")  # or SOCKS5, from the .env document
CYBERYOZH_API_KEY = os.getenv("CYBERYOZH_API_KEY") # API key from the .env document
TARGET_URL = "https://httpbin.org/ip" # the website to scrape; here is the test one
OUTPUT_FILE = "output/results.json" # output folder


def check_ip_quality(ip: str) -> bool:

    """Use CyberYozh IP Checker API to verify trust score before rotating."""

    try:

        response = requests.get(
            f"https://app.cyberyozh.com/api/v1/checkers/socks/",
            headers={"Authorization": f"Bearer {CYBERYOZH_API_KEY}"},
            timeout=5
        )

        score = response.json().get("fraud_score", 100)
        return score < 50  # Accept IPs with fraud score below 50

    except Exception:

        return True  # Allow on API error


async def scrape(proxy_url: str) -> dict:

    """Run a single Playwright scraping session with proxy."""

    # Parse proxy credentials for Playwright proxy authentication

    from urllib.parse import urlparse

    parsed = urlparse(proxy_url)

    proxy_config = {
        "server": f"{parsed.scheme}://{parsed.hostname}:{parsed.port}",
        "username": parsed.username,
        "password": parsed.password,
    }


    async with async_playwright() as p:

        # Browser entity (headless to save traffic): launch with proxy server

        browser = await p.chromium.launch(headless=True)
        # Context entity: proxy settings applied per context

        context = await browser.new_context(proxy=proxy_config)
        page = await context.new_page()


        try:

            await page.goto(TARGET_URL, timeout=30000)
            content = await page.inner_text("body")
            result = json.loads(content)
            return {"status": "ok", "ip": result.get("origin")}

        except Exception as e:

            return {"status": "error", "error": str(e)}

        finally:

            await context.close()
            await browser.close()


async def main():

    results = []

    for i in range(5):

        print(f"Request {i+1}: using proxy {PROXY_URL}")
        data = await scrape(PROXY_URL)
        print(f"  → IP: {data.get('ip')} | Status: {data.get('status')}")
        results.append(data)

    os.makedirs("output", exist_ok=True)

    with open(OUTPUT_FILE, "w") as f:

        json.dump(results, f, indent=2)

    print(f"Results saved to {OUTPUT_FILE}")


asyncio.run(main())Consulte también la guía relacionada: Configuración de la rotación de proxy en Python.
6. Ejecutar la prueba y rotar el proxy
Inicie el scraper desde la raíz de su proyecto:
python scraper.pyVerifique que cada solicitud registre una dirección IP diferente (confirmando que la rotación está activa) y que el archivo output/results.json esté poblado. Use la API de CyberYozh para rotación automatizada y verificaciones de calidad automatizadas mediante el IP Checker: los proxies con un fraud score alto serán rechazados antes del siguiente ciclo de rotación.
Consulte también: Guía de automatización de web scraping
Resumen: Uso de Playwright con la infraestructura de CyberYozh
Con los proxies de Playwright configurados y las credenciales de CyberYozh activas, puede ejecutar scraping multi-objetivo, automatización geo-dirigida y flujos de trabajo de gestión de cuentas a escala, enrutando cada sesión de navegador a través de IPs residenciales o móviles limpias con validación de fraud score, mientras genera datos estructurados en el formato de su elección.