Web Scraper Không Cần Code: Trích Xuất Dữ Liệu Trực Quan & Tự Động Hóa AI
Trích xuất dữ liệu thị trường ngày càng khó khăn hơn mỗi ngày. Bạn cố gắng lấy giá của đối thủ cạnh tranh hoặc thu thập thông tin liên hệ khách hàng tiềm năng, nhưng máy chủ mục tiêu ngắt kết nối của bạn. Xây dựng các script crawling tùy chỉnh tốn thời gian kỹ thuật và đòi hỏi bảo trì liên tục. Các nền tảng tự động hóa hiện đại đơn giản hóa việc trích xuất dữ liệu không cần code. Nếu bạn muốn học cách web scrape không cần code, giao diện trực quan cho phép bạn trích xuất thông tin trực tiếp qua trình duyệt. Chúng chuyển công việc kỹ thuật sang trí tuệ nhân tạo.
TL;DR: Cách trích xuất dữ liệu từ website không cần code trong vòng chưa đầy năm phút
Quên đi những script Python dễ vỡ và việc kiểm tra DOM thủ công. Bạn có thể xây dựng một data pipeline có khả năng phục hồi cao ngay bây giờ:
Chọn các phần tử web mục tiêu bằng cú nhấp chuột đơn giản sử dụng giao diện trực quan point-and-click.
Để AI tích hợp sẵn tự động sửa chữa các thuật toán trích xuất bị hỏng bất cứ khi nào bố cục mục tiêu thay đổi.
Ủy thác việc render JavaScript nặng và infinite scrolling cho công cụ trình duyệt Playwright gốc.
Định tuyến lưu lượng qua mạng residential xoay vòng để duy trì truy cập ổn định mà không kích hoạt anti-bot.
Xuất dữ liệu sạch thành file CSV hoặc đẩy dataset Markdown sẵn sàng cho LLM trực tiếp đến AI agentcủa bạn.
Tại sao nên sử dụng công cụ web scraping trực quan
Các công ty tạo ra khối lượng dữ liệu phi cấu trúc khổng lồ trong e-commerce hàng ngày. Các mô hình ngôn ngữ lớn cũng yêu cầu đào tạo liên tục trên các dataset mới. Nhu cầu này đã đẩy thị trường web scraping toàn cầu lên mức định giá 3,82 tỷ đô la vào năm 2025, với dự báo đạt 11,08 tỷ vào năm 2034. Thu thập dữ liệu từng là một nhiệm vụ kỹ thuật nghiêm ngặt.
Các nhà phát triển xây dựng các framework tự động hóa trình duyệt phức tạp sử dụng Puppeteer và Playwright. Nhưng các script dựa vào CSS selector và XPath được mã hóa cứng sẽ bị hỏng ngay lập tức khi các website triển khai các bài test A/B đơn giản hoặc cập nhật bố cục của chúng.
Một no code web scraper hiện đại trừu tượng hóa sự phức tạp kỹ thuật này. Bạn có được giao diện trực quan point-and-click để ánh xạ các thuật toán trích xuất ngay lập tức. Hệ thống xử lý phân trang và thực hiện render JS động tự động.
👉 Proxy di động 4G và 5G: vượt qua giới hạn khu vực với mạng cao cấp
Trường hợp người dùng thực tế: Theo dõi giá E-commerce
Hãy tưởng tượng bạn đang điều hành một doanh nghiệp dropshipping cạnh tranh ngày nay. Bạn cần no code web scraper tốt nhất cho theo dõi giá ecommerce. Bạn muốn giám sát hàng tồn kho của đối thủ cạnh tranh trên nhiều marketplace một cách liền mạch.
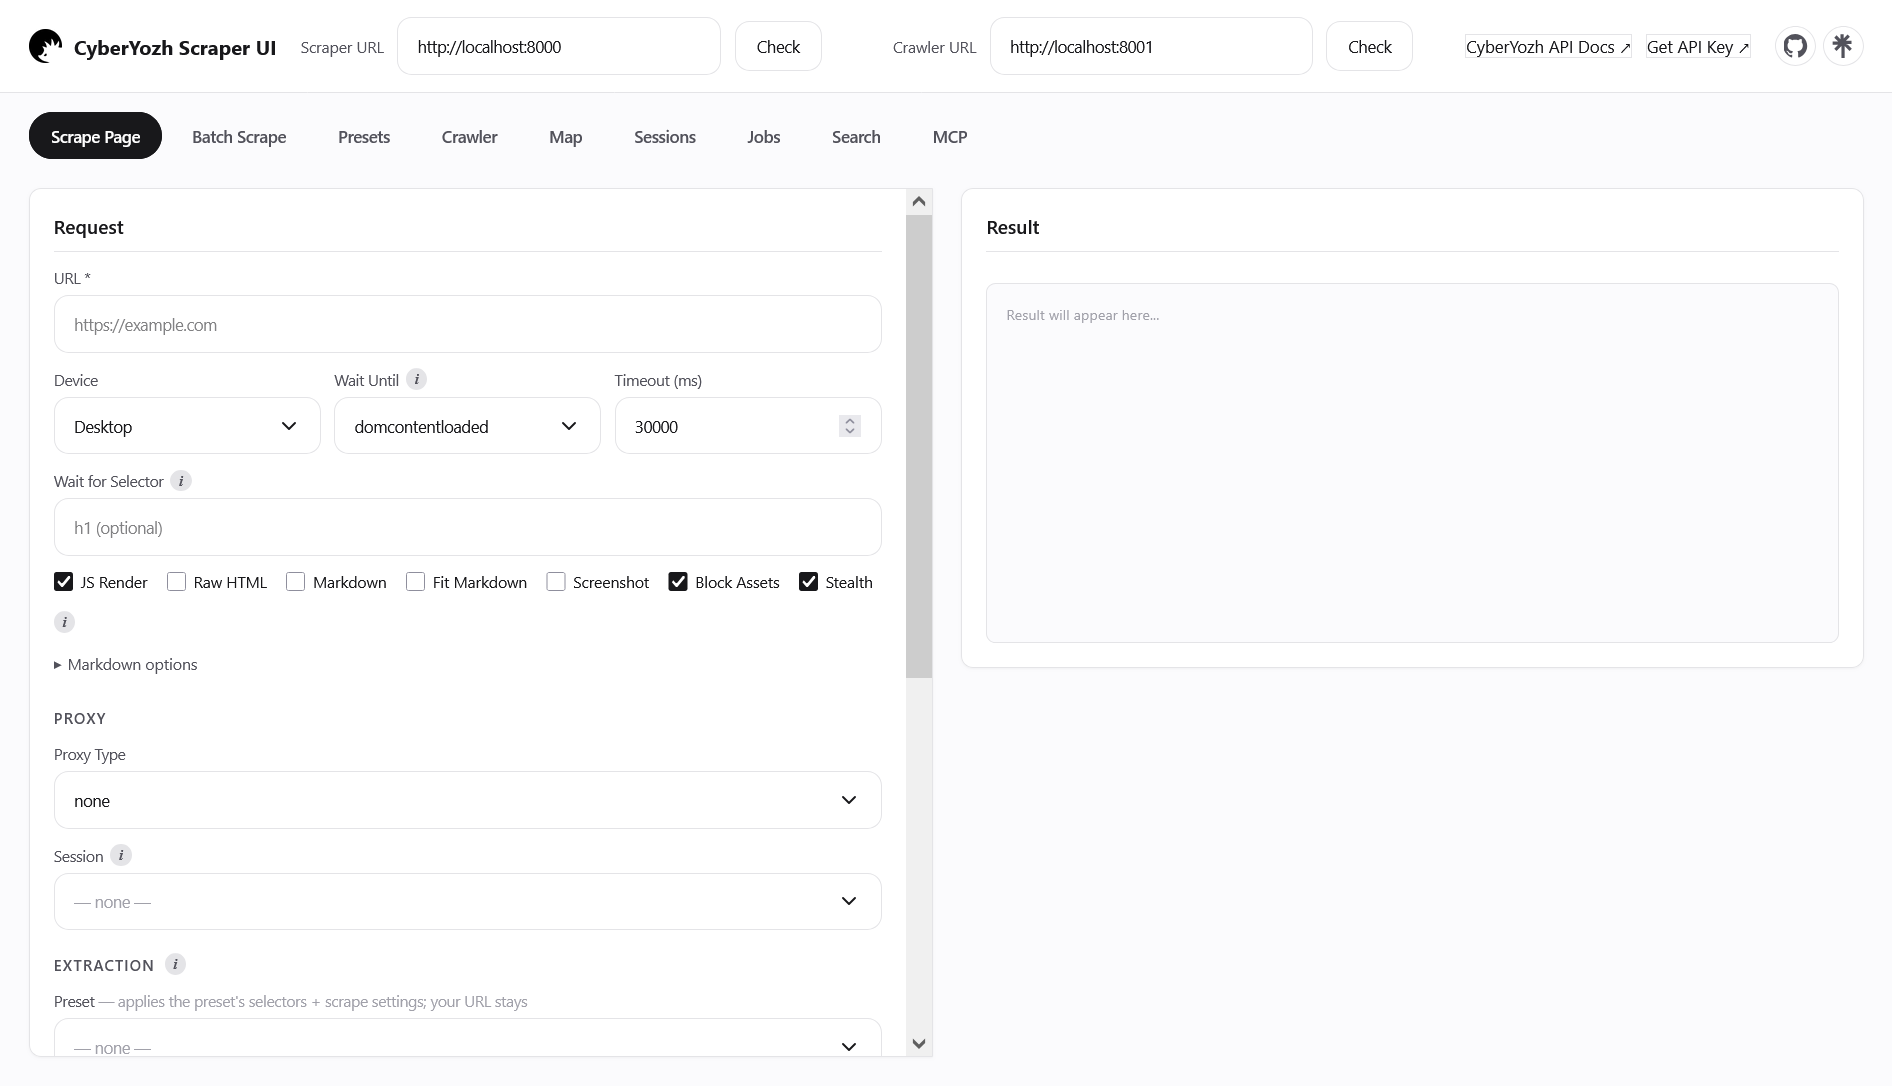
Bạn khởi chạy công cụ web scraping trực quan của mình. Bạn nhập URL danh mục mục tiêu. Bạn nhấp trực tiếp vào tiêu đề sản phẩm. Bạn chọn thẻ giá. Hệ thống phát hiện mẫu lặp lại ngay lập tức. Nó ánh xạ logic phân tích DOM cho bạn. Bạn nhấp nút chạy.
Thiết lập automated web scraper no code xử lý hàng đợi. Nó trích xuất hàng trăm mục trong vài phút. Cuối cùng, bạn sử dụng tính năng xuất CSV để đẩy JSON có cấu trúc vào dashboard phân tích của bạn. No code web scraper này thực hiện các tương tác trình duyệt tự nhiên. Nó nhấp các nút với độ trễ ngẫu nhiên ở mức micro. Nó cuộn trang giống như một con người thực sự.
Tại sao các website hạn chế yêu cầu tự động
Khi bạn scrape các website động mà không cần coding, tường lửa doanh nghiệp thường ngắt kết nối của bạn. Hạn chế thường xảy ra ở tầng vận chuyển trong quá trình TLS Handshake ban đầu.
Các Web Application Firewall hiện đại phân tích gói ClientHello. Client gửi gói này khi thiết lập kết nối được bảo vệ. Các thuật toán JA3 và JA4 băm các tham số cụ thể này. Chúng kiểm tra sâu phiên bản TLS. Chúng kiểm tra các cipher suite được hỗ trợ và các đường cong elliptic.
Các thư viện mạng Python hoặc Node.js tiêu chuẩn tạo ra các TLS fingerprintcụ thể. Các chữ ký này khác biệt hoàn toàn so với các trình duyệt thương mại như Chrome hoặc Safari. Các bộ lọc lưu lượng phát hiện bất thường mạng này ngay lập tức. Chúng đặt lại kết nối của bạn hoặc yêu cầu xác minh thủ công. Do đó, một no code web scraper đáng tin cậy phải dựa trên công cụ trình duyệt thực. Nó phải căn chỉnh TLS fingerprint chính xác để duy trì truy cập ổn định.
👉 Proxy ISP dân cư: kết nối cục bộ ổn định cho việc trích xuất
Nền tảng hạ tầng proxy
Việc khớp dấu vân tay TLS không có ý nghĩa gì nếu thiếu địa chỉ IP sạch. Công cụ web scraper không cần code của bạn đòi hỏi một hạ tầng proxy vững chắc. Hệ sinh thái CyberYozh App cung cấp chính xác những giải pháp mở rộng này. Nền tảng duy trì chính sách không lưu log nghiêm ngặt. Nó cung cấp hỗ trợ kỹ thuật 24/7 và các phương thức thanh toán có tính riêng tư cao.
Hạ tầng định tuyến chuyên nghiệp dựa trên các chỉ số kỹ thuật nghiêm ngặt. Mạng lưới proxy của bạn phải đáp ứng chính xác các tiêu chí này để đảm bảo thu thập dữ liệu không bị gián đoạn:
Giá tốt nhất: Thanh toán theo mức sử dụng không có phí ẩn.
Tốc độ cao: Độ trễ ping thấp để render các ứng dụng Single-Page nặng.
IP sạch: Tỷ lệ tin cậy cao để loại bỏ kiểm tra chống bot.
Nhiều vị trí địa lý: Nhắm mục tiêu chi tiết đến từng mã ZIP cụ thể trên 195+ quốc gia.
Chuyển băng thông: Băng thông chưa sử dụng được chuyển sang kỳ thanh toán tiếp theo.
Tỷ lệ thành công 99%: Cân bằng tải thông minh đảm bảo gửi yêu cầu thành công.
Thời gian hoạt động 99,99%: Các node chịu lỗi giữ cho các tác vụ chạy dài luôn hoạt động.
Dùng thử miễn phí: Đảm bảo hoàn tiền để kiểm tra khả năng tương thích.
Thanh toán linh hoạt: Hỗ trợ rộng rãi cho thẻ quốc tế và tiền mã hóa.
Hỗ trợ UDP: Xử lý native các giao thức truyền tải hiện đại.
Định dạng xuất: Tạo danh sách IP nhanh chóng (IP:PORT:USER:PASS).
Phê duyệt dịch vụ: Khả năng tương thích được xác minh trước với các nền tảng lớn như Amazon hoặc Google.
Hỗ trợ nhanh: Kỹ sư 24/7 sẵn sàng giải quyết các sự cố định tuyến.
Loại mạng lưới | Tính năng chính | Kịch bản triển khai lý tưởng |
Mobile Proxies | Tỷ lệ tin cậy tối đa (5G/LTE) | Mạng xã hội, nội dung di động |
Residential ISP | Địa chỉ nhà cung cấp thực tĩnh | Trích xuất phức tạp, phiên dài |
Rotating Residential | Nhóm 100M+, xoay vòng tức thì | Tổng hợp giá sàn thương mại điện tử quy mô lớn |
Datacenter Nodes | Ping thấp, thời gian hoạt động 99,99% | Scraping API tốc độ cao, chỉ số SEO |
Rotating residential proxies cung cấp nền tảng tốt nhất có thể cho việc tổng hợp dữ liệu quy mô lớn. Bạn có quyền truy cập ngay lập tức vào hơn 100 triệu địa chỉ. Bạn chỉ trả tiền cho băng thông đã sử dụng. Bạn có thể dễ dàng cấu hình sticky sessions kéo dài tới 24 giờ. Thiết lập thông minh này đảm bảo việc trích xuất dữ liệu của bạn hòa trộn hoàn hảo với lưu lượng người dùng thực.
👉 Rotating residential network: xoay vòng địa chỉ động cho scraping
Phiên và xác thực được quản lý bởi máy chủ
Nhiều công cụ trích xuất thất bại hoàn toàn khi lấy dữ liệu đằng sau tường đăng nhập. Các script tiêu chuẩn khởi tạo một phiên mới, sạch trên mỗi yêu cầu HTTP. Hệ thống bảo mật phát hiện hành vi robot này. Chúng khóa hồ sơ người dùng vô thời hạn.
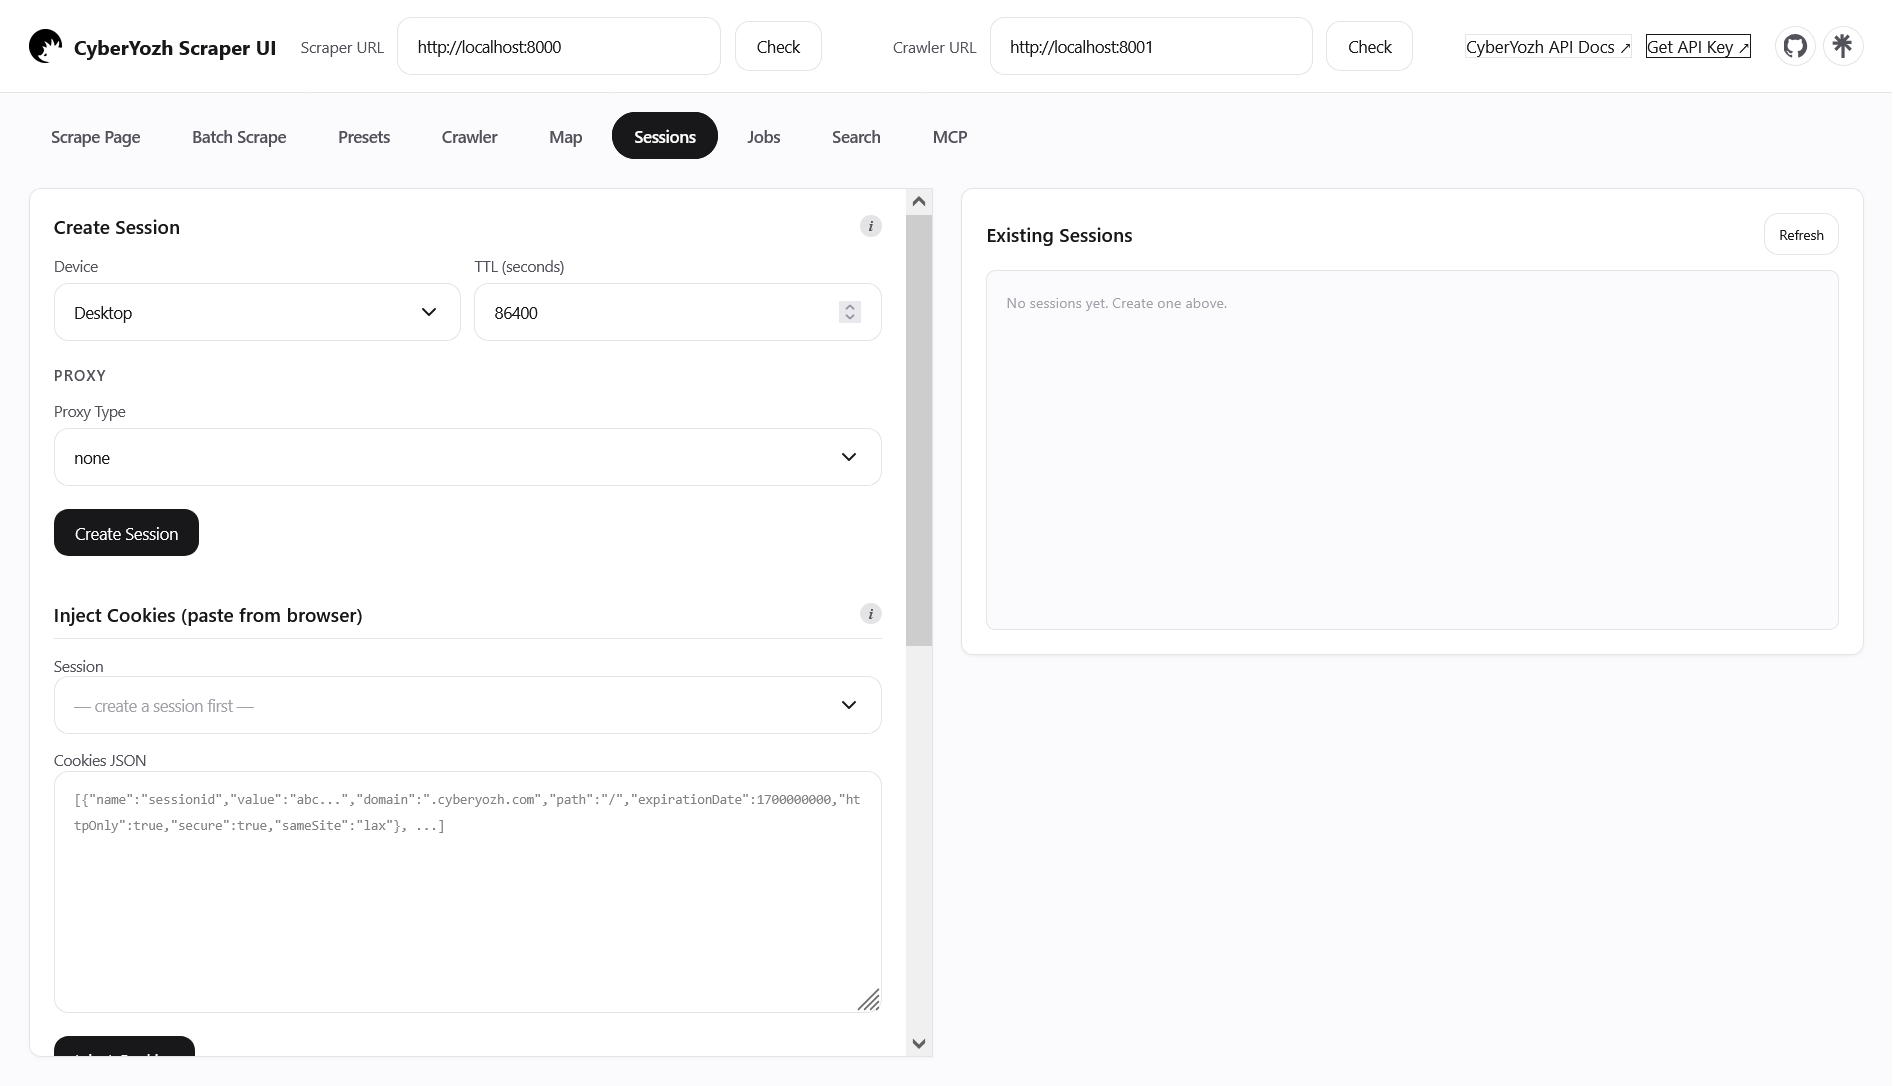
Nền tảng Yozh Scraper giải quyết vấn đề này thông qua các phiên được quản lý bởi máy chủ. Bạn chèn cookies trình duyệt đang hoạt động trực tiếp vào giao diện trực quan. Máy chủ bảo toàn ngữ cảnh này một cách cẩn thận. No code web scraper của bạn hoạt động chính xác như một người dùng đã xác thực, đang quay lại. Nó điều hướng các hồ sơ được bảo vệ một cách mượt mà.
👉 Tải Yozh Scraper mã nguồn mở trên GitHub
Cách scrape các trang web động mà không cần code bằng AI
Yozh Scraper là một nền tảng mã nguồn mở loại bỏ việc kiểm tra DOM thủ công và JSON payloads. Backend sử dụng công cụ trình duyệt Playwright gốc trên cổng 8000, trong khi frontend hoạt động như một visual studio Node.js trên cổng 7000.
Bạn diễn đạt yêu cầu của mình bằng ngôn ngữ tự nhiên. Trình tạo AI phân tích markup và tạo schema trích xuất chính xác.
Nền tảng có tính năng parser tự phục hồi bằng AI. Các nền tảng mục tiêu thay đổi HTML của chúng liên tục. Một no code web scraper tiêu chuẩn ném ra lỗi nghiêm trọng khi một trường trả về rỗng. Yozh Scraper chặn luồng điều khiển, đọc cấu trúc HTML thô và trích xuất dữ liệu bị thiếu tự động. Nền tảng cũng bao gồm một Search API đồng bộ để phân tích kết quả Google, Bing và Yandex ngay lập tức, cộng với mô-đun trực quan hóa sitemap thời gian thực ánh xạ cấu trúc trang web thông qua Server-Sent Events.
👉 Datacenter proxies: tốc độ cực cao cho các yêu cầu API tự động
Tích hợp MCP và datasets sẵn sàng cho LLM
Các quy trình tự động hóa ngày nay phụ thuộc rất nhiều vào các mô hình ngôn ngữ lớn. Mạng nơ-ron gặp khó khăn trong việc xử lý mã HTML nhiễu một cách hiệu quả. Chúng ảo giác nhanh chóng. Chúng mất ngữ cảnh quan trọng. Vì lý do này, no code web scraping cho các datasets markdown LLM đã trở thành tiêu chuẩn ngành chính.
Yozh Scraper bao gồm một công cụ lọc nội dung tích hợp có khả năng cao. Nó loại bỏ các khối quảng cáo, bảng điều hướng và footer phức tạp tự động. Nó xuất văn bản sạch ở định dạng Markdown nghiêm ngặt. Dữ liệu có cấu trúc này phù hợp hoàn hảo với cửa sổ ngữ cảnh LLM.
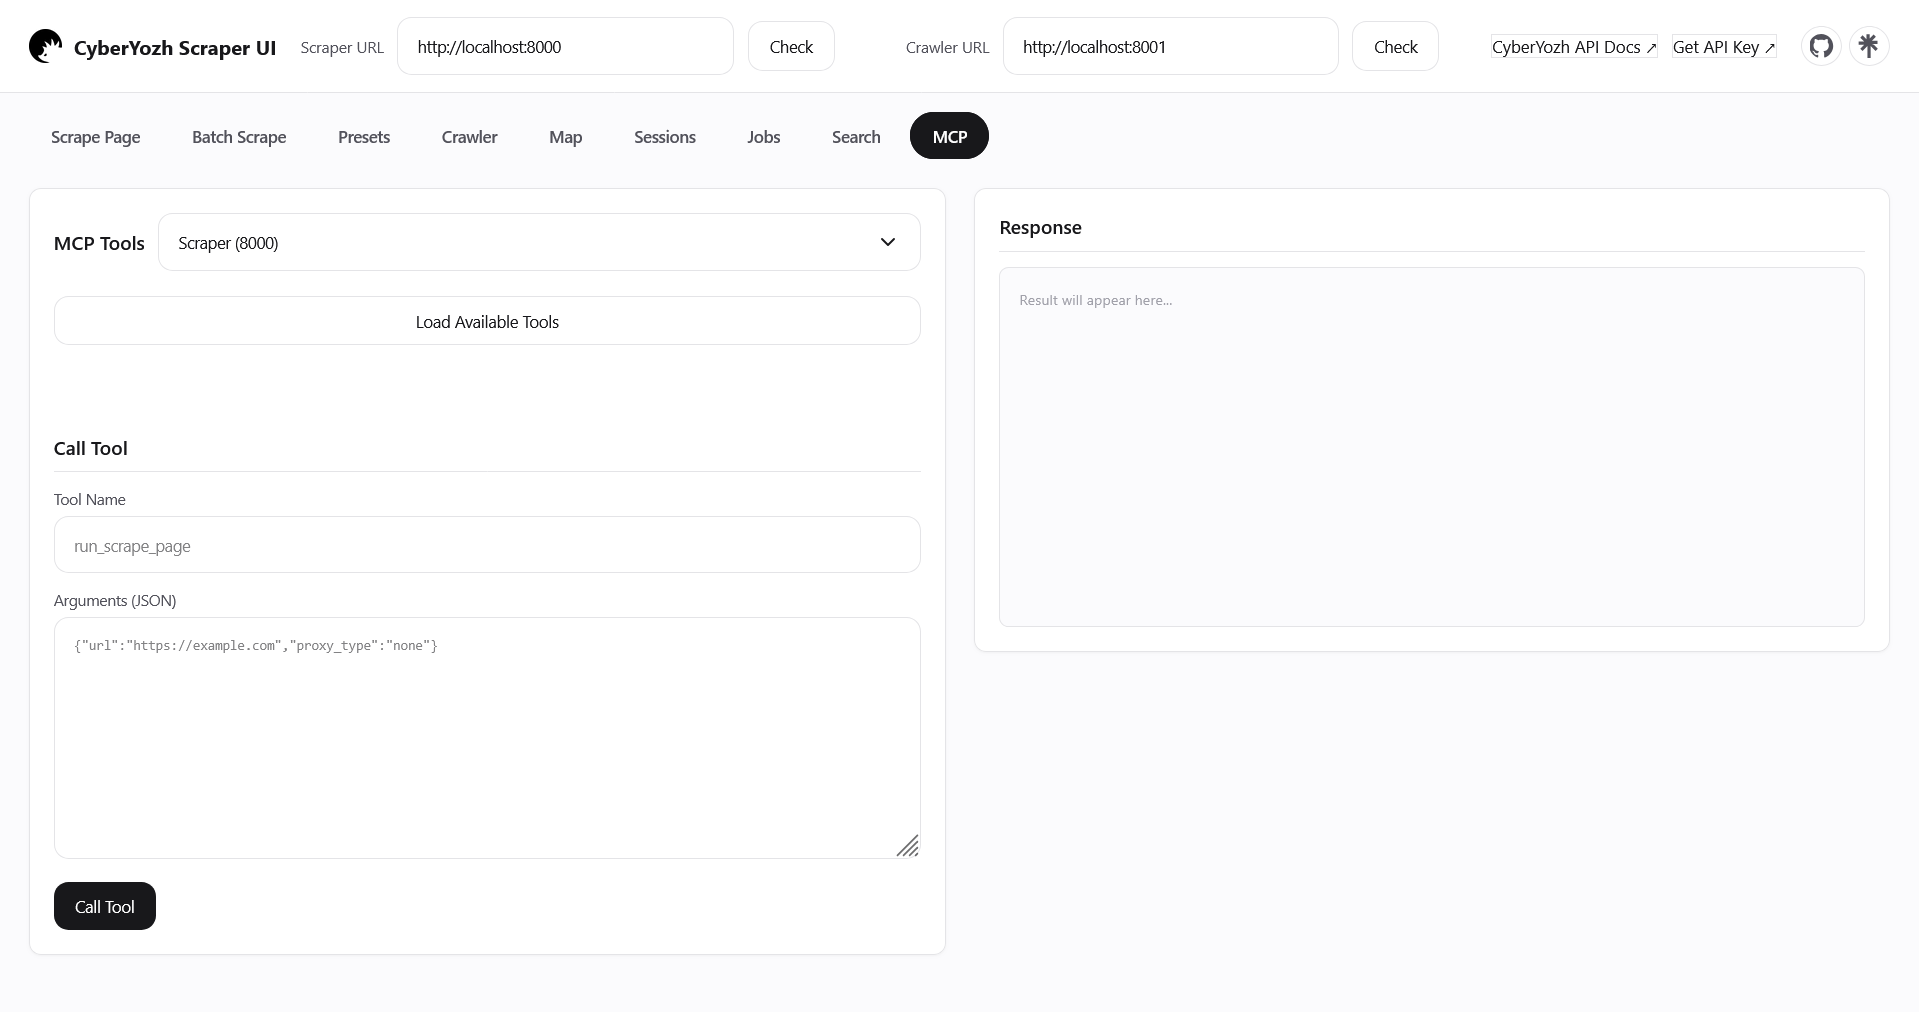
Nền tảng cung cấp tích hợp Model Context Protocol (MCP) gốc. Backend gắn kết một điểm cuối MCP qua Streamable HTTP, cung cấp các công cụ như run_scrape_page và create_crawl một cách gốc. Các nhà phát triển cấu hình Claude Desktop hoặc bộ điều hợp LangChain của họ để gửi lệnh trực tiếp. Agent lập kế hoạch các tác vụ trích xuất dữ liệu một cách tự động, gọi Yozh Scraper và phân tích kết quả mà không cần bất kỳ mã middleware nào. Visual studio có tab MCP Inspector chuyên dụng để debug agent nhanh chóng.
Các kịch bản triển khai thực tế
Khả năng phân tích cú pháp trực quan mở ra cánh cửa cho các hoạt động kinh doanh phức tạp.
Thông tin giá cả thương mại điện tử. Người bán trên marketplace cấu hình trình thu thập dữ liệu trực quan để quét sản phẩm theo giờ. Rotating residential proxy cho phép bạn tổng hợp giá cả trên các khu vực mà không kích hoạt hệ thống chống gian lận. Bạn phân tích đánh giá của đối thủ cạnh tranh một cách dễ dàng. Bạn theo dõi động thái hàng tồn kho mà không kích hoạt hệ thống chống bot.
Tạo khách hàng tiềm năng B2B. Các công cụ tự động hóa quét thư mục doanh nghiệp liên tục. Phần mềm tổng hợp tên công ty và số liên lạc chính xác. Nhờ JavaScript rendering, công cụ trích xuất dữ liệu ẩn sau các phần tử tương tác. Bạn dễ dàng lấy được số điện thoại bị che giấu bởi các nút động.
Xây dựng bộ dữ liệu LLM. Các nhóm nghiên cứu sử dụng các hàm crawler cho các hoạt động scraping hàng loạt nặng. Họ xử lý các cổng thông tin tin tức và blog doanh nghiệp rộng lớn. Hệ thống tự động chuyển đổi hàng nghìn trang web thành các tài liệu Markdown được định dạng.
Phân tích bất động sản. Các công ty bất động sản triển khai parser để giám sát các trang rao vặt địa phương liên tục. Static ISP proxy mô phỏng hành vi người dùng địa phương một cách hoàn hảo. Thiết lập này đảm bảo truy xuất dữ liệu xác thực mà không có bất kỳ sai lệch giá theo khu vực nào.
Quản lý danh tính và xác minh Fraud Score
Các pipeline trích xuất dữ liệu thường gặp phải rào cản xác minh bất ngờ. Các nền tảng mục tiêu yêu cầu mã SMS để tiếp tục. CyberYozh App cung cấp số ảo cho hơn 700 trang web toàn cầu. Bạn có thể thuê số từ các nhà mạng địa phương thực để vượt qua giới hạn khu vực nhanh chóng.
👉 Số ảo: đăng ký hồ sơ bằng mạng ISP xác thực
Bạn cũng có thể phát hành thẻ token hóa ảo ngay lập tức. Các thẻ này tích hợp với Apple Pay và Google Pay một cách gốc. Bạn đặt giới hạn chi tiêu và kiểm soát số dư từ một dashboard duy nhất. Chúng hoạt động hoàn hảo cho các đăng ký SaaS và mua hàng hóa kỹ thuật số.
👉 Thẻ ngân hàng ảo: tài trợ các đăng ký SaaS của bạn
Trước khi khởi chạy các script trích xuất mạnh mẽ, hãy kiểm tra danh tiếng IP của bạn bằng Anti-Fraud Checker. Bạn có thể thấy rõ dấu vết kỹ thuật số của mình qua con mắt của các tường lửa doanh nghiệp. Cần mở rộng quy mô hoạt động dữ liệu của bạn hơn nữa? Truy cập CyberYozh Data để có thêm các công cụ scraping và tự động hóa từ CyberYozh. Bạn sẽ tìm thấy các giải pháp hiệu quả cao cho bất kỳ tác vụ trích xuất dữ liệu nào.
👉 Trình kiểm tra chống gian lận: xem dấu vết kỹ thuật số của bạn trước khi scraping
Câu hỏi thường gặp về no code web scraper
Công cụ web scraping trực quan hoạt động như thế nào?
Nó sử dụng một browser engine backend như Playwright hoạt động trên cổng 8000. Nó hiển thị trang động một cách trực quan. Bạn nhấp vào các phần tử và hệ thống tự động tạo các CSS selector cần thiết.
Làm thế nào để vượt qua các thách thức cloudflare no code web scraper?
Bạn phải triển khai một công cụ giả mạo TLS fingerprint một cách hoàn hảo. Kết hợp nó với mobile hoặc residential ISP proxy có độ tin cậy cao để tránh hoàn toàn CAPTCHA trong quá trình thu thập dữ liệu.
Tại sao sử dụng no code web scraper thay vì script Python?
Các script Python được hardcode bị hỏng ngay lập tức khi các trang web thay đổi bố cục của chúng. Các công cụ no code được hỗ trợ bởi AI sử dụng các thuật toán tự phục hồi để tự động thích ứng với các thay đổi DOM.
Trích xuất dữ liệu visual point-and-click là gì?
Đó là một phương pháp đơn giản hóa để chọn các phần tử web một cách trực quan. Phần mềm dịch các tương tác màn hình của bạn thành một thuật toán scraping mạnh mẽ mà không cần bất kỳ lập trình nào.
Nền tảng web scraper tự động không cần code có thể xử lý infinite scrolling không?
Có. Nền tảng mô phỏng hành vi cuộn tự nhiên của con người. Nó kiên nhẫn chờ JavaScript render các mục mới trước khi tiếp tục vòng lặp trích xuất.
Làm thế nào để xuất các dataset sẵn sàng cho LLM?
Bạn có thể tải xuống các file có cấu trúc trực tiếp qua CSV export. Bạn cũng có thể sử dụng API integrations để đẩy JSON payloads thẳng vào cơ sở dữ liệu doanh nghiệp của bạn.