如何在 Playwright 中设置代理进行网页抓取
Playwright 是一个现代化的网页抓取和自动化框架,支持多种编程语言,并能与 CyberYozh 代理良好集成,提供额外的安全性和会话稳定性。在此,了解如何设置 Playwright 并确保您的工作顺利完成。
准备工作:选择与 Playwright 配合使用的代理
在配置 Playwright 代理集成之前,您必须构建正确的抓取/自动化基础设施。您的代理类型决定了信任级别、会话稳定性、速度以及平台如何感知您的流量。
移动代理:社交数据、精准地理定位和 Google SERP
移动代理 在所有代理类型中具有最高的信任度。它们是社交媒体数据提取的必选项,例如 Instagram、 TikTok和 Snapchat。您还可以部署移动 LTE/5G 基础设施,用于多线程、全天候的 Google SERP 抓取。移动运营商利用 CGNAT 技术,将数千个真实智能手机用户隐藏在单个 IP 地址后面。Google 无法在不断开整个社区连接的情况下封锁这些节点。这种架构为您提供无限流量,让您的解析器无限扩展而无需按流量付费。
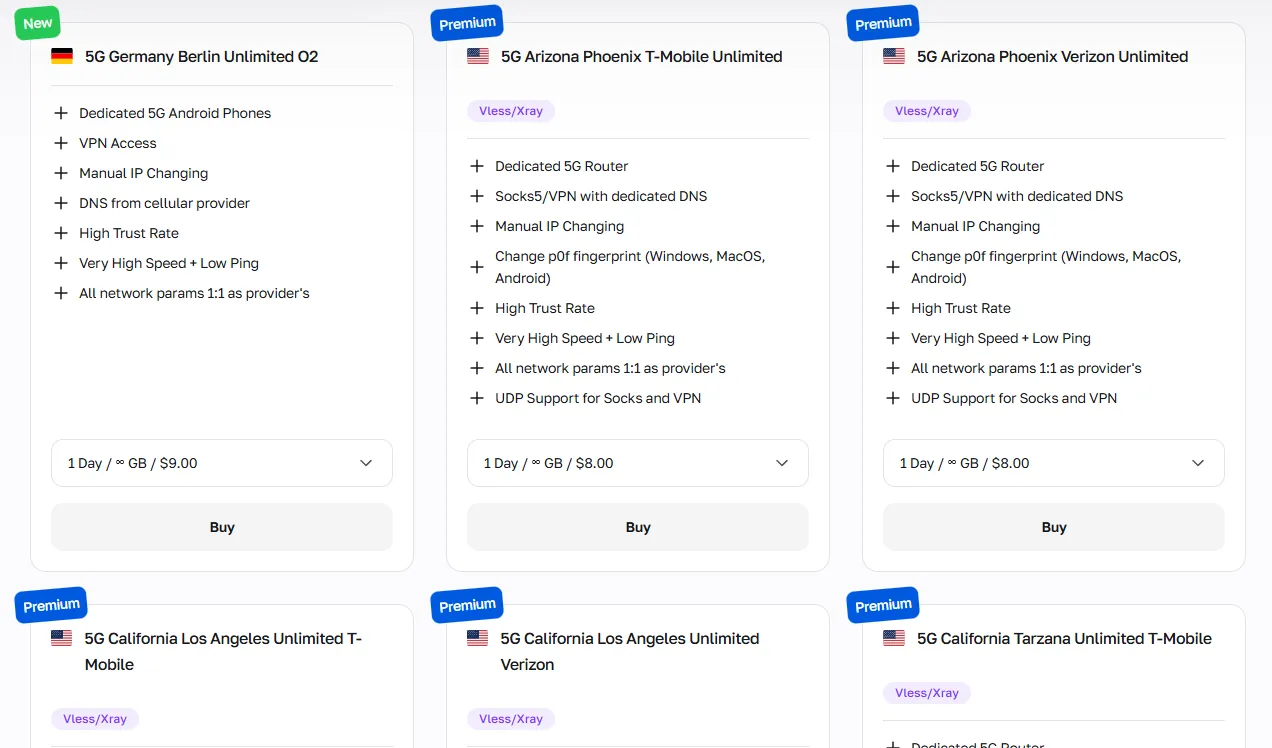
CyberYozh 移动代理提供高度定制化的精准地理定位、指纹设置和无限流量;当您需要 Playwright 模拟真实移动用户时,这是理想选择。
住宅代理:通用数据抓取和自动化
住宅代理根据您的使用场景分为两种类型:
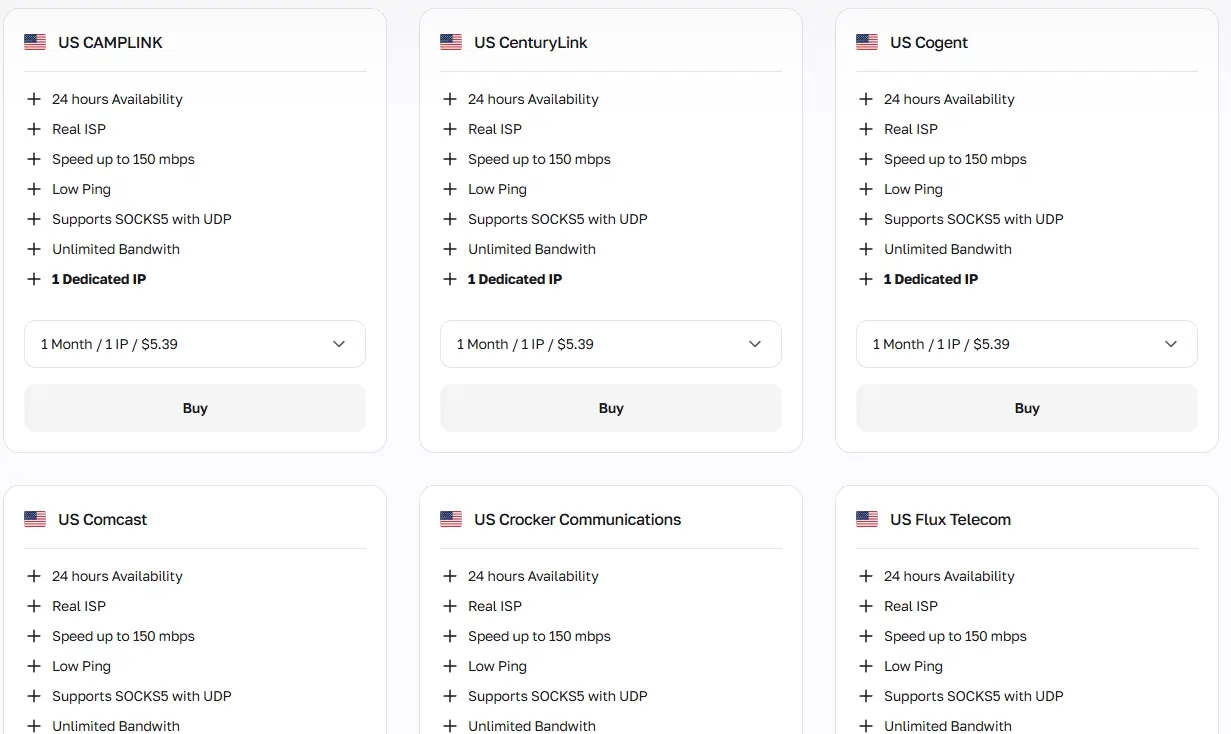
静态住宅代理 提供来自特定国家的固定住宅 IP,被平台视为普通家庭互联网用户。它们非常适合与账户关联的工作流程。
轮换住宅代理 利用覆盖 195 多个国家的 1 亿多个 IP 的基础设施。您可以在每次请求时轮换地址,或维持长达 24 小时的粘性会话。它们构成了批量自动化、大规模网页抓取以及为现代 AI 代理(如 Crawl4AI 和 Open Scraper)提供稳定网络环境的必要基础。
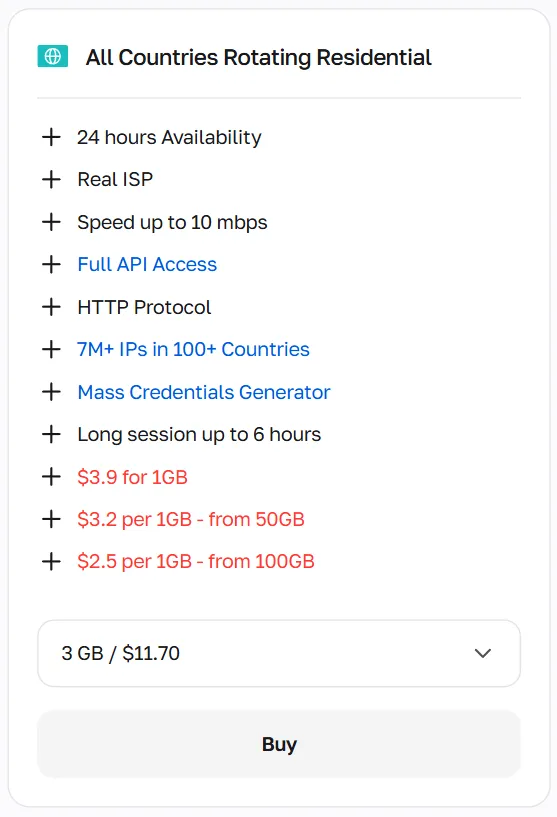
选择静态住宅 IP 用于长期账户管理,采用 1 IP = 1 账户的方案,而轮换 IP 则是所有批量网络活动所必需的,需要根据每个具体使用场景制定适当的 IP 轮换策略。
数据中心代理:开放数据库和应用测试
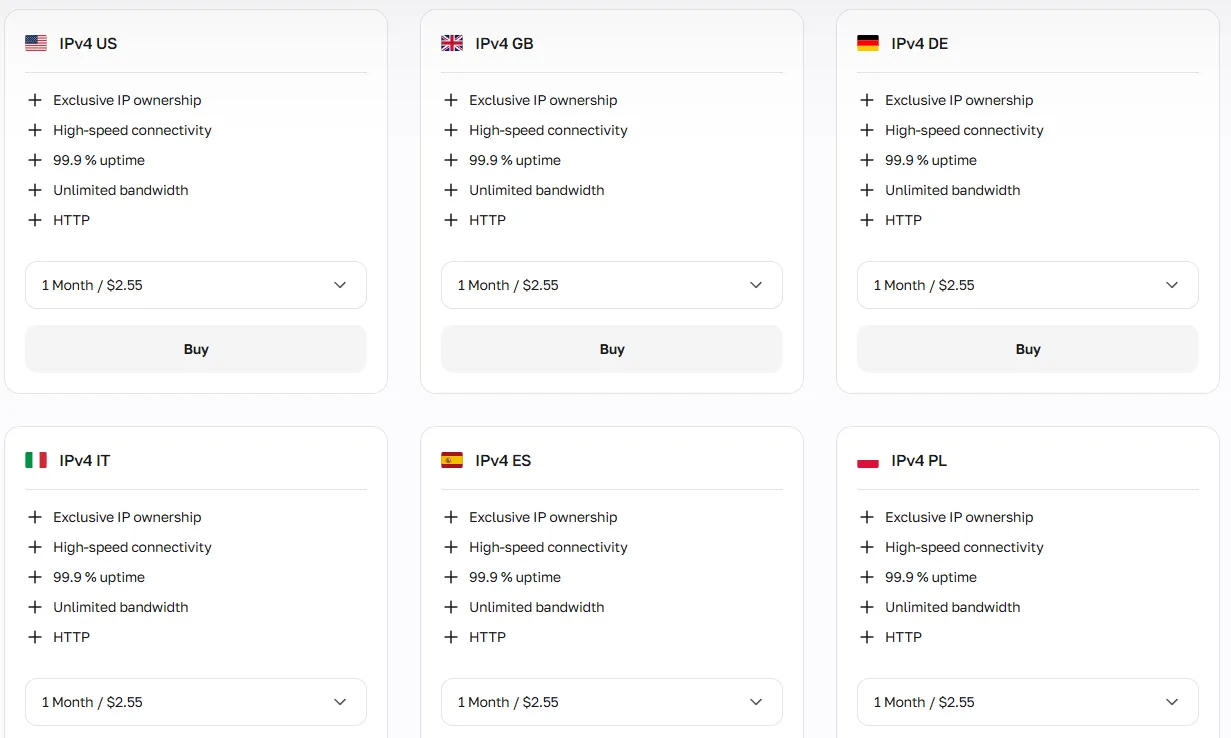
数据中心代理 提供最快的连接速度,但与非住宅、类似机器人的流量相关联。它们适用于抓取开放数据库、测试 API 以及平台应用最少机器人检测的高速任务,但在社交平台(如 Reddit 或 LinkedIn)上可能会被快速限制。
附加工具:执行前风险评估
CyberYozh 提供 IP 检查器,可针对主要欺诈数据库扫描每个 IP 地址,返回严格的欺诈评分和完整历史记录。实施「执行前风险评估」流程。在启动浏览器实例之前,通过检查器运行您的 IP。这可以评估您的实际风险级别,并有助于保持高运营成功率,完全取代虚假的「防封禁」保证。
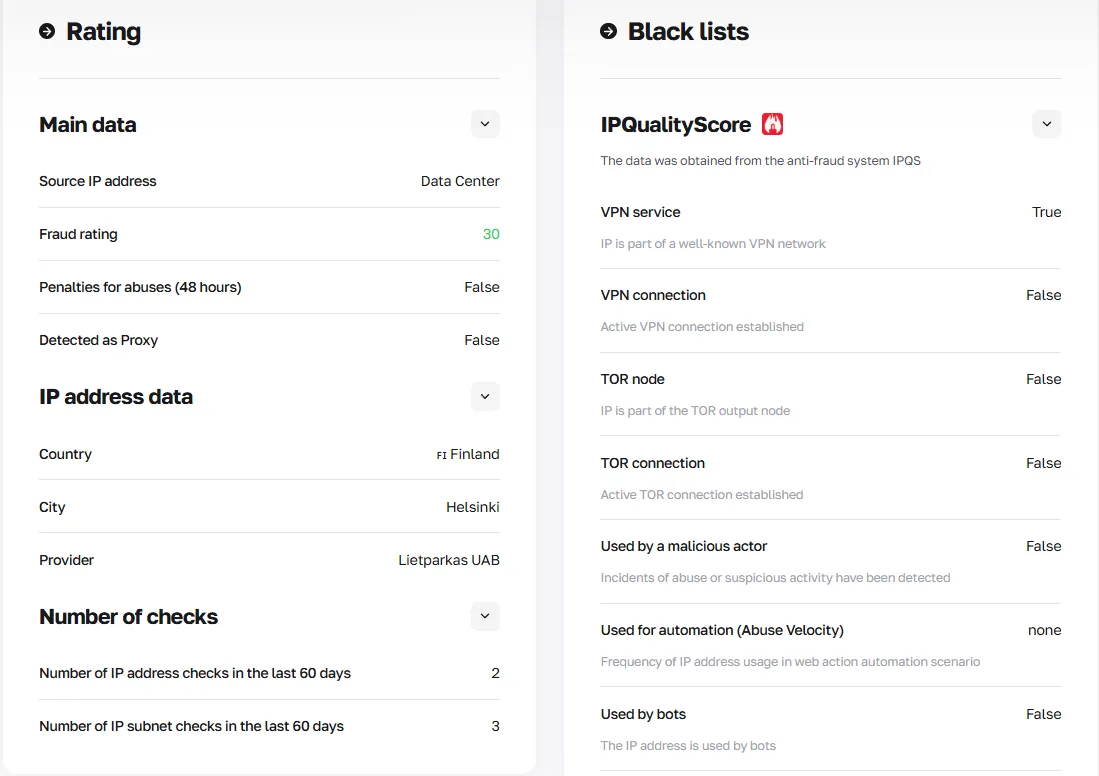
获取 CyberYozh API 访问权限,以自动化 IP 轮换并在轮换前检查每个传入的 IP 地址,确保其质量。
开始 Playwright 安装:选择编程语言
Playwright 支持四种语言。在开始 Playwright 安装和代理配置之前,请选择适合您技术栈的语言。本指南使用 Python,因为它是代理工作流程中最常用的选择,但下表和简短说明涵盖了所有四个选项。
语言 | 主要差异 | 主要用例 | 何时选择 |
Node.js (JS/TS) | 默认 Playwright 语言;原生支持 TypeScript;拥有最大的社区和文档 | 端到端测试、浏览器自动化、前端 CI/CD | 您的团队使用 JS/TS,或您需要最成熟的工具 |
Python | 在爬虫/机器学习中使用最广泛;通过 asyncio 实现异步;与 Requests、Scrapy 集成 | 网页爬取、数据管道、代理自动化、机器学习数据收集 | 您需要大量使用代理的爬取或数据科学集成 |
.NET (C#) | NuGet 分发;强类型,适合企业级 QA | 企业测试自动化、.NET 应用程序 | 您的组织使用 .NET 技术栈 |
Java | Maven/Gradle 分发;JUnit 集成 | Java 企业应用、Android 相关测试 | 您的项目基于 Java 或需要 JVM 生态系统 |
Node.js
默认且文档最完整的 Playwright 语言。原生支持 TypeScript:使用 npm安装 Playwright,无需额外配置。
npm init playwright@latestPython
Playwright 代理任务、爬取和数据自动化的首选语言。需要 Python 3.8+,通常通过 PyPI(pip)安装。
pip install playwright

playwright install
.NET (C#)
作为 NuGet 包分发。需要 PowerShell(pwsh)来运行浏览器安装步骤。
dotnet new console -n PlaywrightDemo

cd PlaywrightDemo

dotnet add package Microsoft.Playwright

dotnet build

pwsh bin/Debug/netX/playwright.ps1 install
Java
作为 Maven(mvn)模块分发。在 Maven 中将依赖项添加到您的 pom.xml,浏览器将在首次编译时自动下载。
<dependency>

  <groupId>com.microsoft.playwright</groupId>

  <artifactId>playwright</artifactId>

  <version>1.59.0</version>

</dependency>
然后运行命令:
mvn compile exec:java -D exec.mainClass="org.example.App"使用 Python 设置 Playwright 代理
在这里,让我们探讨使用 CyberYozh 代理部署通用 Playwright 抓取会话的方法。虽然 Playwright 的默认语言是 Node.js/TypeScript,但我们将在示例中使用 Python,因为 Playwright 与 Python 的组合广泛用于网页自动化、抓取和其他与代理相关的任务。如果您需要使用 TypeScript 或有需要 C# 或 Java 的特定用例,只需查阅相应的 Playwright 文档版本;调整代码非常简单。
Playwright 代理服务器 是一个网络中介,通过不同的 IP 地址转发浏览器的请求。Playwright 在浏览器启动或上下文级别直接传递代理配置,将所有流量路由到指定的服务器。
1. 为您的任务获取代理
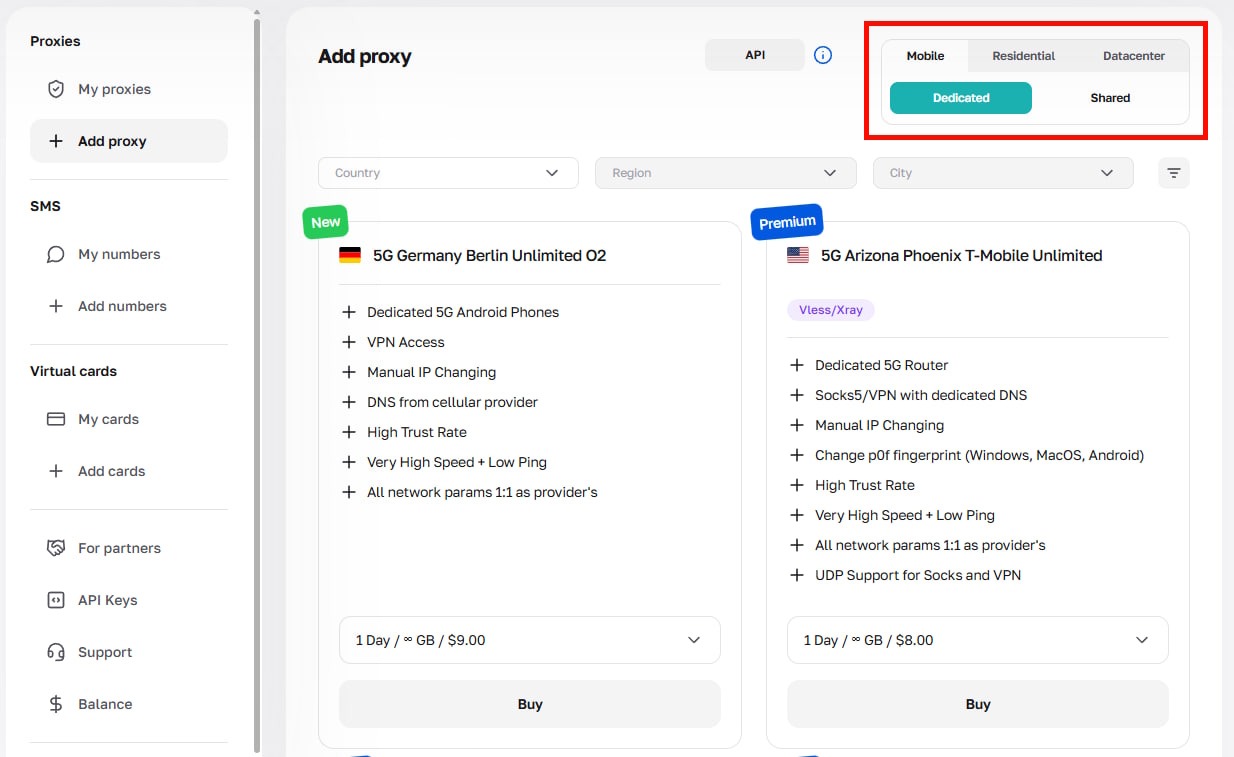
登录您的 CyberYozh 账户,导航至 My Proxies,并选择适合您任务的代理类型(移动代理、静态住宅代理、轮换住宅代理、数据中心代理)。
购买后,打开代理卡片,点击 Generate Credentials,选择您的轮换模式(Random IP、Short Session 或 Long Session),然后找到主机、端口、用户名和密码。
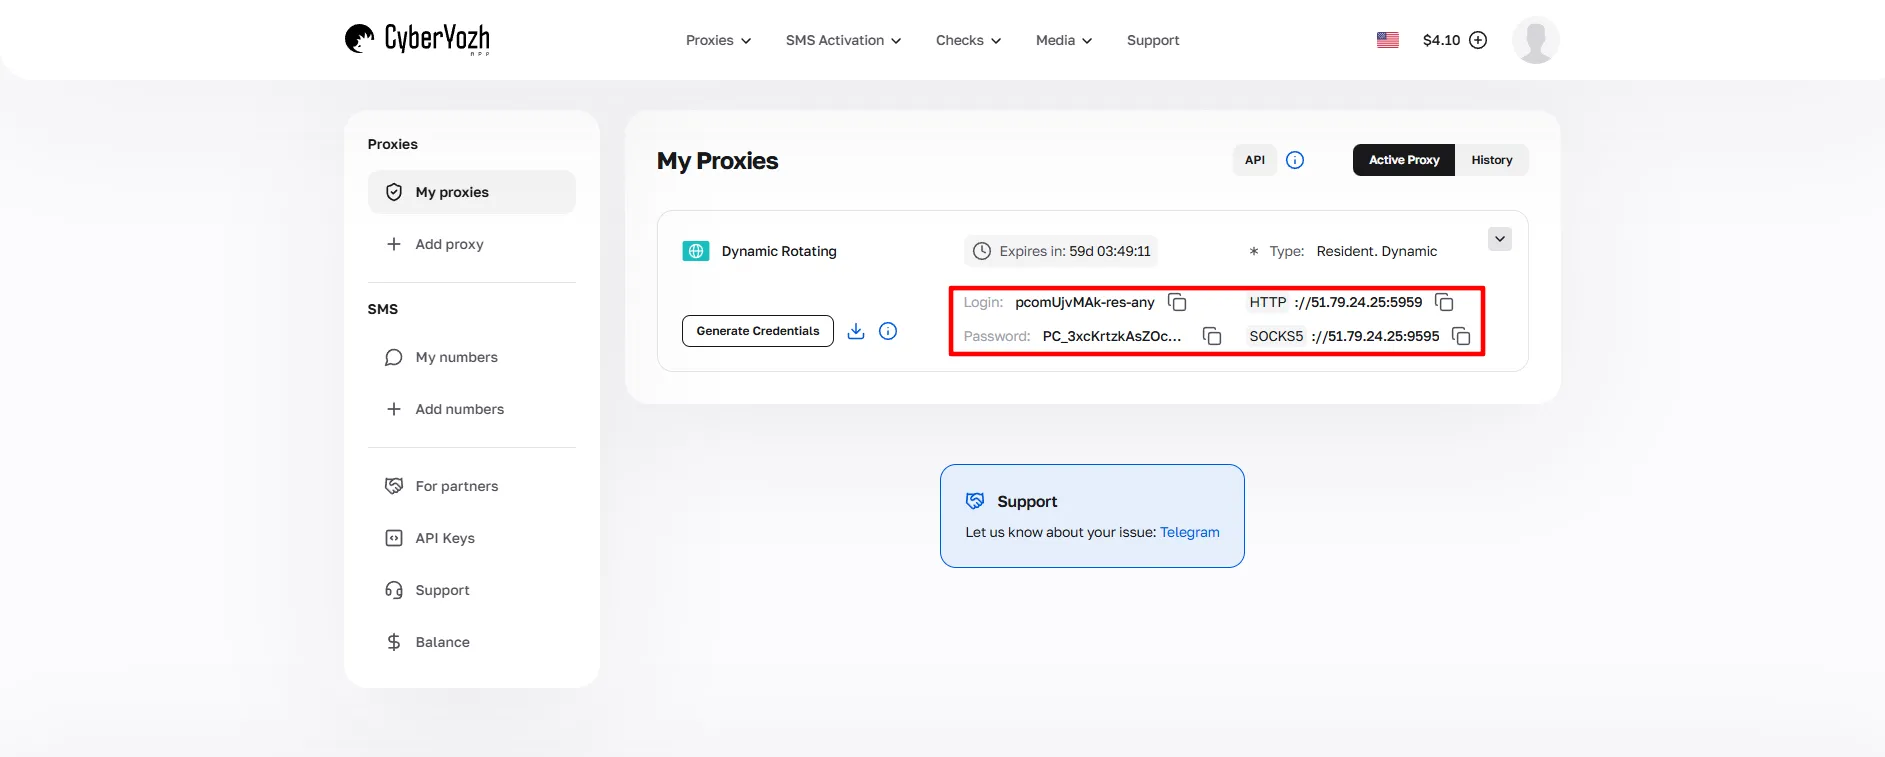
这些凭据将在整个设置过程中使用。
2. 下载并安装 Playwright
通过 PyPI 安装 Playwright 库及其浏览器二进制文件:
pip install playwright

playwright install
这将下载 Chromium、Firefox 和 WebKit 二进制文件。对于抓取任务,Chromium 是标准选择。
3. 组织项目结构
创建一个专用项目文件夹(例如 scraper/)。将凭据与代码分开保存,并为抓取的数据定义清晰的输出路径:
-.env 文档用于存储代理凭据(始终添加到 .gitignore)
-scraper.py 作为主要的 Playwright 脚本
-requirements.txt 用于依赖项
output/ 文件夹用于存储抓取的数据(CSV/JSON)
4. 将代理配置添加到 .env 文件
在 VS Code 或任何编辑器中打开您的 .env 文件,并复制粘贴您的 CyberYozh 凭据。始终将 .env 添加到 .gitignore,以防止凭据泄露到版本控制仓库。
HTTP_PROXY=http://username:password@proxy-server-ip:host
SOCKS5_PROXY=socks5://username:password@proxy-server-ip:host
对于 Playwright SOCKS5 代理配置,使用 socks5:// 方案。对于标准 Playwright HTTP 代理使用,使用 http:// 方案。确保包含 CyberYozh 仪表板中的正确端口。如果您使用 CyberYozh API,您的 API 密钥也必须在此处指定。
CYBERYOZH_API_KEY=Your_API_URL_Key5. 创建抓取/自动化脚本
使用 Playwright 创建 Python 测试文件。它应大致具有以下结构:
使用代理设置创建浏览器和上下文实体
通过 CyberYozh API 设置自动轮换和 IP 检查
访问目标网站并通过 Requests 库执行抓取
设置错误处理
指定抓取数据的输出文件夹
下面的脚本实现了 Python 中完整的 Playwright 代理设置:浏览器实体、带 Playwright 代理认证的上下文实体、通过 CyberYozh API 进行的自动 IP 轮换、请求执行、错误处理和文件输出。
访问 CyberYozh 的 API 文档,了解如何准确部署 API 命令以实现 CyberYozh 服务的自动化使用
import asyncio
import os
import json
import requests
from dotenv import load_dotenv
from playwright.async_api import async_playwright

load_dotenv()

PROXY_URL = os.getenv("HTTP_PROXY")  # or SOCKS5, from the .env document
CYBERYOZH_API_KEY = os.getenv("CYBERYOZH_API_KEY") # API key from the .env document
TARGET_URL = "https://httpbin.org/ip" # the website to scrape; here is the test one
OUTPUT_FILE = "output/results.json" # output folder


def check_ip_quality(ip: str) -> bool:

    """Use CyberYozh IP Checker API to verify trust score before rotating."""

    try:

        response = requests.get(
            f"https://app.cyberyozh.com/api/v1/checkers/socks/",
            headers={"Authorization": f"Bearer {CYBERYOZH_API_KEY}"},
            timeout=5
        )

        score = response.json().get("fraud_score", 100)
        return score < 50  # Accept IPs with fraud score below 50

    except Exception:

        return True  # Allow on API error


async def scrape(proxy_url: str) -> dict:

    """Run a single Playwright scraping session with proxy."""

    # Parse proxy credentials for Playwright proxy authentication

    from urllib.parse import urlparse

    parsed = urlparse(proxy_url)

    proxy_config = {
        "server": f"{parsed.scheme}://{parsed.hostname}:{parsed.port}",
        "username": parsed.username,
        "password": parsed.password,
    }


    async with async_playwright() as p:

        # Browser entity (headless to save traffic): launch with proxy server

        browser = await p.chromium.launch(headless=True)
        # Context entity: proxy settings applied per context

        context = await browser.new_context(proxy=proxy_config)
        page = await context.new_page()


        try:

            await page.goto(TARGET_URL, timeout=30000)
            content = await page.inner_text("body")
            result = json.loads(content)
            return {"status": "ok", "ip": result.get("origin")}

        except Exception as e:

            return {"status": "error", "error": str(e)}

        finally:

            await context.close()
            await browser.close()


async def main():

    results = []

    for i in range(5):

        print(f"Request {i+1}: using proxy {PROXY_URL}")
        data = await scrape(PROXY_URL)
        print(f"  → IP: {data.get('ip')} | Status: {data.get('status')}")
        results.append(data)

    os.makedirs("output", exist_ok=True)

    with open(OUTPUT_FILE, "w") as f:

        json.dump(results, f, indent=2)

    print(f"Results saved to {OUTPUT_FILE}")


asyncio.run(main())另请参阅相关指南: 在 Python 中配置代理轮换。
6. 运行测试并轮换代理
从项目根目录启动抓取器:
python scraper.py验证每个请求记录的 IP 地址都不同(确认轮换处于活动状态),并且 output/results.json 文件已填充。使用 CyberYozh API 进行自动轮换和通过 IP Checker 进行自动质量检查:欺诈分数高的代理将在下一个轮换周期之前被拒绝。
另请参阅: 网页抓取自动化指南
总结:将 Playwright 与 CyberYozh 基础设施结合使用
配置好 Playwright 代理并激活 CyberYozh 凭据后,您可以大规模运行多目标抓取、地理定向自动化和账户管理工作流,通过经过欺诈分数验证的干净住宅或移动 IP 路由每个浏览器会话,同时以您选择的格式输出结构化数据。