Scraper Web Sin Código: Extracción Visual de Datos y Automatización con IA
Extraer datos de mercado se vuelve más difícil cada día. Intentas obtener precios de la competencia o recopilar contactos de leads, pero el servidor objetivo interrumpe tu conexión. Construir scripts de crawling personalizados requiere tiempo de ingeniería y demanda mantenimiento constante. Las plataformas de automatización modernas simplifican la extracción de datos sin código. Si quieres aprender cómo hacer web scraping sin código, las interfaces visuales te permiten extraer información directamente a través de tu navegador. Trasladan el trabajo técnico a la inteligencia artificial.
TL;DR: Cómo extraer datos de un sitio web sin código en menos de cinco minutos
Olvídate de los frágiles scripts de Python y la inspección manual del DOM. Puedes construir un pipeline de datos altamente resiliente ahora mismo:
Selecciona elementos web objetivo con un simple clic del mouse usando una interfaz visual de apuntar y hacer clic.
Deja que la IA integrada repare algoritmos de extracción rotos automáticamente cada vez que cambie el diseño objetivo.
Delega el renderizado pesado de JavaScript y el desplazamiento infinito al motor de navegador nativo Playwright.
Enruta el tráfico a través de redes residenciales rotativas para mantener acceso estable sin activadores anti-bot.
Exporta datos limpios a archivos CSV o envía conjuntos de datos Markdown listos para LLM directamente a tus agentes de IA.
Por qué usar una herramienta visual de web scraping
Las empresas generan volúmenes masivos de datos no estructurados en e-commerce diariamente. Los modelos de lenguaje grandes también requieren entrenamiento continuo con conjuntos de datos actualizados. Esta demanda impulsó el mercado global de web scraping a una valoración de 3.82 mil millones de dólares en 2025, con proyecciones que alcanzan los 11.08 mil millones para 2034. La recopilación de datos solía ser una tarea estrictamente de ingeniería.
Los desarrolladores construían frameworks complejos de automatización de navegadores usando Puppeteer y Playwright. Pero los scripts que dependen de selectores CSS codificados y XPath se rompen inmediatamente cuando los sitios web implementan simples pruebas A/B o actualizan su diseño.
Un web scraper sin código moderno abstrae esta complejidad técnica. Obtienes una interfaz visual de apuntar y hacer clic para mapear algoritmos de extracción instantáneamente. El sistema maneja la paginación y realiza renderizado dinámico de JS automáticamente.
👉 Proxies móviles 4G y 5G: supera límites regionales con redes premium
Caso de usuario real: Seguimiento de precios de e-commerce
Imagina dirigir un negocio competitivo de dropshipping hoy. Necesitas el mejor web scraper sin código para seguimiento de precios de ecommerce. Quieres monitorear el inventario de la competencia en múltiples marketplaces sin problemas.
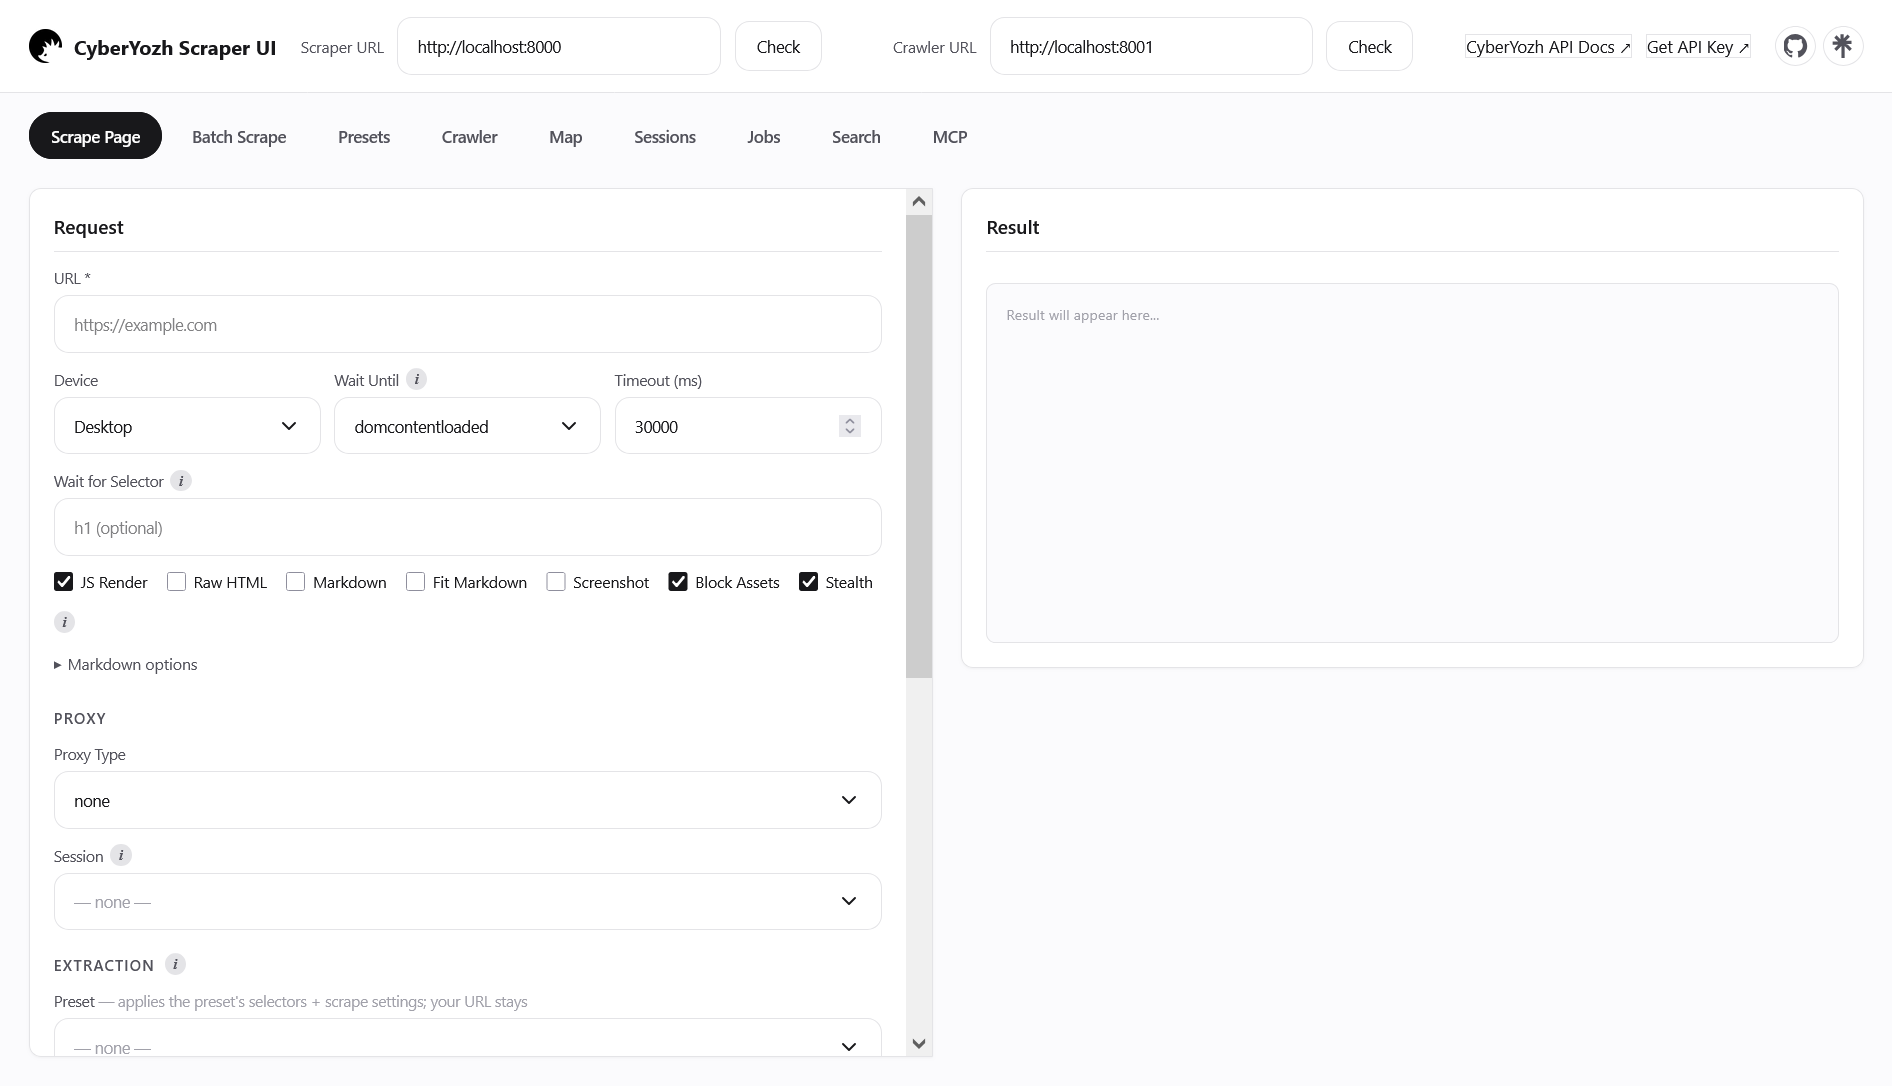
Lanzas tu herramienta visual de web scraping. Ingresas la URL de la categoría objetivo. Haces clic directamente en el título de un producto. Seleccionas la etiqueta de precio. El sistema detecta el patrón recurrente inmediatamente. Mapea la lógica de análisis del DOM por ti. Haces clic en el botón de ejecución.
La configuración automatizada del web scraper sin código procesa la cola. Extrae cientos de elementos en minutos. Finalmente, usas la función de exportación CSV para enviar el JSON estructurado a tu panel de análisis. Este web scraper sin código realiza interacciones naturales del navegador. Hace clic en botones con micro-retrasos aleatorios. Desplaza páginas exactamente como un ser humano real.
Por qué los sitios web restringen las solicitudes automatizadas
Cuando haces scraping de sitios web dinámicos sin codificar, los firewalls empresariales a menudo interrumpen tu conexión. La restricción generalmente ocurre en la capa de transporte durante el TLS Handshake inicial.
Los Web Application Firewalls modernos analizan el paquete ClientHello. El cliente envía este paquete al establecer una conexión protegida. Los algoritmos JA3 y JA4 hashean estos parámetros específicos. Verifican profundamente la versión TLS. Inspeccionan las suites de cifrado compatibles y las curvas elípticas.
Las bibliotecas de red estándar de Python o Node.js generan huellas digitales TLSespecíficas. Estas firmas difieren radicalmente de los navegadores comerciales como Chrome o Safari. Los filtros de tráfico detectan esta anomalía de red inmediatamente. Reinician tu conexión o requieren verificación manual. Por lo tanto, un web scraper sin código confiable debe basarse en un motor de navegador real. Debe alinear las huellas digitales TLS exactamente para mantener acceso estable.
👉 Proxies ISP residenciales: conexiones localizadas estables para extracciones
La base de infraestructura de proxies
Coincidir con las huellas TLS no significa nada sin una dirección IP limpia. Tu web scraper sin código requiere una infraestructura de proxies sólida. El ecosistema CyberYozh App proporciona estas soluciones escalables exactas. La plataforma mantiene una estricta política de cero registros. Ofrece soporte técnico 24/7 y métodos de pago altamente privados.
La infraestructura de enrutamiento profesional se basa en métricas técnicas estrictas. Tu red de proxies debe cumplir con estos criterios exactos para garantizar la recopilación de datos ininterrumpida:
Mejor Precio: Facturación de pago por uso sin tarifas ocultas.
Alta Velocidad: Baja latencia de ping para renderizar aplicaciones de página única pesadas.
IP Limpia: Altas tasas de confianza para eliminar verificaciones anti-bot.
Múltiples GEOs: Segmentación granular hasta códigos postales específicos en más de 195 países.
Transferencia de Tráfico: El ancho de banda no utilizado se transfiere al siguiente período de facturación.
Tasa de Éxito del 99%: El balanceo de carga inteligente garantiza la entrega de solicitudes.
Tiempo de Actividad del 99.99%: Los nodos tolerantes a fallos mantienen activas las tareas de larga duración.
Prueba/Periodo de Prueba Gratuito: Garantías de devolución de dinero para probar la compatibilidad.
Pagos Flexibles: Amplio soporte para tarjetas internacionales y criptomonedas.
Soporte UDP: Manejo nativo de protocolos de transporte modernos.
Formatos de Exportación: Generación rápida de listas de IP (IP:PUERTO:USUARIO:CONTRASEÑA).
Aprobaciones de Servicio: Compatibilidad preverificada con plataformas principales como Amazon o Google.
Soporte Rápido: Ingenieros disponibles 24/7 para resolver incidentes de enrutamiento.
Tipo de red | Característica clave | Escenario de implementación ideal |
Proxies móviles | Máxima tasa de confianza (5G/LTE) | Redes sociales, contenido móvil |
ISP residencial | Dirección estática de proveedor real | Extracción compleja, sesiones largas |
Residencial rotativo | Pool de más de 100M, rotación instantánea | Agregación masiva de precios de marketplaces |
Nodos de datacenter | Ping bajo, 99,99% de uptime | Scraping de API de alta velocidad, métricas SEO |
Los proxies residenciales rotativos ofrecen la mejor base posible para la agregación masiva de datos. Obtienes acceso inmediato a más de 100 millones de direcciones. Solo pagas por el ancho de banda consumido. Puedes configurar fácilmente sesiones persistentes de hasta 24 horas. Esta configuración inteligente garantiza que tu extracción de datos se mezcle perfectamente con el tráfico humano real.
👉 Red residencial rotativa: rotación dinámica de direcciones para scraping
Sesiones gestionadas por servidor y autenticación
Muchas herramientas de extracción fallan completamente al extraer datos detrás de muros de inicio de sesión. Los scripts estándar inician una sesión nueva y limpia en cada solicitud HTTP. Los sistemas de seguridad detectan este comportamiento robótico. Bloquean el perfil de usuario indefinidamente.
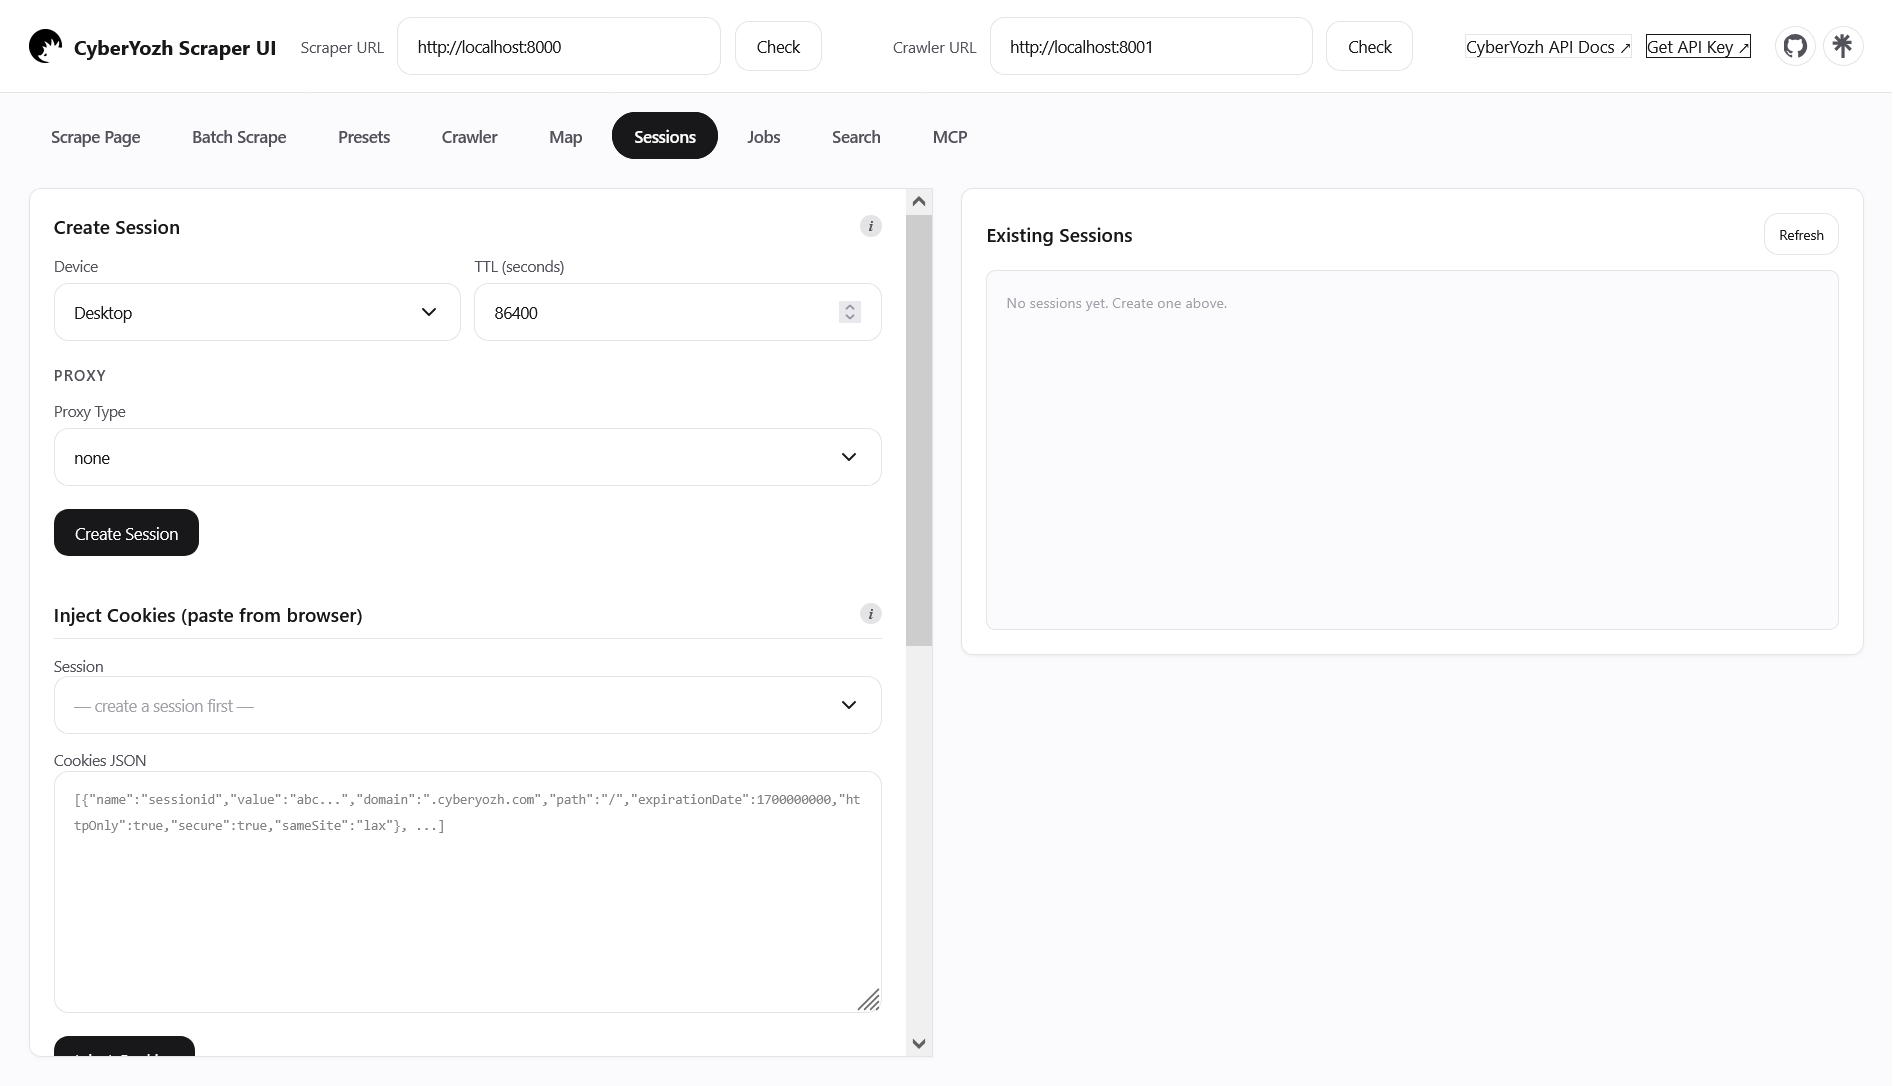
La plataforma Yozh Scraper resuelve esto mediante sesiones gestionadas por servidor. Inyectas cookies de navegador activas directamente en la interfaz visual. El servidor preserva este contexto cuidadosamente. Tu no code web scraper actúa exactamente como un usuario autenticado que regresa. Navega perfiles protegidos sin problemas.
👉 Obtén Yozh Scraper de código abierto en GitHub
Cómo hacer scraping de sitios web dinámicos sin programar usando IA
Yozh Scraper es una plataforma de código abierto que elimina la inspección manual del DOM y los payloads JSON. El backend utiliza un motor de navegador Playwright nativo en el puerto 8000, mientras que el frontend opera como un estudio visual Node.js en el puerto 7000.
Formulas tu solicitud en lenguaje natural. El generador de IA analiza el marcado y crea el esquema de extracción correcto.
La plataforma cuenta con una función de parser de autorreparación por IA. Las plataformas objetivo mutan su HTML constantemente. Un no code web scraper estándar lanza un error fatal cuando un campo devuelve vacío. Yozh Scraper intercepta el flujo de control, lee la estructura HTML sin procesar y extrae los datos faltantes automáticamente. La plataforma también incluye una API de búsqueda sincrónica para analizar resultados de Google, Bing y Yandex al instante, además de un módulo de visualización de sitemap en tiempo real que mapea estructuras de sitios mediante Server-Sent Events.
👉 Proxies de datacenter: velocidad extrema para solicitudes automatizadas de API
Integración MCP y datasets listos para LLM
Los flujos de trabajo de automatización dependen en gran medida de los modelos de lenguaje grandes hoy en día. Las redes neuronales tienen dificultades para procesar código HTML ruidoso de manera eficiente. Alucinan rápidamente. Pierden contexto crítico. Debido a esto, el no code web scraping para datasets markdown de LLM se ha convertido en un estándar principal de la industria.
Yozh Scraper incluye un motor de filtrado de contenido integrado altamente capaz. Elimina bloques de anuncios, paneles de navegación y footers complejos automáticamente. Genera texto limpio en formato Markdown estricto. Estos datos estructurados encajan perfectamente en una ventana de contexto de LLM.
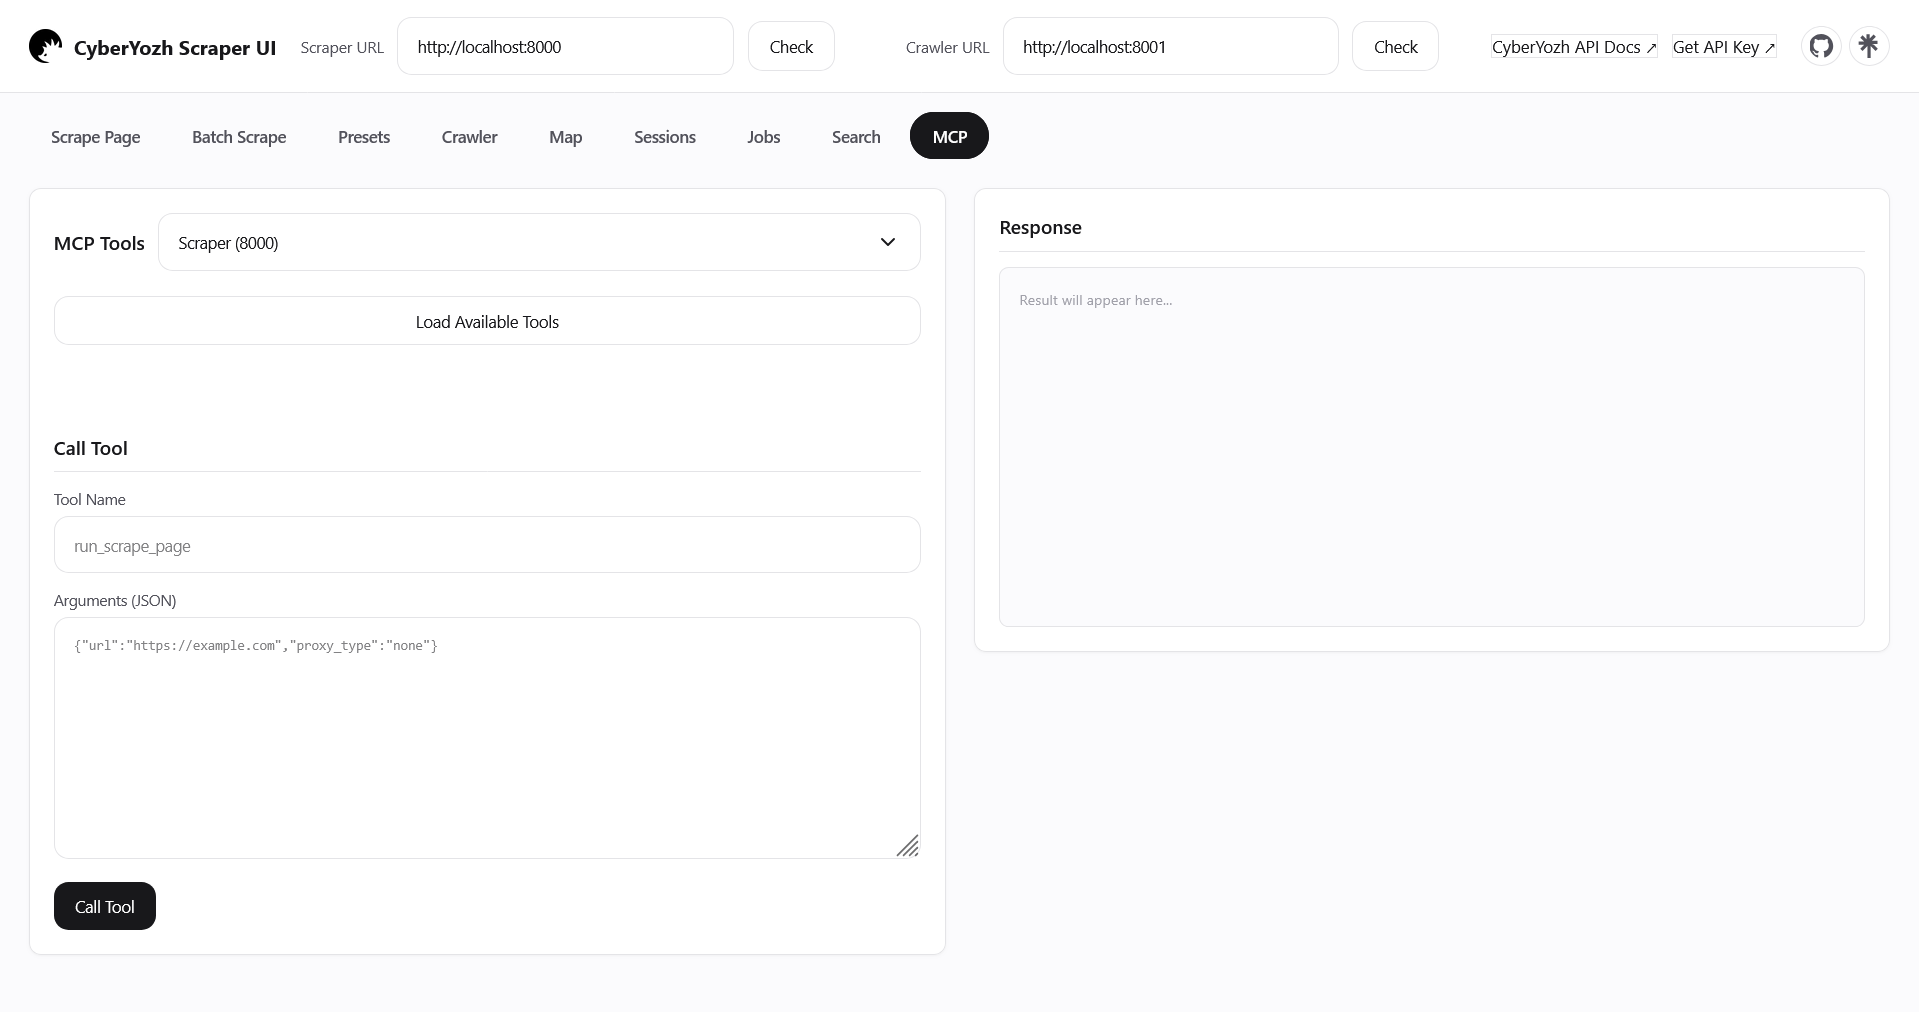
La plataforma proporciona integración nativa con Model Context Protocol (MCP). El backend monta un endpoint MCP a través de Streamable HTTP, exponiendo herramientas como run_scrape_page y create_crawl de forma nativa. Los desarrolladores configuran sus adaptadores de Claude Desktop o LangChain para enviar comandos directamente. El agente planifica tareas de extracción de datos de forma autónoma, llama a Yozh Scraper y analiza los resultados sin requerir ningún código de middleware. El estudio visual cuenta con una pestaña dedicada MCP Inspector para depuración rápida de agentes.
Escenarios prácticos de implementación
Las capacidades de análisis visual abren la puerta a operaciones empresariales complejas.
Inteligencia de Precios de E-commerce. Los vendedores de marketplaces configuran un crawler visual para escaneos de productos cada hora. Los proxies residenciales rotativos te permiten agregar precios entre regiones sin activar sistemas antifraude. Analizas las calificaciones de la competencia sin esfuerzo. Rastreas la dinámica de inventario sin activar sistemas anti-bot.
Generación de Leads B2B. Las herramientas de automatización escanean directorios empresariales continuamente. El software agrega nombres de empresas y números de contacto exactos. Gracias al renderizado de JavaScript, la herramienta extrae datos ocultos detrás de elementos interactivos. Recuperas fácilmente números de teléfono ocultos por botones dinámicos.
Construcción de Datasets para LLM. Los equipos de investigación utilizan funciones de crawler para operaciones de scraping masivo por lotes. Procesan extensos portales de noticias y blogs corporativos. El sistema convierte miles de páginas web en documentos Markdown formateados automáticamente.
Análisis de Bienes Raíces. Las agencias inmobiliarias implementan parsers para monitorear clasificados locales constantemente. Los proxies ISP estáticos simulan el comportamiento de usuarios locales perfectamente. Esta configuración garantiza la recuperación auténtica de datos sin ninguna distorsión de precios regional.
Gestión de identidad y verificación de Fraud Score
Los pipelines de extracción de datos a menudo encuentran muros de verificación inesperadamente. Las plataformas objetivo exigen códigos SMS para continuar. CyberYozh App proporciona números virtuales para más de 700 sitios web globales. Puedes alquilar números de operadores locales reales para superar límites regionales rápidamente.
👉 Números virtuales: registra perfiles usando redes ISP auténticas
También puedes emitir tarjetas virtuales tokenizadas al instante. Estas tarjetas se integran con Apple Pay y Google Pay de forma nativa. Estableces límites de gasto y controlas saldos desde un solo panel. Funcionan perfectamente para suscripciones SaaS y compras de bienes digitales.
👉 Tarjetas bancarias virtuales: financia tus suscripciones SaaS
Antes de lanzar scripts de extracción agresivos, verifica la reputación de tu IP con el Anti-Fraud Checker. Ves claramente tu huella digital a través de los ojos de los firewalls empresariales. ¿Necesitas escalar tus operaciones de datos aún más? Visita CyberYozh Data para más herramientas de scraping y automatización de CyberYozh. Encontrarás soluciones altamente eficientes para cualquier tarea de extracción de datos.
👉 Verificador antifraude: visualiza tu huella digital antes de hacer scraping
Preguntas frecuentes sobre scrapers web sin código
¿Cómo funciona una herramienta de web scraping visual?
Utiliza un motor de navegador backend como Playwright operando en el puerto 8000. Renderiza la página dinámica visualmente. Haces clic en elementos y el sistema genera los selectores CSS requeridos automáticamente.
¿Cómo superar los desafíos de cloudflare con un scraper web sin código?
Debes implementar una herramienta que falsifique perfectamente las huellas TLS. Combínala con proxies móviles o ISP residenciales de alta confianza para evitar CAPTCHAs completamente durante la recolección de datos.
¿Por qué usar un scraper web sin código en lugar de scripts de Python?
Los scripts de Python codificados de forma rígida se rompen inmediatamente cuando los sitios web cambian su diseño. Las herramientas sin código impulsadas por IA utilizan algoritmos de autorreparación para adaptarse a los cambios del DOM automáticamente.
¿Qué es la extracción de datos visual de apuntar y hacer clic?
Es un método simplificado de seleccionar elementos web visualmente. El software traduce tus interacciones en pantalla en un algoritmo de scraping robusto sin necesidad de programación.
¿Puede una plataforma automatizada de web scraper sin código manejar el desplazamiento infinito?
Sí. La plataforma simula el comportamiento de desplazamiento humano natural. Espera pacientemente a que JavaScript renderice nuevos elementos antes de continuar el bucle de extracción.
¿Cómo exporto mis conjuntos de datos listos para LLM?
Puedes descargar tus archivos estructurados directamente mediante exportación CSV. También puedes utilizar integraciones API para enviar cargas JSON directamente a tu base de datos corporativa.