Web Scraper Sem Código: Extração Visual de Dados e Automação com IA
Extrair dados de mercado está ficando mais difícil a cada dia. Você tenta obter preços de concorrentes ou coletar contatos de leads, mas o servidor de destino derruba sua conexão. Construir scripts de crawling personalizados consome tempo de engenharia e exige manutenção constante. Plataformas modernas de automação simplificam a extração de dados sem código. Se você quer aprender como fazer web scraping sem código, interfaces visuais permitem extrair informações diretamente através do seu navegador. Elas transferem o trabalho técnico para a inteligência artificial.
TL;DR: Como extrair dados de um site sem código em menos de cinco minutos
Esqueça os frágeis scripts Python e a inspeção manual de DOM. Você pode construir um pipeline de dados altamente resiliente agora mesmo:
Selecione elementos web de destino com um simples clique do mouse usando uma interface visual de apontar e clicar.
Deixe a IA integrada reparar algoritmos de extração quebrados automaticamente sempre que o layout de destino mudar.
Delegue a renderização pesada de JavaScript e rolagem infinita ao mecanismo de navegador nativo Playwright.
Roteie o tráfego através de redes residenciais rotativas para manter acesso estável sem gatilhos anti-bot.
Exporte dados limpos em arquivos CSV ou envie conjuntos de dados Markdown prontos para LLM diretamente para seus agentes de IA.
Por que usar uma ferramenta visual de web scraping
Empresas geram volumes massivos de dados não estruturados em e-commerce diariamente. Grandes modelos de linguagem também exigem treinamento contínuo em conjuntos de dados atualizados. Essa demanda elevou o mercado global de web scraping para uma avaliação de 3,82 bilhões de dólares em 2025, com projeções atingindo 11,08 bilhões até 2034. A coleta de dados costumava ser uma tarefa estritamente de engenharia.
Desenvolvedores construíam frameworks complexos de automação de navegador usando Puppeteer e Playwright. Mas scripts que dependem de seletores CSS e XPath codificados quebram imediatamente quando sites implementam testes A/B simples ou atualizam seu layout.
Um web scraper sem código moderno abstrai essa complexidade técnica. Você obtém uma interface visual de apontar e clicar para mapear algoritmos de extração instantaneamente. O sistema lida com paginação e executa renderização dinâmica de JS automaticamente.
👉 Proxies móveis 4G e 5G: supere limites regionais com redes premium
Caso de uso real: Rastreamento de preços de e-commerce
Imagine administrar um negócio competitivo de dropshipping hoje. Você precisa do melhor web scraper sem código para rastreamento de preços de e-commerce. Você quer monitorar o inventário de concorrentes em múltiplos marketplaces perfeitamente.
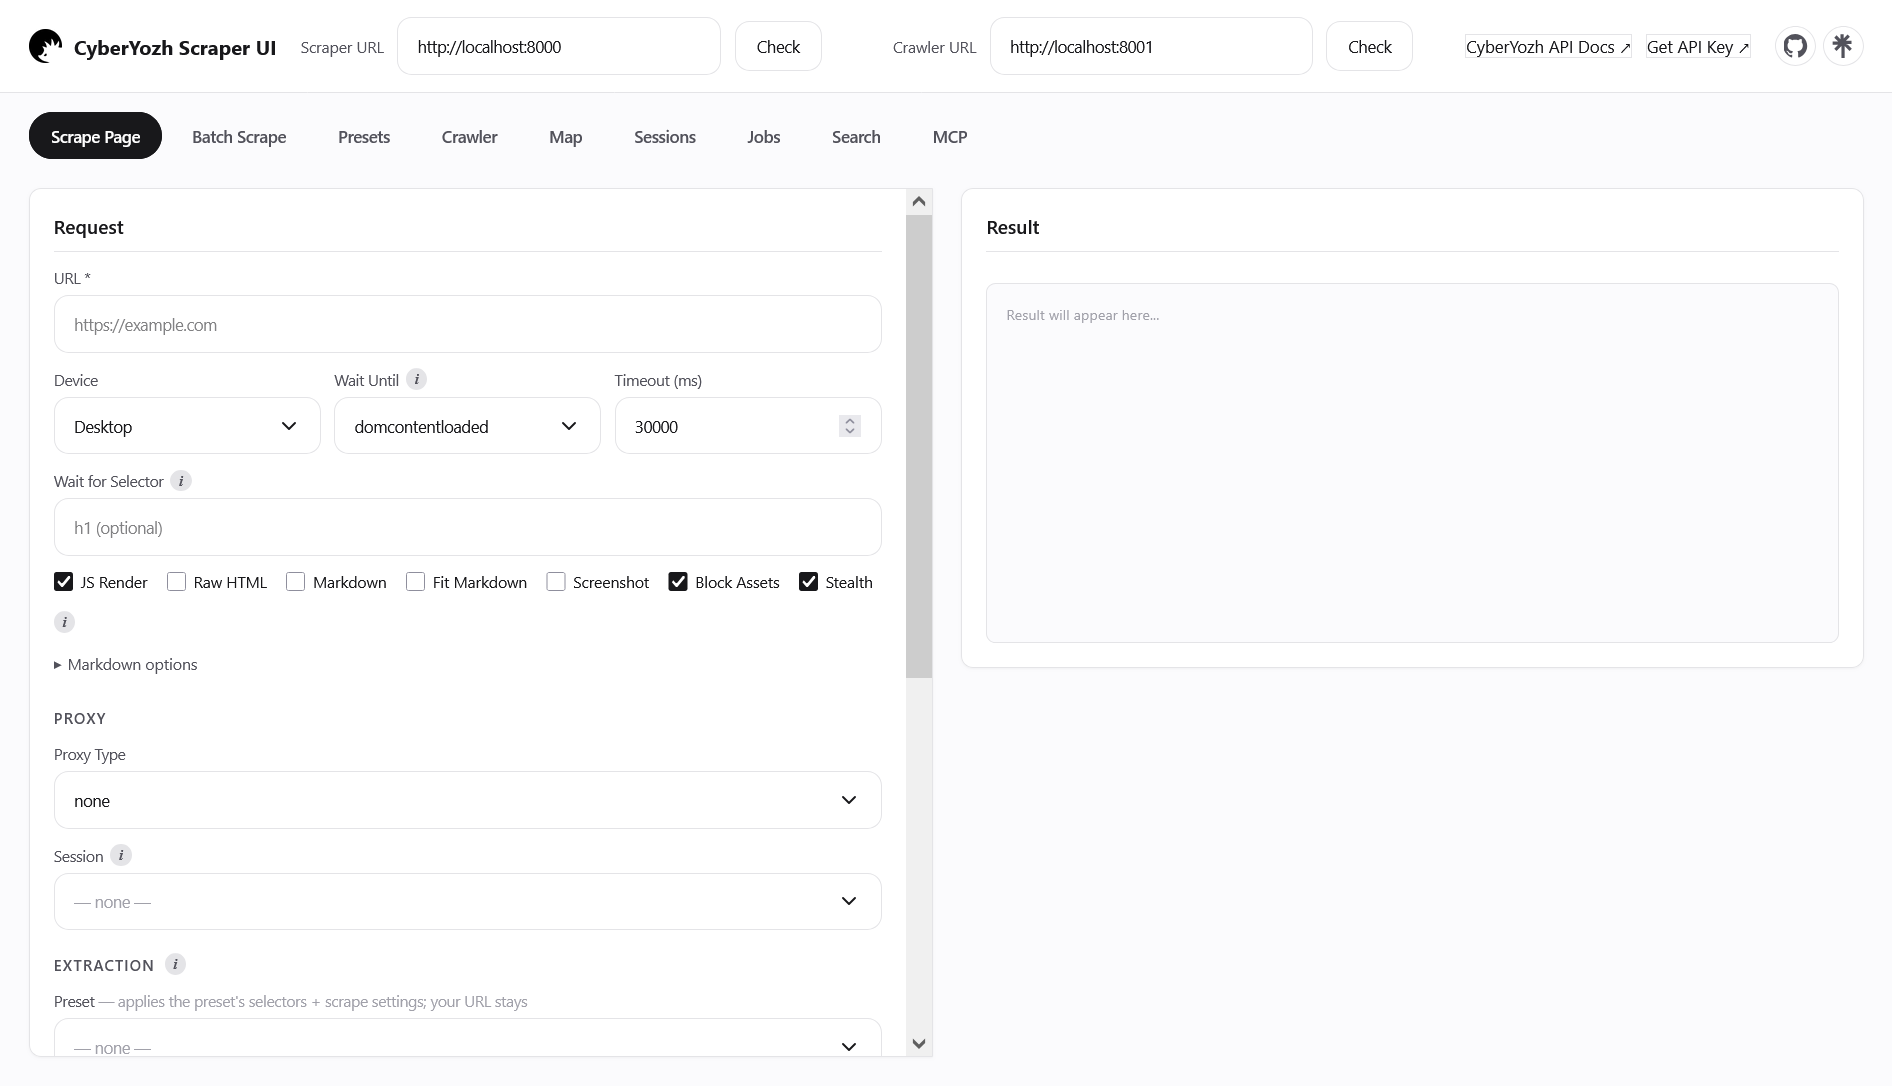
Você inicia sua ferramenta visual de web scraping. Você insere a URL da categoria de destino. Você clica diretamente em um título de produto. Você seleciona a etiqueta de preço. O sistema detecta o padrão recorrente imediatamente. Ele mapeia a lógica de análise do DOM para você. Você clica no botão executar.
A configuração automatizada do web scraper sem código processa a fila. Ele extrai centenas de itens em minutos. Finalmente, você usa o recurso de exportação CSV para enviar o JSON estruturado para seu painel de análise. Este web scraper sem código executa interações naturais de navegador. Ele clica em botões com micro-atrasos aleatórios. Ele rola páginas exatamente como um ser humano real.
Por que sites restringem requisições automatizadas
Quando você faz scraping de sites dinâmicos sem codificação, firewalls corporativos frequentemente derrubam sua conexão. A restrição geralmente acontece na camada de transporte durante o TLS Handshake inicial.
Firewalls de Aplicação Web modernos analisam o pacote ClientHello. O cliente envia este pacote ao estabelecer uma conexão protegida. Algoritmos JA3 e JA4 fazem hash desses parâmetros específicos. Eles verificam profundamente a versão TLS. Eles inspecionam as suítes de cifras suportadas e curvas elípticas.
Bibliotecas de rede padrão Python ou Node.js geram impressões digitais TLSespecíficas. Essas assinaturas diferem radicalmente de navegadores comerciais como Chrome ou Safari. Filtros de tráfego detectam essa anomalia de rede imediatamente. Eles resetam sua conexão ou exigem verificação manual. Portanto, um web scraper sem código confiável deve se basear em um mecanismo de navegador real. Ele deve alinhar as impressões digitais TLS exatamente para manter acesso estável.
👉 Proxies ISP residenciais: conexões localizadas estáveis para extração
A base da infraestrutura de proxy
Corresponder fingerprints TLS não significa nada sem um endereço IP limpo. Seu web scraper sem código requer uma infraestrutura de proxy sólida. O ecossistema CyberYozh App fornece exatamente essas soluções escaláveis. A plataforma mantém uma política rigorosa de zero logs. Oferece suporte técnico 24/7 e métodos de pagamento altamente privados.
A infraestrutura de roteamento profissional depende de métricas técnicas rigorosas. Sua rede de proxy deve atender a esses critérios exatos para garantir a coleta de dados ininterrupta:
Melhor Preço: Cobrança pay-as-you-go sem taxas ocultas.
Alta Velocidade: Baixa latência de ping para renderização de Single-Page Applications pesadas.
IP Limpo: Altas taxas de confiança para eliminar verificações anti-bot.
Muitas GEOs: Segmentação granular até códigos postais específicos em mais de 195 países.
Rollover de Tráfego: Largura de banda não utilizada é transferida para o próximo período de cobrança.
Taxa de Sucesso de 99%: Balanceamento de carga inteligente garante a entrega de requisições.
Uptime de 99,99%: Nós tolerantes a falhas mantêm tarefas de longa duração ativas.
Teste/Trial Gratuito: Garantias de reembolso para testar compatibilidade.
Pagamentos Flexíveis: Amplo suporte para cartões internacionais e criptomoedas.
Suporte UDP: Tratamento nativo de protocolos de transporte modernos.
Formatos de Exportação: Geração rápida de lista de IPs (IP:PORT:USER:PASS).
Aprovações de Serviço: Compatibilidade pré-verificada com plataformas importantes como Amazon ou Google.
Suporte Rápido: Engenheiros disponíveis 24/7 para resolver incidentes de roteamento.
Tipo de Rede | Característica Principal | Cenário de Implementação Ideal |
Proxies Móveis | Taxa Máxima de Confiança (5G/LTE) | Redes sociais, conteúdo móvel |
ISP Residencial | Endereço estático de provedor real | Extração complexa, sessões longas |
Residencial Rotativo | Pool de 100M+, rotação instantânea | Agregação massiva de preços de marketplaces |
Nós de Datacenter | Baixa latência, 99,99% de uptime | Scraping de API de alta velocidade, métricas de SEO |
Proxies residenciais rotativos oferecem a melhor base possível para agregação massiva de dados. Você obtém acesso imediato a mais de 100 milhões de endereços. Você paga apenas pela largura de banda consumida. Você pode configurar facilmente sessões persistentes com duração de até 24 horas. Essa configuração inteligente garante que sua extração de dados se misture perfeitamente com o tráfego humano real.
👉 Rede residencial rotativa: rotação dinâmica de endereços para scraping
Sessões gerenciadas por servidor e autenticação
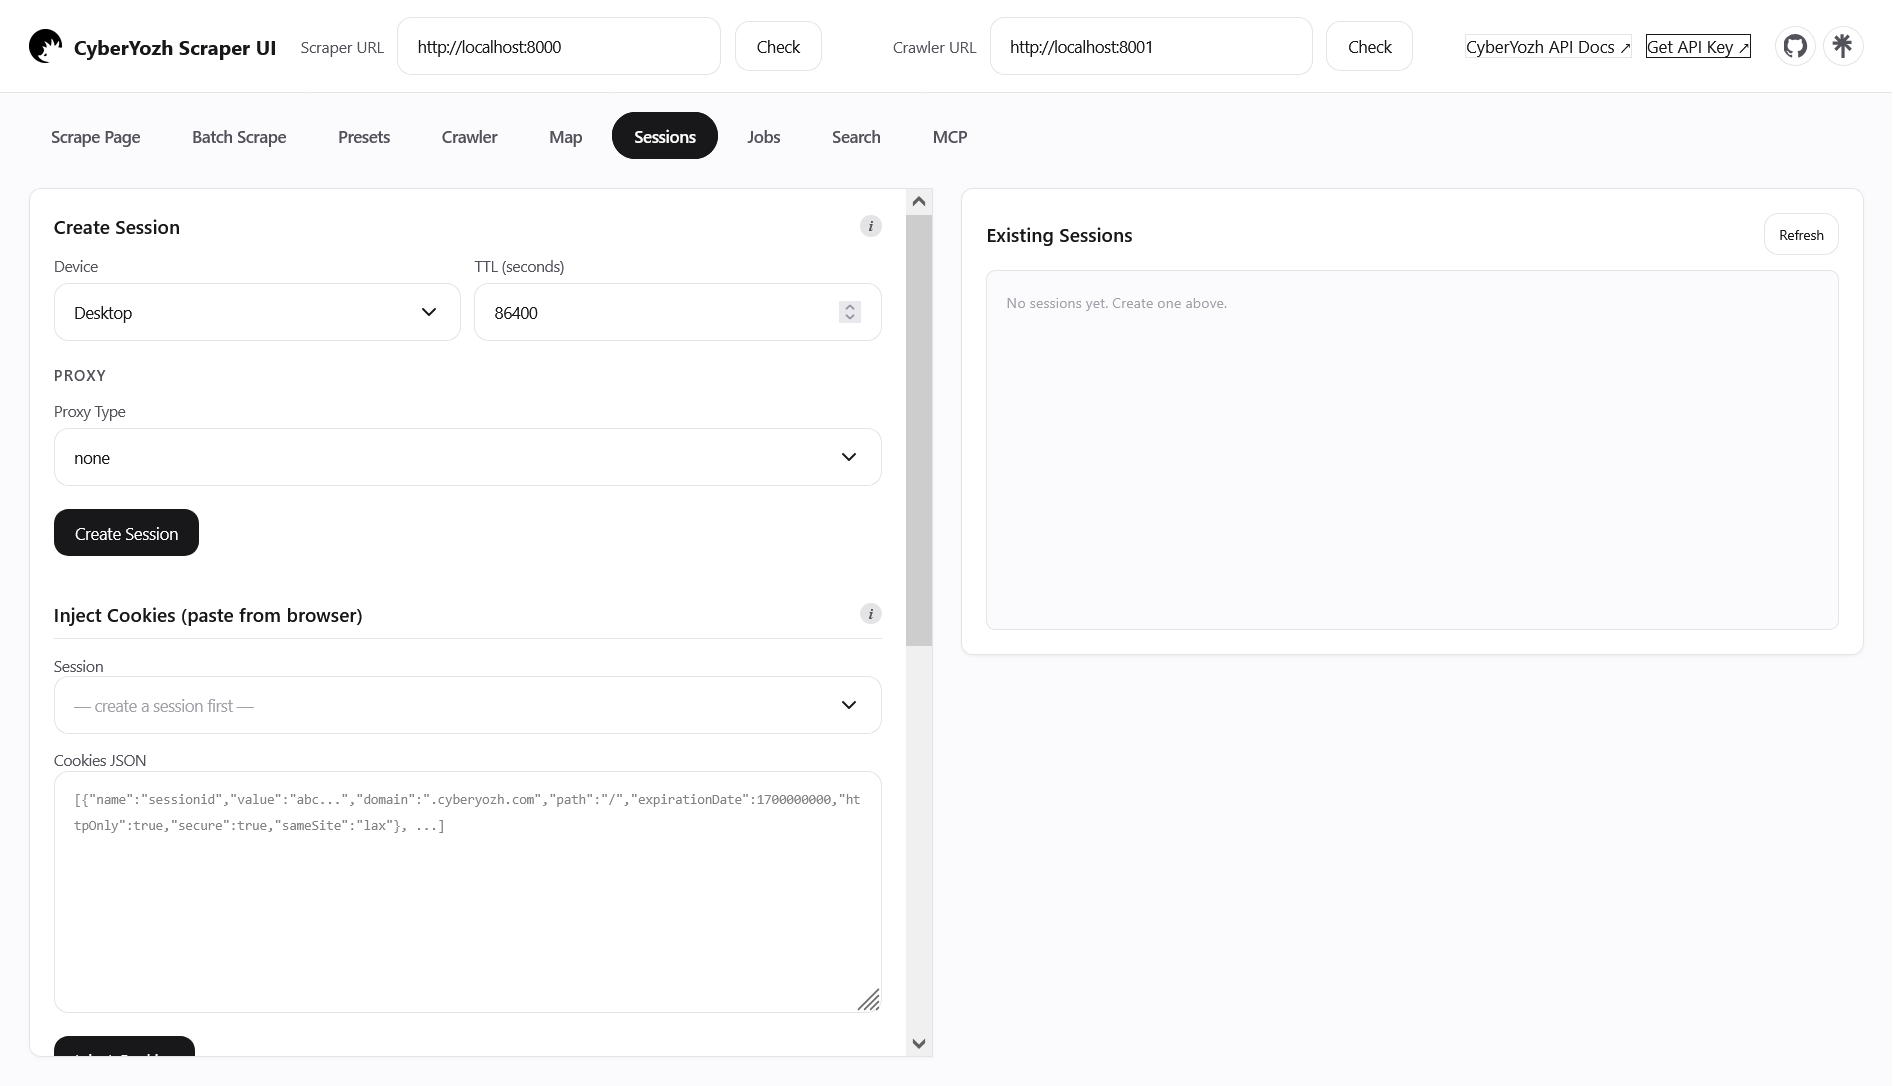
Muitas ferramentas de extração falham completamente ao extrair dados protegidos por paredes de login. Scripts padrão iniciam uma sessão nova e limpa em cada requisição HTTP. Sistemas de segurança detectam esse comportamento robótico. Eles bloqueiam o perfil do usuário indefinidamente.
A plataforma Yozh Scraper resolve isso através de sessões gerenciadas por servidor. Você injeta cookies de navegador ativos diretamente na interface visual. O servidor preserva esse contexto cuidadosamente. Seu web scraper no code age exatamente como um usuário autenticado e recorrente. Ele navega perfis protegidos suavemente.
👉 Obtenha o Yozh Scraper open-source no GitHub
Como fazer scraping de sites dinâmicos sem programar usando IA
Yozh Scraper é uma plataforma open-source que elimina a inspeção manual de DOM e payloads JSON. O backend utiliza um motor de navegador Playwright nativo na porta 8000, enquanto o frontend opera como um estúdio visual Node.js na porta 7000.
Você formula sua solicitação em linguagem natural. O gerador de IA analisa a marcação e cria o schema de extração correto.
A plataforma possui uma função de parser com autocorreção por IA. Plataformas-alvo modificam seu HTML constantemente. Um web scraper no code padrão gera um erro fatal quando um campo retorna vazio. O Yozh Scraper intercepta o fluxo de controle, lê a estrutura HTML bruta e extrai os dados ausentes automaticamente. A plataforma também inclui uma API de Busca síncrona para analisar resultados do Google, Bing e Yandex instantaneamente, além de um módulo de visualização de sitemap em tempo real que mapeia estruturas de sites via Server-Sent Events.
👉 Proxies de datacenter: velocidade extrema para requisições automatizadas de API
Integração MCP e datasets prontos para LLM
Fluxos de trabalho de automação dependem fortemente de modelos de linguagem grandes hoje. Redes neurais têm dificuldade em processar código HTML ruidoso de forma eficiente. Elas alucinam rapidamente. Elas perdem contexto crítico. Por isso, web scraping no code para datasets markdown de LLM tornou-se um padrão primário da indústria.
Yozh Scraper inclui um motor de filtragem de conteúdo integrado altamente capaz. Ele remove blocos de anúncios, painéis de navegação e rodapés complexos automaticamente. Ele gera texto limpo em formato Markdown estrito. Esses dados estruturados se encaixam perfeitamente em uma janela de contexto de LLM.
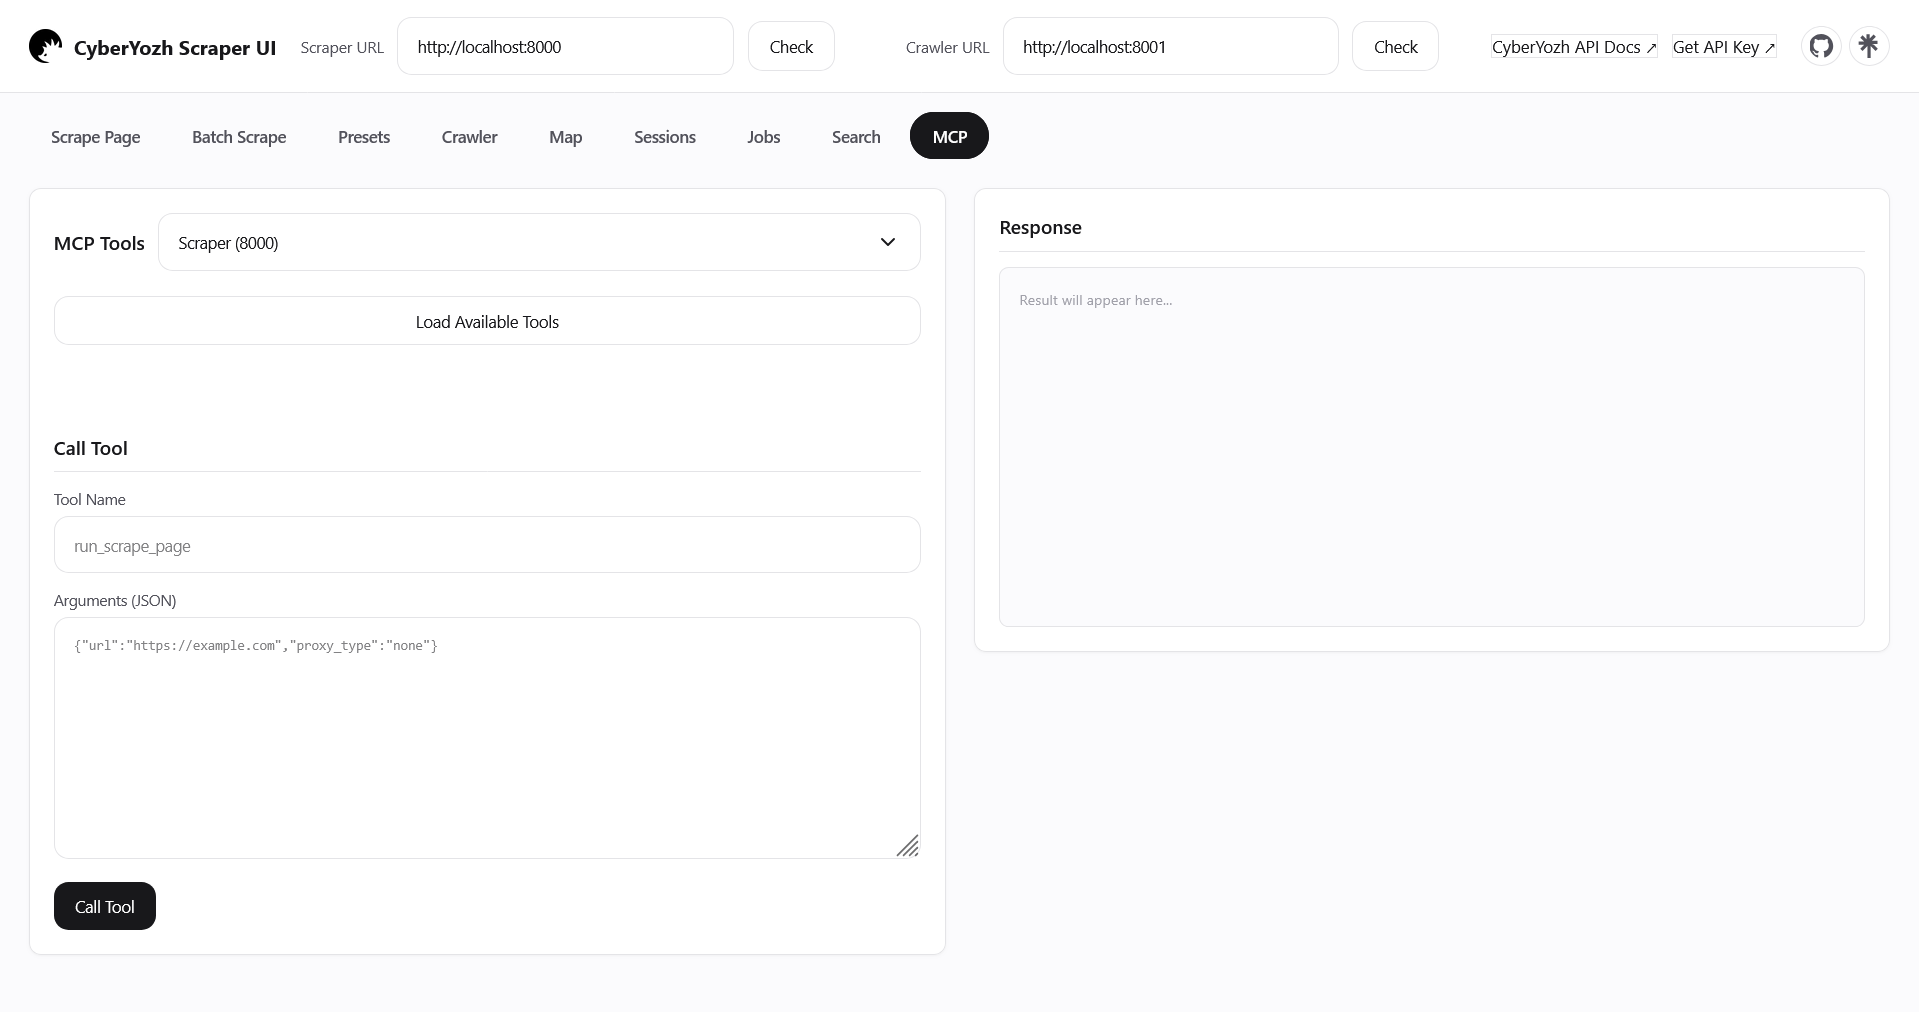
A plataforma fornece integração nativa com o Model Context Protocol (MCP). O backend monta um endpoint MCP via Streamable HTTP, expondo ferramentas como run_scrape_page e create_crawl nativamente. Os desenvolvedores configuram seus adaptadores Claude Desktop ou LangChain para enviar comandos diretamente. O agente planeja tarefas de extração de dados de forma autônoma, chama o Yozh Scraper e analisa os resultados sem exigir nenhum código de middleware. O estúdio visual possui uma aba dedicada MCP Inspector para depuração rápida de agentes.
Cenários práticos de implantação
As capacidades de análise visual abrem portas para operações comerciais complexas.
Inteligência de Preços de E-commerce. Vendedores de marketplaces configuram um crawler visual para varreduras horárias de produtos. Proxies residenciais rotativos permitem agregar preços entre regiões sem acionar sistemas antifraude. Você analisa avaliações de concorrentes sem esforço. Você rastreia a dinâmica de inventário sem acionar sistemas anti-bot.
Geração de Leads B2B. Ferramentas de automação varrem diretórios de empresas continuamente. O software agrega nomes de empresas e números de contato exatos. Graças à renderização JavaScript, a ferramenta extrai dados ocultos atrás de elementos interativos. Você recupera facilmente números de telefone ocultos por botões dinâmicos.
Construção de Datasets LLM. Equipes de pesquisa usam funções de crawler para operações pesadas de scraping em lote. Eles processam extensos portais de notícias e blogs corporativos. O sistema converte milhares de páginas web em documentos Markdown formatados automaticamente.
Análise de Imóveis. Agências imobiliárias implantam parsers para monitorar classificados locais constantemente. Proxies ISP estáticos simulam o comportamento de usuários locais perfeitamente. Esta configuração garante recuperação autêntica de dados sem distorções regionais de preços.
Gerenciamento de identidade e verificação de Fraud Score
Pipelines de extração de dados frequentemente encontram barreiras de verificação inesperadamente. Plataformas-alvo exigem códigos SMS para prosseguir. O CyberYozh App fornece números virtuais para mais de 700 sites globais. Você pode alugar números de operadoras locais reais para superar limites regionais rapidamente.
👉 Números virtuais: registre perfis usando redes ISP autênticas
Você também pode emitir cartões virtuais tokenizados instantaneamente. Esses cartões se integram com Apple Pay e Google Pay nativamente. Você define limites de gastos e controla saldos a partir de um único painel. Eles funcionam perfeitamente para assinaturas SaaS e compras de produtos digitais.
👉 Cartões bancários virtuais: financie suas assinaturas SaaS
Antes de lançar scripts de extração agressivos, verifique a reputação do seu IP com o Anti-Fraud Checker. Você vê claramente sua pegada digital através dos olhos de firewalls corporativos. Precisa escalar suas operações de dados ainda mais? Visite o CyberYozh Data para mais ferramentas de scraping e automação do CyberYozh. Você encontrará soluções altamente eficientes para qualquer tarefa de extração de dados.
👉 Verificador antifraude: visualize sua pegada digital antes de fazer scraping
Perguntas frequentes sobre web scrapers sem código
Como funciona uma ferramenta de web scraping visual?
Ela utiliza um motor de navegador backend como o Playwright operando na porta 8000. Ela renderiza a página dinâmica visualmente. Você clica nos elementos e o sistema gera os seletores CSS necessários automaticamente.
Como superar os desafios de web scraper sem código com Cloudflare?
Você deve implantar uma ferramenta que falsifique perfeitamente as impressões digitais TLS. Combine-a com proxies móveis ou ISP residenciais de alta confiança para evitar CAPTCHAs completamente durante a coleta de dados.
Por que usar um web scraper sem código em vez de scripts Python?
Scripts Python com código fixo quebram imediatamente quando sites mudam seu layout. Ferramentas sem código alimentadas por IA utilizam algoritmos de autocorreção para se adaptar a mudanças no DOM automaticamente.
O que é extração de dados visual por apontar e clicar?
É um método simplificado de selecionar elementos web visualmente. O software traduz suas interações na tela em um algoritmo de scraping robusto sem qualquer programação necessária.
Uma plataforma automatizada de web scraper no code consegue lidar com rolagem infinita?
Sim. A plataforma simula o comportamento natural de rolagem humana. Ela aguarda pacientemente o JavaScript renderizar novos itens antes de continuar o loop de extração.
Como faço para exportar meus datasets prontos para LLM?
Você pode baixar seus arquivos estruturados diretamente via exportação CSV. Você também pode utilizar integrações de API para enviar payloads JSON diretamente para seu banco de dados corporativo.